人工智能
在 AWS 上构建超低延迟语音 AI 应用对话式 AI 正在改变人类与技术交互的方式。从虚拟助手、AI 驱动的联络中心,到实时翻译和无障碍工具,语音优先的界面正迅速成为全球数百万用户默认的交互方式。
然而,提供真正自然的语音体验仍然是 AI 基础设施中最艰巨的挑战之一。用户期望获得类人的响应速度。过高的延迟会打断对话的流畅性并侵蚀信任。为了让人感觉自然,AI 生成的语音必须在与人类轮流发言相同的时间窗口内到达。
本文介绍 Cartesia, 一家专注于实时语音 AI 的 AWS 合作伙伴,如何利用专门构建的状态空间模型(SSM)和 AWS 基础设施,在全球范围内提供低于 100 毫秒的文本转语音和语音转文本服务。开发者可以构建与人类对话难以区分的语音体验。
对话式 AI 的兴起与延迟预期
各行业对实时语音 AI 的需求正在快速增长:
- 联络中心: 处理数百万客户交互的 AI 代理需要即时语音生成,以维持自然的对话。
- 远程医疗: 远程患者问诊需要低延迟语音,以实现准确、富有同理心的沟通。
- 游戏与虚拟世界: 沉浸式体验需要为非玩家角色(NPC)和玩家交互提供实时语音合成。
- 无障碍: 屏幕阅读器和语音界面必须即时响应,以服务视障用户。
- 呼入和呼出销售: AI 销售代理必须毫无尴尬停顿地响应,以筛选潜在客户、处理异议并留住潜在客户。
传统的基于 Transformer 的文本转语音(TTS)模型在流式延迟方面表现不佳,因为它们需要处理整个序列后才产生输出。这种架构限制造成了一个根本性矛盾:更高质量往往意味着更高延迟。一类新的模型——状态空间模型——解决了这一权衡问题。
语音 AI:状态空间模型(SSM)
状态空间模型(SSM)处理序列的方式与 Transformer(当今大多数 AI 背后的架构)有着根本不同。Transformer 使用一种称为注意力的机制,将序列中的每个元素与其他所有元素进行比较。因此,随着序列变长,计算量呈二次方增长。SSM 则将序列视为一个随时间连续演化的系统,逐步处理并携带一个紧凑的内部状态向前推进。这可以转换为计算机高效处理的形式,从而在某些长序列上保持低成本。这种效率使 SSM 非常适合实时流式数据,如实时语音。
SSM 在音频处理方面的关键优势包括:
- 高质量的长程依赖:结构化 SSM 是一种线性递归形式,但其状态参数化能够在长音频序列上保留信息,避免了限制经典循环神经网络(RNN)(如长短期记忆(LSTM)网络)的长程信号衰减。
- 恒定内存占用:与缓存所有先前 token 的 Transformer 不同,SSM 维护固定大小的隐藏状态。
- 原生流式支持:递归结构逐 token 处理输入,因此无需架构修改即可支持真正的流式处理。
这些特性使 SSM 特别适合质量和延迟都不可妥协的实时语音应用。
工作原理:用于实时语音的 SSM
Cartesia 将这些 SSM 优势应用于两个生产级语音模型:用于语音生成的 Sonic 和用于转录的 Ink。
Cartesia 简介
Cartesia 是一家实时多模态智能公司,构建了基于状态空间模型架构专门打造的语音 AI 应用。Cartesia 由开创 SSM 进展的研究人员创立,其应用专为人类感知边缘的流式推理而设计。
该应用具有两个核心模型:用于文本转语音的 Sonic 和用于语音转文本的 Ink,两者均针对低于 100 毫秒的首字节延迟进行了优化,同时保持录音室级输出质量。
Sonic(文本转语音)
Sonic 是 Cartesia 的旗舰流式文本转语音模型,以低于 100 毫秒的延迟提供超逼真的语音合成:
- 首音频字节约 90 毫秒: 用户几乎即时听到语音响应。
- 超逼真语音质量: 在超过 44 种语言中呈现自然的韵律、情感和表现力。
- 极少数据的声音克隆: 从 10 秒音频样本创建听起来自然的自定义声音。
- 流式原生架构: 在收到完整文本输入之前就开始生成音频。
- 上下文感知合成: 在长段落中保持一致的语气和风格。
Sonic 推荐给希望以最少运维开销实现最快投产时间的团队。调用 API 即可实时接收流式音频。
Ink(语音转文本)
Ink 是 Cartesia 的流式语音转文本模型,专为对话式 AI 应用打造:
- 原生轮次检测: 自动识别说话者何时结束其轮次,无需单独的语音活动检测(VAD)或端点检测模型即可消除尴尬停顿。
- 上下文感知端点检测: 利用语义理解区分句子中间的停顿和真正的对话边界。
- 流式转录: 在用户说话时实时输出部分转录,使下游大语言模型(LLM)能够在轮次结束前开始形成响应。
- 噪声鲁棒性: 在真实部署中常见的嘈杂环境中保持准确性。
- 多说话人支持: 优雅地处理重叠语音和说话人切换。
Sonic 和 Ink 共同提供了构建类人对话代理所需的完整语音 AI 技术栈。
在 AWS 上部署 Cartesia
如果你需要数据主权、延迟控制或合规性,可以将 Cartesia 模型直接部署到你自己的 AWS 账户中。Sonic 通过 AWS Marketplace 以 Amazon SageMaker AI 模型包的形式交付,你将其部署到完全运行在你自己的虚拟私有云(VPC)内的 SageMaker AI 端点。推理数据不会离开你的账户。
本节中的部署模式涵盖 Sonic。Ink 目前可通过 Cartesia API 使用,你可以通过 AWS Marketplace 中的 Cartesia Voice AI Platform 商品列表购买。Sonic 有两种主要部署模式。
方案 1:Amazon SageMaker AI(AWS Marketplace 模型包)
在 Amazon SageMaker AI 上部署是获得托管、VPC 内 Sonic 端点的最快途径。Sonic 以 AWS Marketplace 模型包的形式提供,因此需要一次性订阅步骤,为你的账户授予特定 AWS 区域的模型包 ARN。然后,你可以通过控制台或使用 SageMaker 或 Boto3 SDK 从该 ARN 创建 SageMaker AI 端点。以下步骤遵循 Cartesia 的官方部署 notebook。
前提条件
从 Amazon SageMaker Notebook Instance 或 SageMaker Studio 运行。
AWS Identity and Access Management(IAM)执行角色需要 AmazonSageMakerFullAccess.
要订阅,你的角色(和你本人)需要 aws-marketplace:Subscribe, aws-marketplace:Unsubscribe, 以及 aws-marketplace:ViewSubscriptions。否则,该账户必须已订阅该商品列表。
部署前,请从模型包的 SupportedRealtimeInferenceInstanceTypes field:
ml.g6e.xlarge或更高ml.g7e.2xlarge或更高ml.g7.2xlarge或更高ml.p5.48xlargeml.p5en.48xlarge
如果你所选实例类型的应用值低于你当前的使用量加上计划中的端点实例数,你可能需要申请提高服务配额。详情请参阅 SageMaker AI 配额 。
将 Sonic 3.6 部署到 SageMaker 端点
在 Amazon SageMaker JumpStart 中,你可以订阅其 AWS Marketplace 模型包、创建 SageMaker 模型,并将其托管在实时端点上。以下四个步骤展示了部署路径。
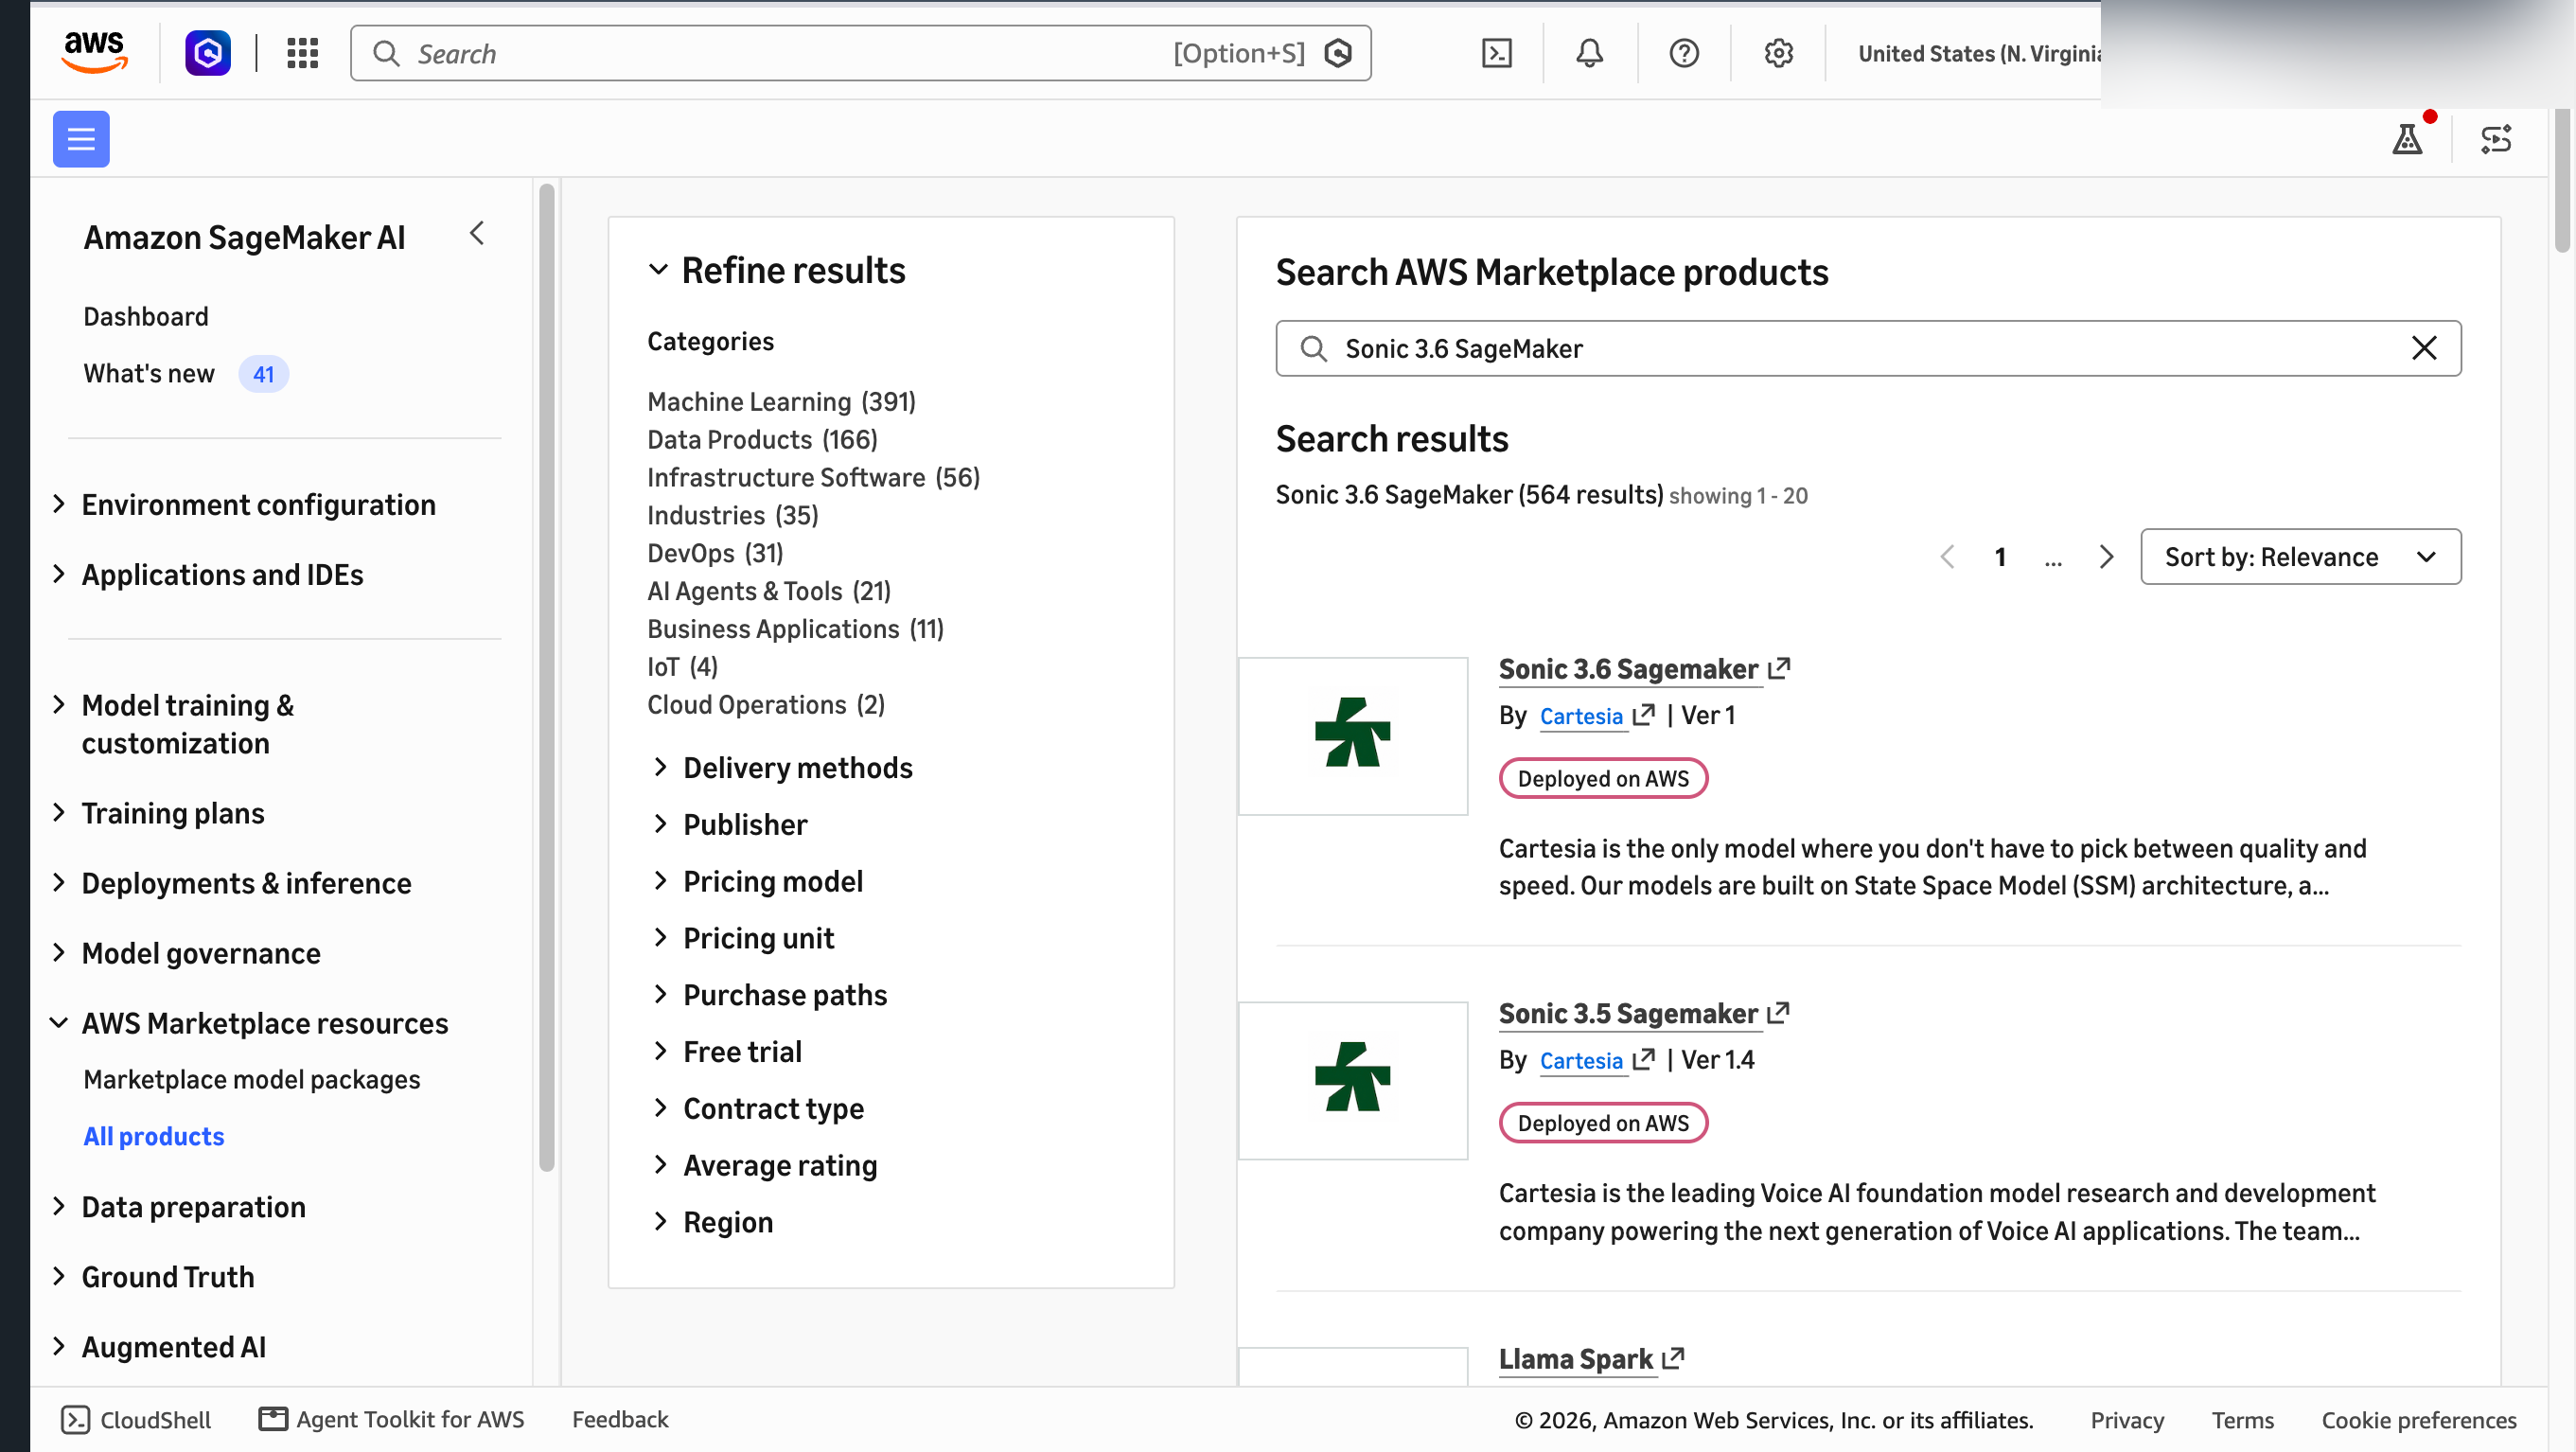
- 在 SageMaker AI 中,打开 AWS Marketplace 资源, 然后打开 所有产品. 搜索 Sonic 3.6 SageMaker 并选择 Cartesia 商品列表。

图 1:在 AWS Marketplace 中搜索 Cartesia Sonic 3.6 SageMaker 模型包
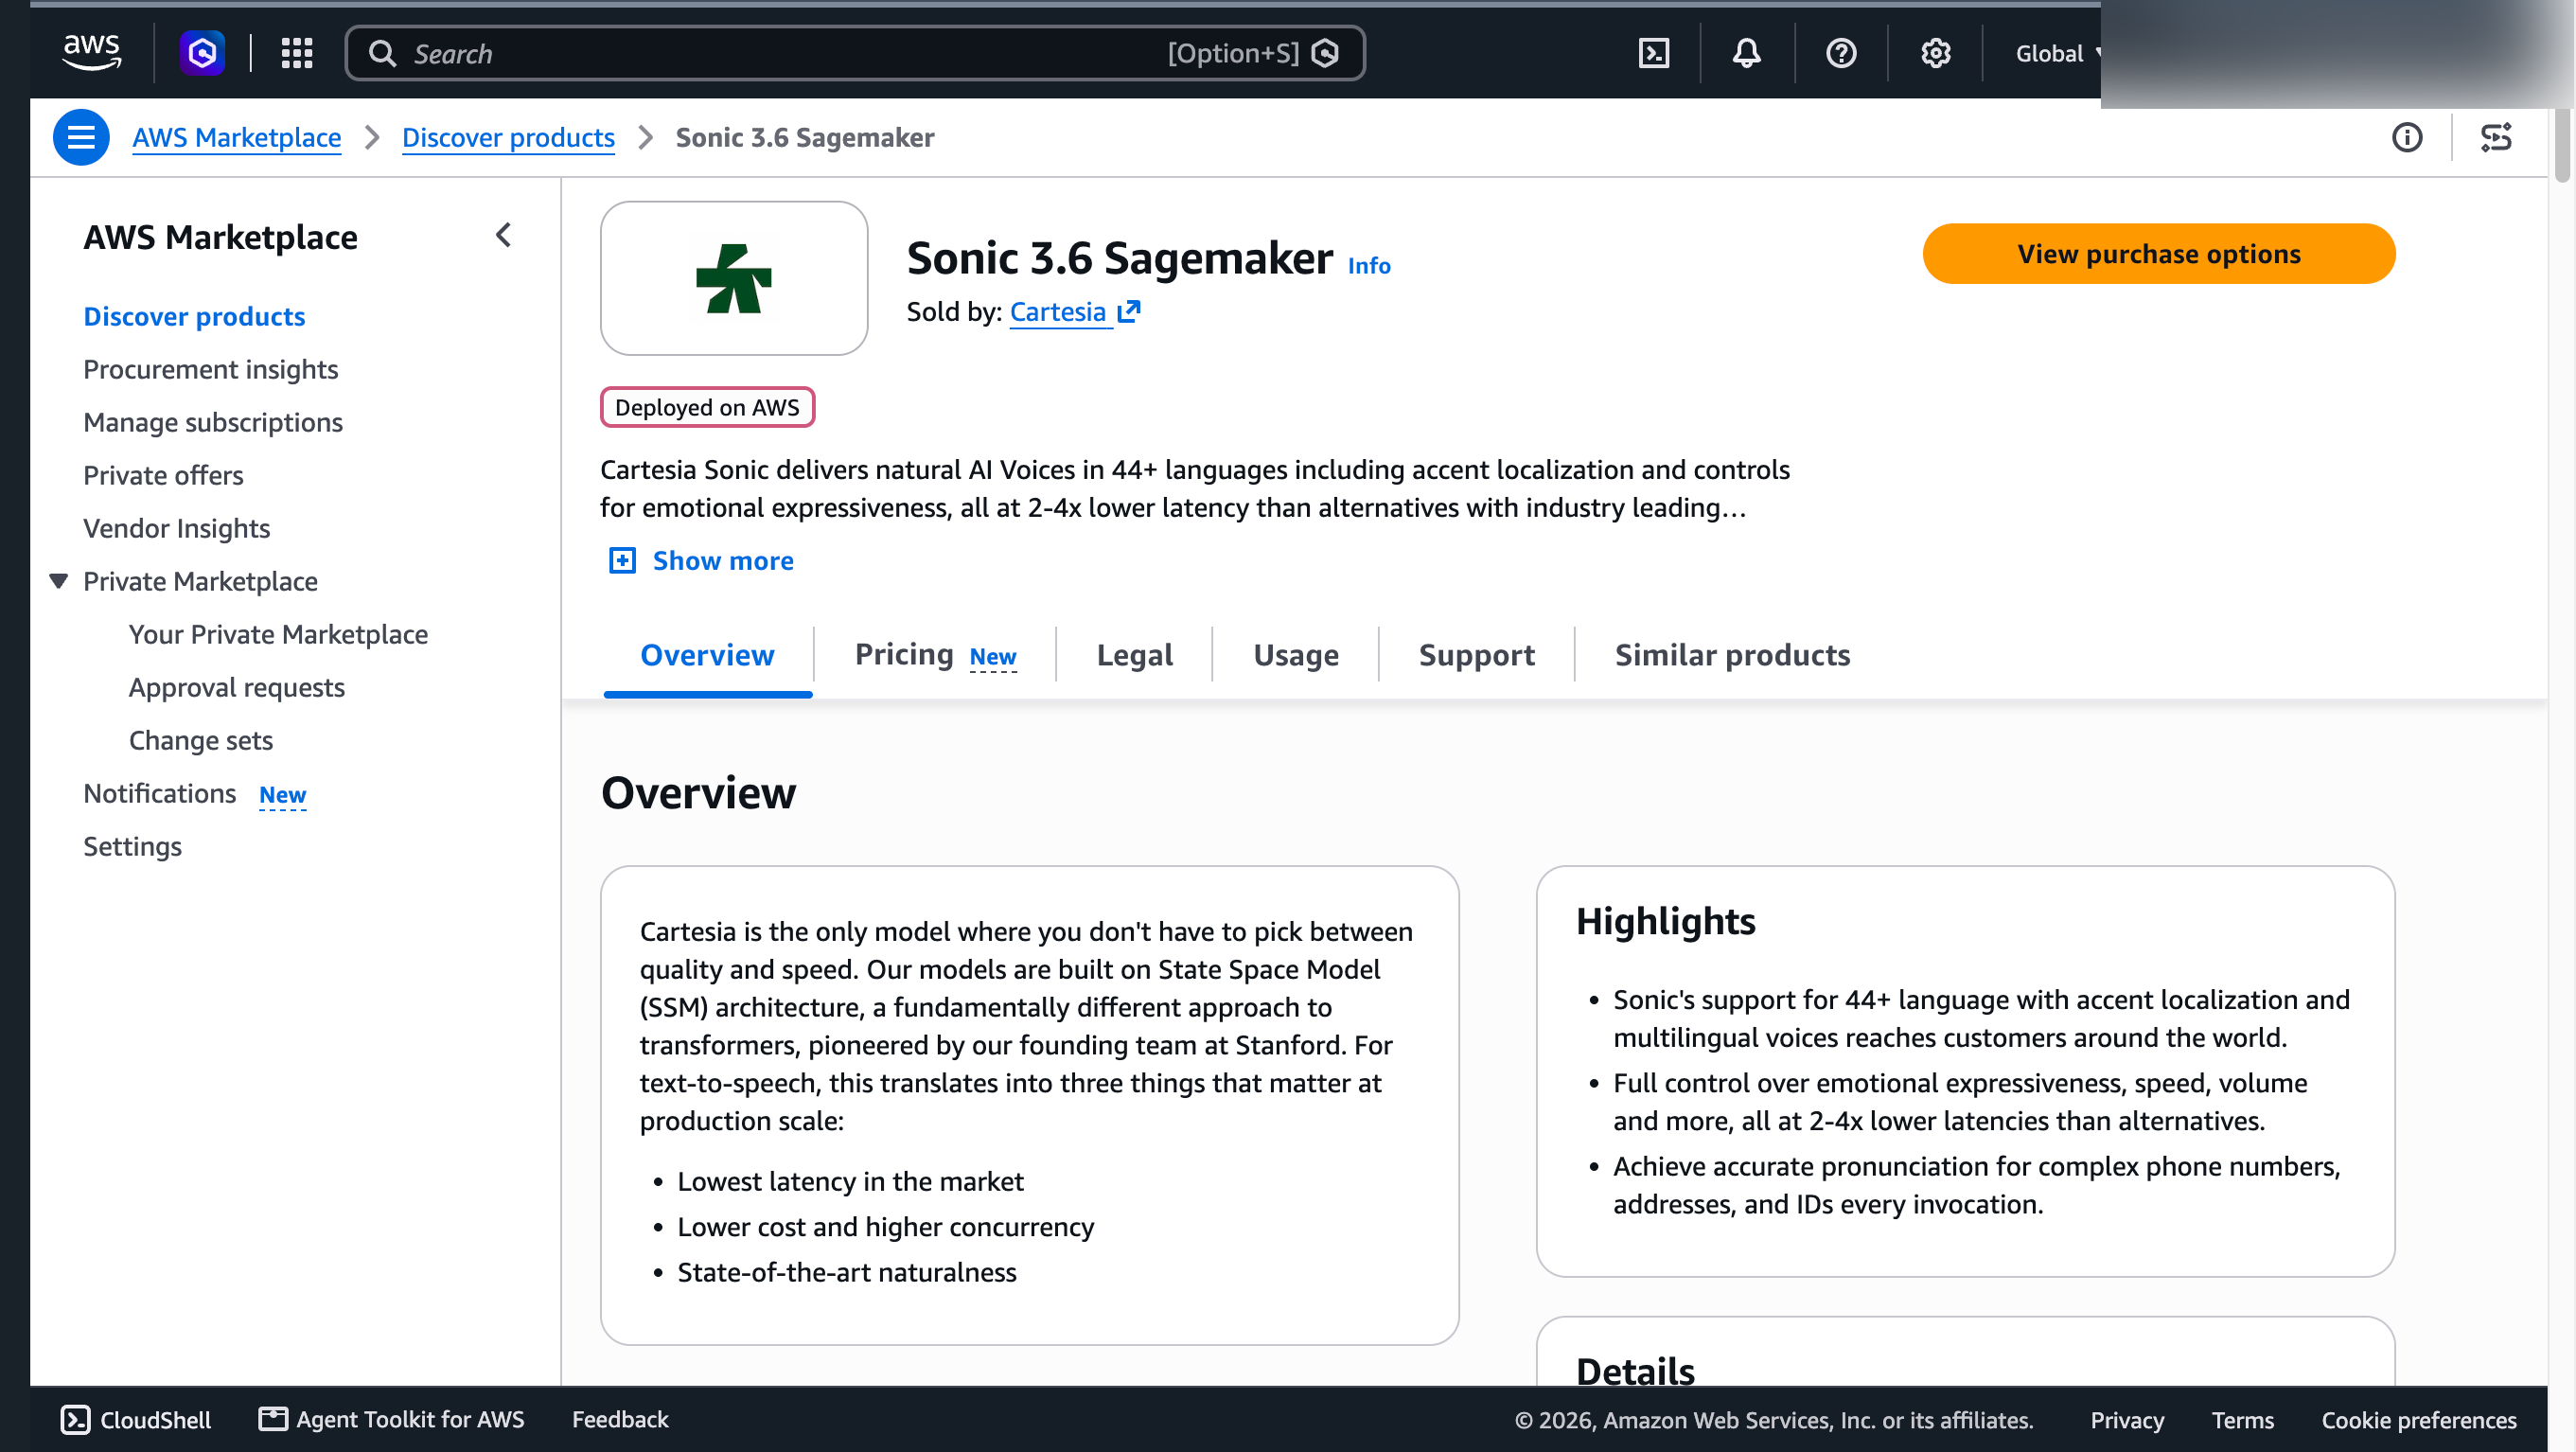
- 选择 查看购买选项, 查看定价和条款,然后订阅。订阅会授予你的 AWS 账户访问该模型包的权限。它不会部署资源。

图 2:AWS Marketplace 中的 Cartesia Sonic 3.6 商品列表
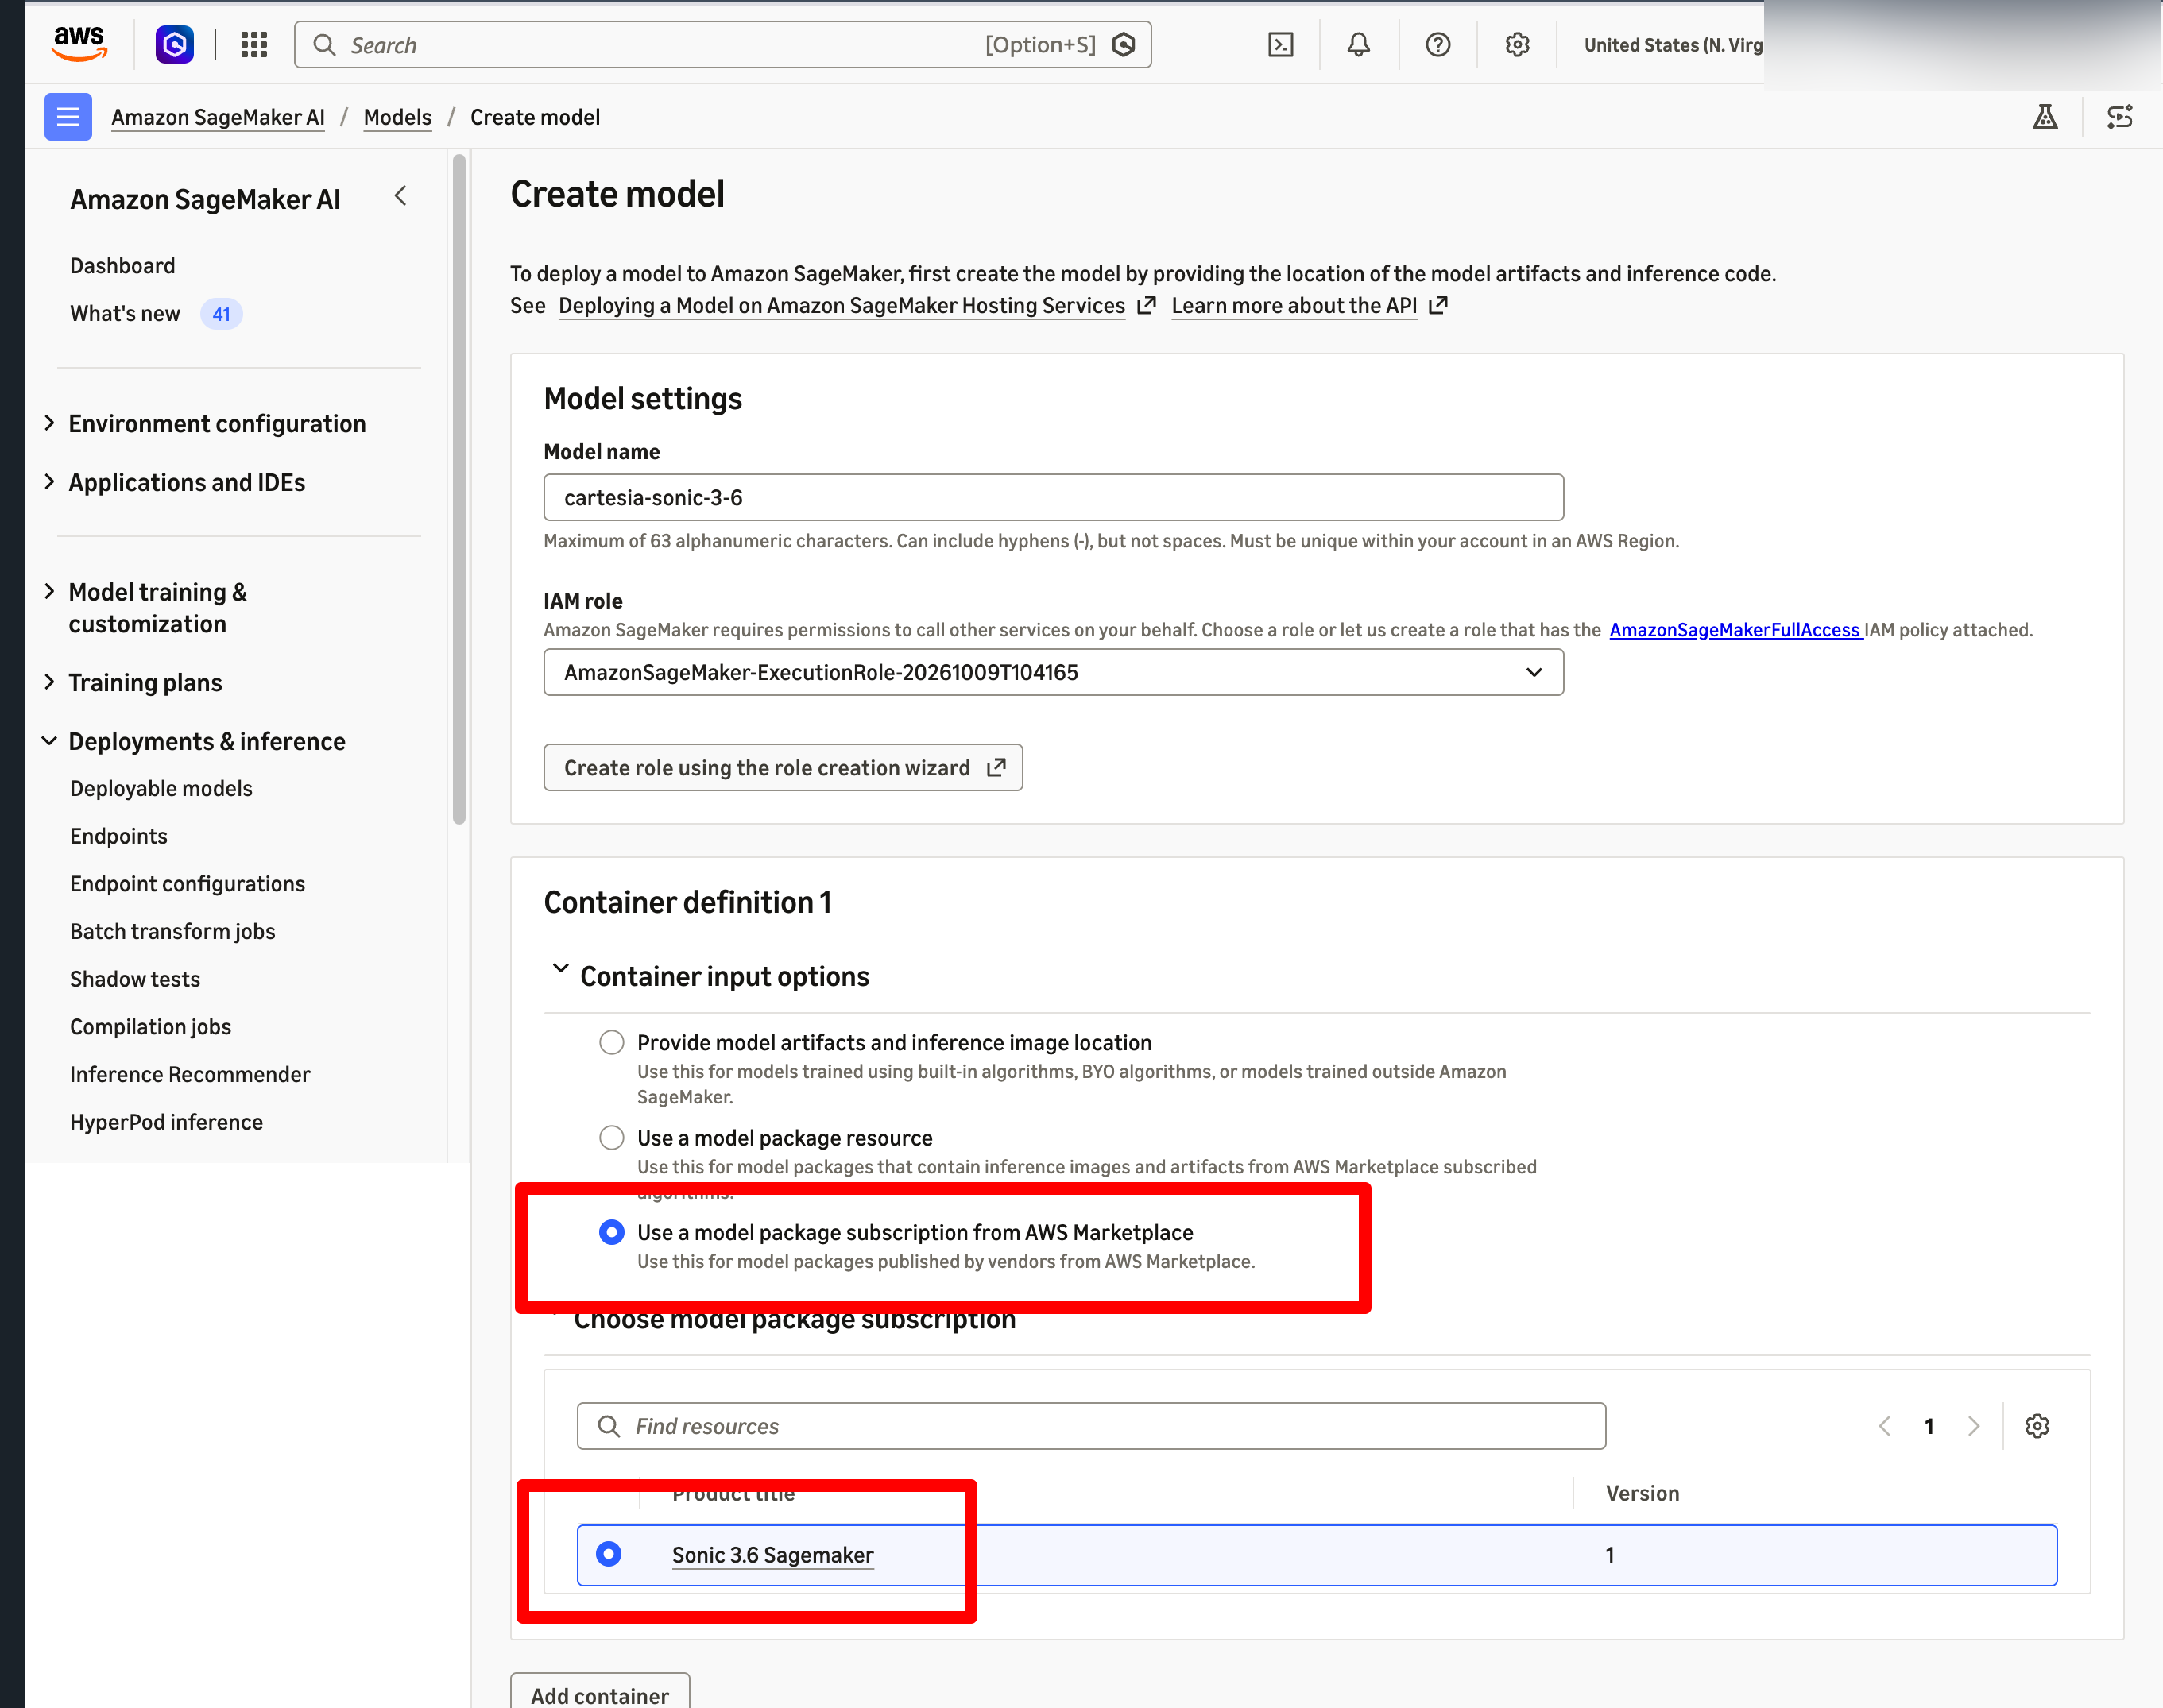
- 打开 部署与推理 > 可部署模型, 选择 创建模型, 选择 使用来自 AWS Marketplace 的模型包订阅, 然后选择 Sonic 3.6 SageMaker. 选择一个执行角色,然后创建模型。

图 3:从 Sonic 3.6 订阅创建 SageMaker 模型
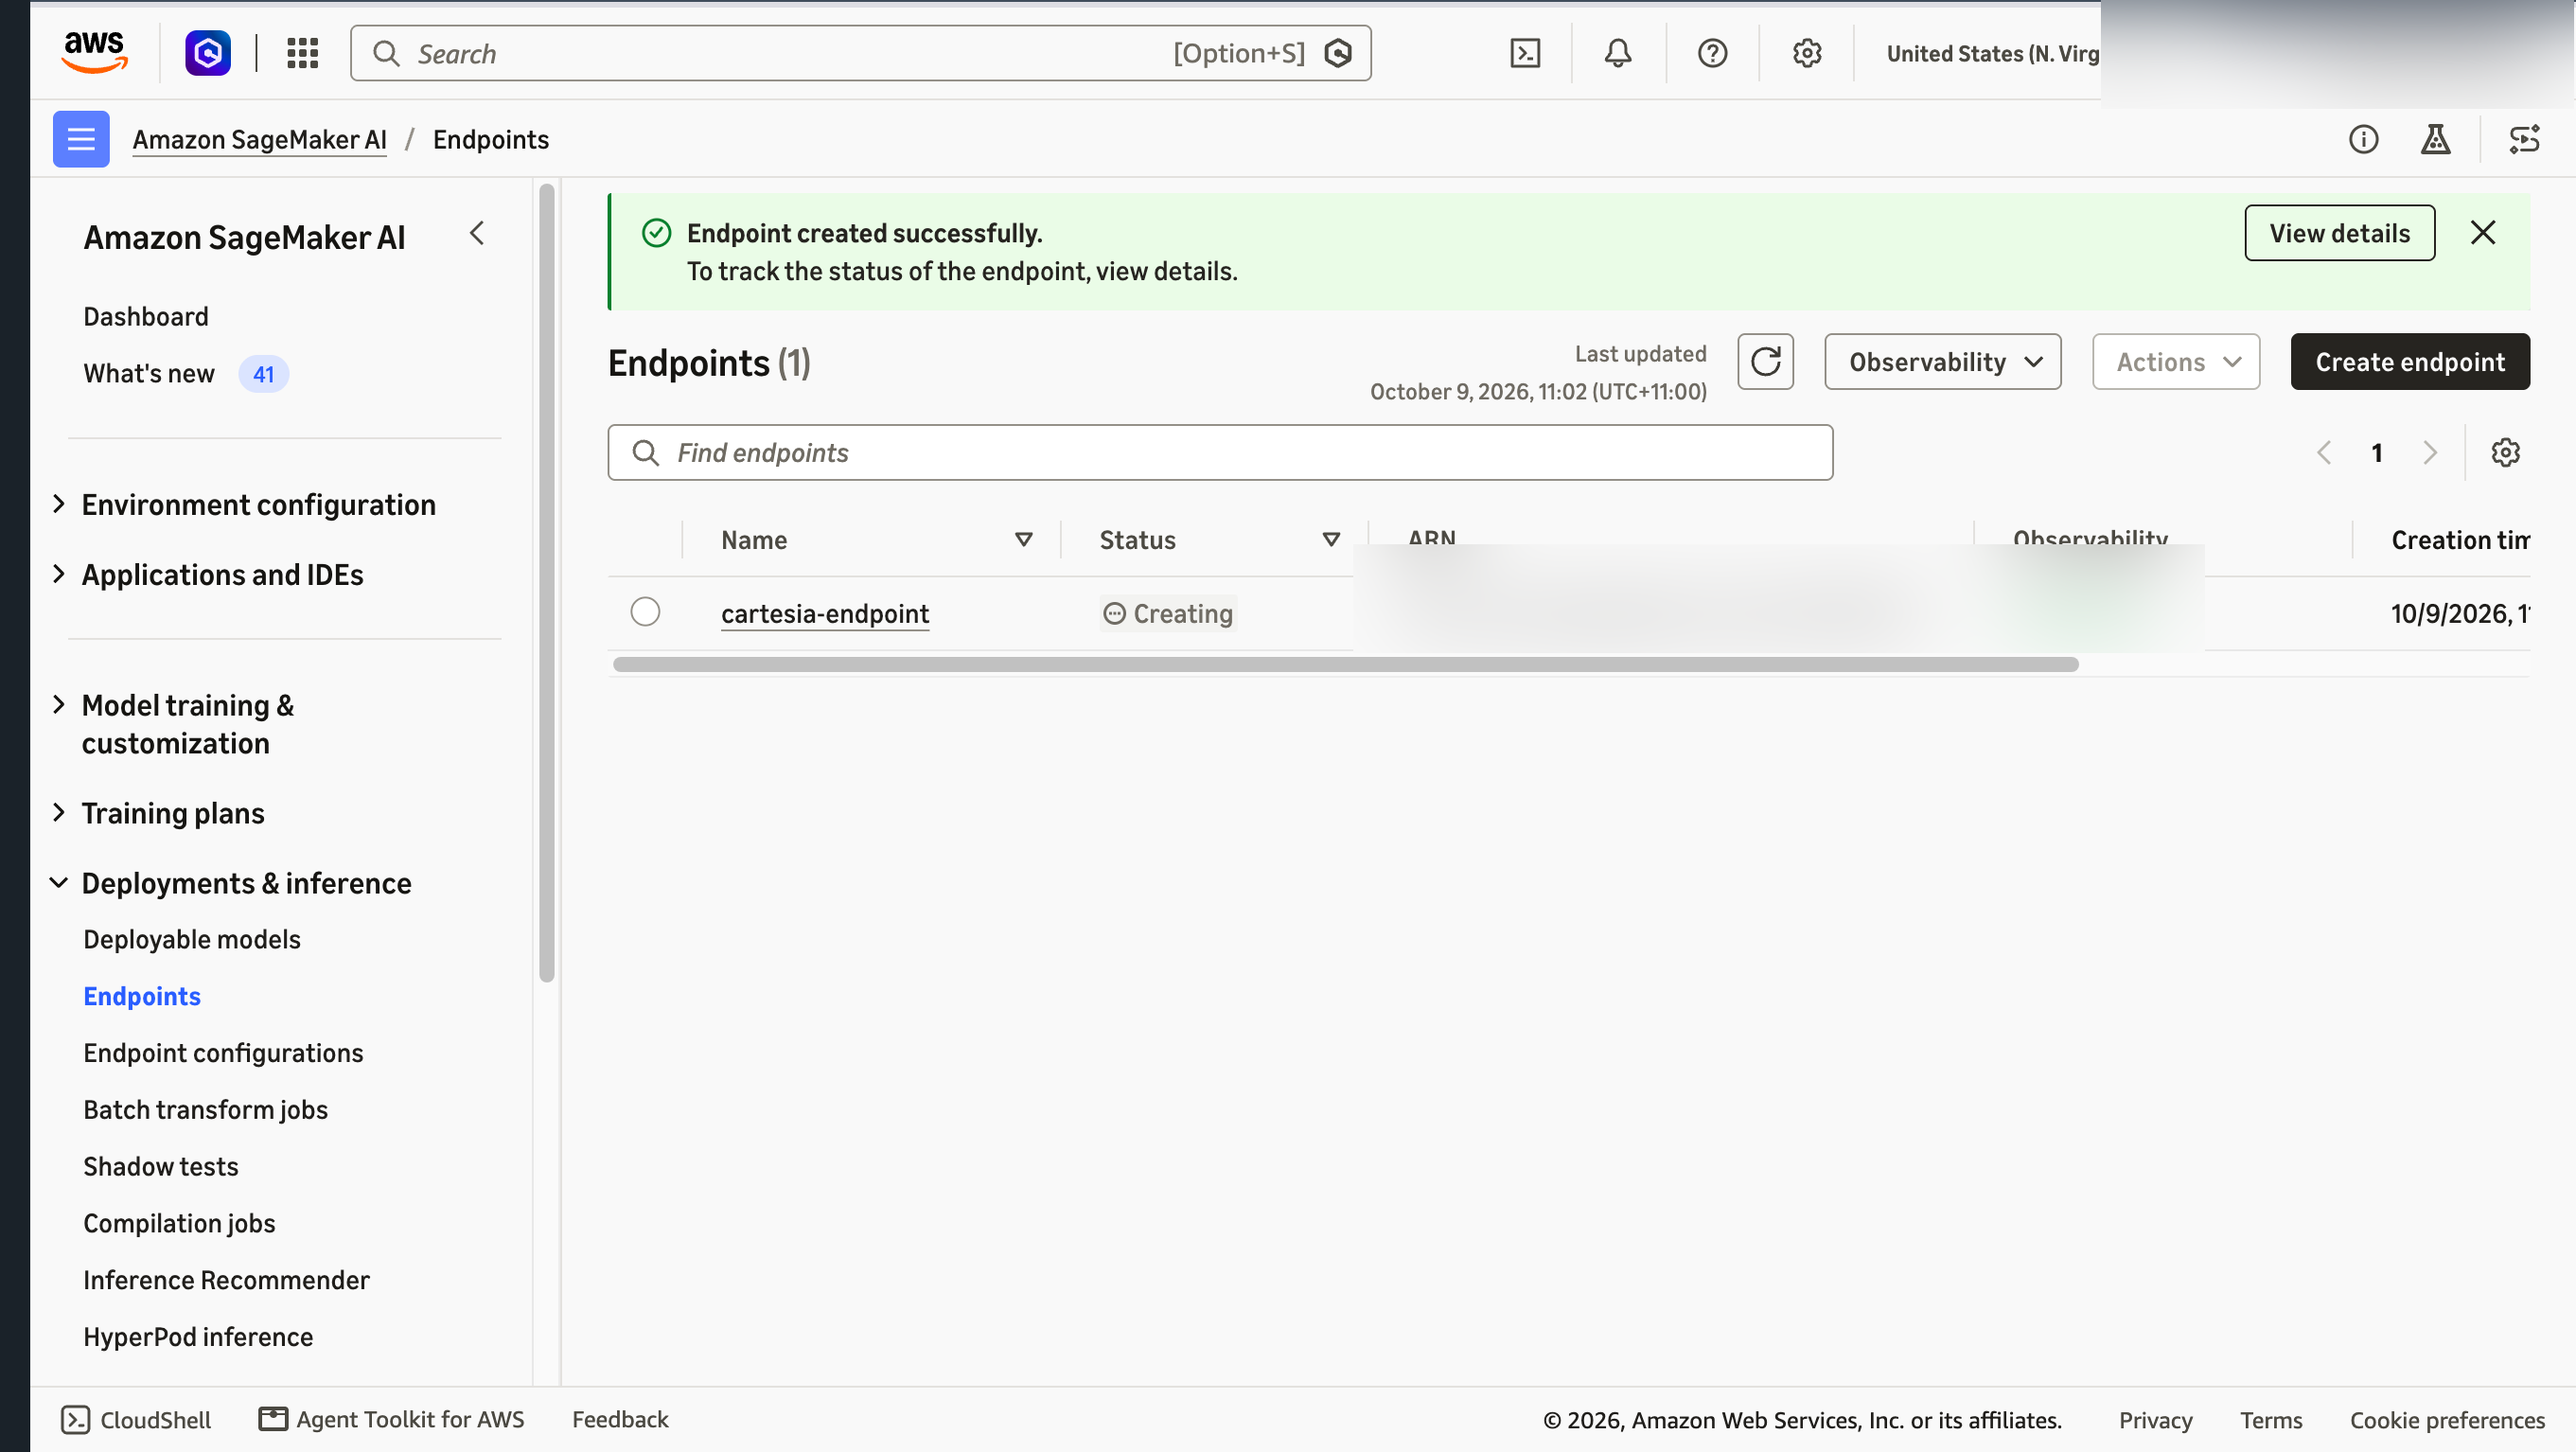
- 使用受支持的 GPU 实例(例如
ml.g6e.2xlarge)从该模型创建实时端点。端点最初会显示 Creating 状态。在调用之前,请等待其变为 InService 。
图 4:Sonic 3.6 的 SageMaker 端点
模型包 ARN 是区域特定的。要使用 SageMaker API 验证美国东部(弗吉尼亚北部)的 Sonic 3.6 包,请运行:
export MODEL_PACKAGE_ARN="arn:aws:sagemaker:us-east-1:865070037744:model-package/sonic36-sagemaker-v0-c6e9cacffcdf31178d1bd7c98c587480"

aws sagemaker describe-model-package \
    --model-package-name "$MODEL_PACKAGE_ARN" \
    --region us-east-1 \
    --query '{Status:ModelPackageStatus,ProductId:InferenceSpecification.Containers[0].ProductId,InstanceTypes:InferenceSpecification.SupportedRealtimeInferenceInstanceTypes}'
端点达到 InService后,使用 SageMaker Runtime InvokeEndpointWithResponseStream API 调用它,并在你的应用中处理返回的音频流。
方案 2:在 EC2 GPU 实例上自行管理
一些团队已有 GPU 基础设施、严格的网络要求,或需要将 Cartesia 与其他服务同址部署。对于这些情况,你可以在 Amazon Elastic Compute Cloud(Amazon EC2)GPU 实例上自行运行模型容器。这让你可以完全控制运行时、扩缩容和网络路径。它使用从 Cartesia 获取的 Cartesia 容器镜像,而不是 AWS Marketplace 模型包。
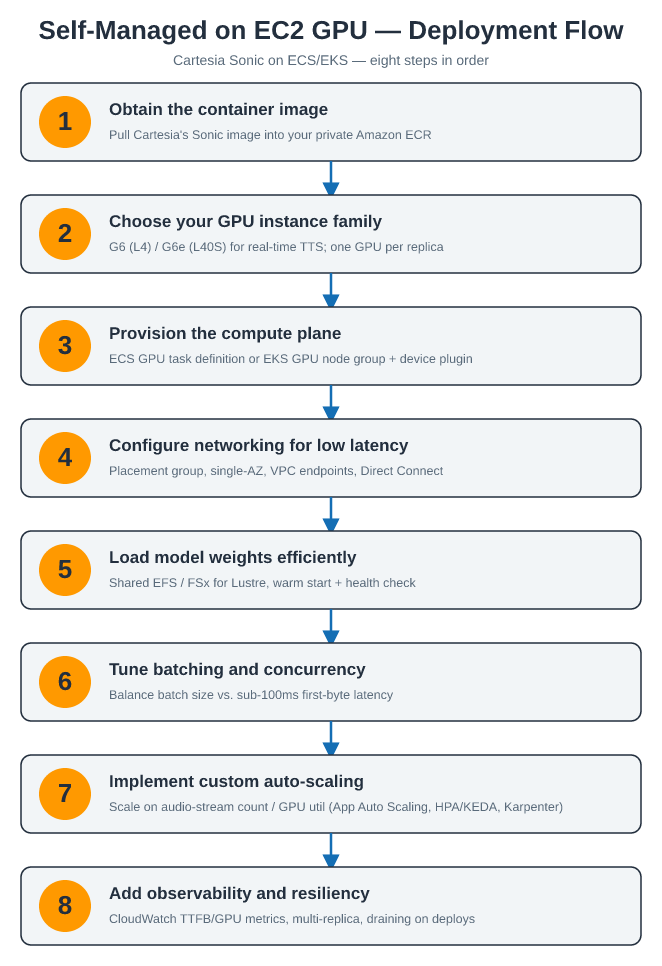
图 5:在 Amazon EC2 GPU 实例上自行管理部署 Cartesia Sonic 的流程
获取容器镜像。 向 Cartesia 申请 Sonic 容器镜像和许可条款。将其复制到你自己的私有 Amazon Elastic Container Registry(Amazon ECR)存储库中,以便你的计算平面可以使用 IAM 作用域凭证拉取它,而不必在规模化时访问外部注册表。
选择你的 GPU 实例系列。 Sonic 在 NVIDIA GPU 实例上运行。G6(L4)和 G6e(L40S)系列是实时 TTS 的最佳平衡选择。较早的 G5(A10G)也可用。根据目标并发量匹配 GPU 内存和 vCPU,并优先为每个模型副本使用单 GPU 实例,以实现最简单的扩缩容。
配置计算平面(Amazon Elastic Container Service(Amazon ECS)或 Amazon Elastic Kubernetes Service(Amazon EKS))。 对于 ECS:注册 GPU 任务定义(设置容器的 GPU 资源需求,例如 resourceRequirements ,类型为 GPU),并将其作为服务运行在 Application Load Balancer 后面。对于 EKS:使用 EKS GPU 优化 AMI 创建 GPU 节点组(或 Karpenter provisioner),安装 NVIDIA 设备插件,并将容器作为 Deployment 部署,由 Service/Ingress 作为前端。
配置网络以实现低延迟。 将推理节点放置在集群置放群组中,以最小化节点间延迟;将副本保留在单个可用区中,以获得最短路径;并使用 VPC 端点进行 ECR/S3 拉取。对于混合或本地调用方,通过 AWS Direct Connect 或私有 Network Load Balancer 终止流量,以避免公共互联网跳转。
高效加载模型权重。 将模型权重存储在跨副本挂载的共享低延迟卷(Amazon Elastic File System(Amazon EFS)或 Amazon FSx for Lustre)上,以便新的 pod/任务启动时无需各自重新下载数 GB 的工件。在容器启动时预热模型,并暴露健康检查,以便负载均衡器仅将流量路由到就绪的副本。
调整批处理和并发。 设置容器的最大批大小和并发流限制,以匹配你的流量特征。更高的批大小可提高 GPU 利用率,但会增加首字节延迟,因此请针对你的低于 100 毫秒目标进行调整。对 streams-per-GPU 进行基准测试,以找到你将用于扩缩容的副本容量。
实现自定义自动扩缩容。 基于反映真实负载、活跃音频流数量或 GPU 利用率的信号进行扩缩容,而不是基于 CPU。在 Amazon ECS 上,使用 AWS Application Auto Scaling 配合自定义的 Amazon CloudWatch 指标。在 Amazon EKS 上,使用由 GPU 或流数量指标驱动的 HPA/KEDA,并借助 Karpenter(或 Cluster Autoscaler)在副本增加时添加 GPU 节点。
添加可观测性和弹性。 将延迟(首字节时间)、流数量和 GPU 指标发送到 CloudWatch。跨节点运行至少两个副本以确保可用性。设置滚动更新或排空策略,以免部署过程中丢弃正在处理的音频流。
当将 Cartesia 集成到现有机器学习(ML)系统、满足托管服务无法提供的网络或合规要求,或通过预留或 Spot GPU 容量优化成本时,推荐采用此方法。代价是,你需要自行负责 SageMaker 原本会为你处理的预置、扩缩容、补丁和监控。
了解更多: 请参阅 适用于 GPU 工作负载的 Amazon ECS 任务定义, 在 Amazon EKS 上管理 NVIDIA GPU 设备,以及 GPU 加速 EC2 实例入门.
选择合适的部署模式
AWS 提供两种运行 Sonic 的方式,各自适合不同的起点。
托管路径使用 AWS Marketplace 中的 Amazon SageMaker AI 模型包,是大多数团队的默认选择:你只需订阅,几分钟内即可部署到 VPC 内端点,并让 SageMaker 处理扩缩容和运维。
自管理路径是在 EC2 GPU 实例上自行运行模型容器,专为具有特定约束的团队设计:已有 GPU 基础设施、严格的网络要求,或需要将 Cartesia 与其他服务同址部署。对这些团队而言,对运行时、扩缩容和网络路径的完全控制比部署速度更重要。
下表总结了两者的对比。
| 标准 | SageMaker(Marketplace) | EC2 GPU(自管理) |
| 部署时间 | 几分钟内即可完成订阅 | 数小时到数天 |
| 计算 | 实时端点。请参阅 SupportedRealtimeInferenceInstanceTypes 支持的实例。 |
EC2 GPU 实例 |
| 运维控制 | 由 AWS 管理 | 完全控制 |
| 扩缩容 | 自定义扩缩容策略 | 自定义扩缩容策略 |
| 成本模型 | 软件费用 + 每实例小时费用 + 基础设施 | EC2(预留/Spot 节省) |
| 网络 | VPC 内端点(网络隔离) | 放置组、Direct Connect |
| 最适合 | 快速、托管、VPC 内 | 自定义基础设施,最大控制权 |
除了在你自己的账户中部署 Cartesia 之外,这些模型已在 Amazon 服务内部的生产环境中得到验证,而很少有环境比实时联络中心对实时语音的要求更高。Amazon Connect 正是这样的验证场。
生产环境中的 Amazon Connect
本节展示 Cartesia 的语音模型如何在 Amazon Connect 中以生产规模运行。
什么是 Amazon Connect?
Amazon Connect 是一项基于云的联络中心服务,企业用它来搭建和运营客户支持业务,处理呼入和呼出语音通话、聊天和消息。凭借按需付费的定价模式以及与 AWS 服务的深度集成,Amazon Connect 每天在各行各业(从金融服务到医疗保健)支撑着数百万次客户交互。
Cartesia 如何为 Amazon Connect 体验提供支持
Cartesia 的语音 AI 模型与 Amazon Connect 原生集成,带来新一代联络中心体验:
- 即时响应能力: 缓解那些会削弱客户对 AI 驱动交互信心的不自然停顿。
- 实时转写: Ink 提供实时转写,并具备智能轮次检测,适用于坐席辅助工作流。
- 多语言支持: 以一致的音质和自然的韵律,用超过44种语言为客户提供服务。
- 可扩展的基础设施: 在高峰时段应对流量激增,同时不降低语音质量或增加延迟。
通过将 Amazon Connect 的全渠道编排能力与 Cartesia 的实时语音 AI 相结合,你可以自动化复杂的客户交互,同时保持自然、响应迅速的体验,从而建立信任与忠诚度。
快速开始
准备好构建超低延迟的语音 AI 应用了吗?以下是后续步骤:
- 通过 SageMaker JumpStart 部署 Sonic: 在 SageMaker JumpStart 模型中心搜索“Cartesia”,几分钟内即可部署一个实时端点。
- 试用 Cartesia API: 请参阅 Cartesia 入门指南。 Cartesia 入门指南无需搭建基础设施。
- 探索参考架构: 访问 Cartesia GitHub 仓库 ,获取示例笔记本、部署模板和集成示例。
- 联系团队: 联系团队: AWS Marketplace 上的 Cartesia.