编码基准测试主要关注哪个前沿模型能解决最多的任务。 既然 token 已不再免费,那么解决这些任务的成本也同样重要。 在模型和账单之间还隔着一层 harness,它决定了每次请求中放入什么内容,以及一个任务需要发起多少次请求。
为了看清这一层有多重要,我们让五个开源 harness(goose、Codex CLI、OpenCode、Hermes Agent 和 pi)使用同一个模型 gpt-6.1-sol(高推理强度),并运行相同的 Terminal-Bench 4 任务。 每个 harness 对每个任务尝试五次,每个 harness 共 310 次计分试验。
结果
goose 在通过率上与 Codex CLI、OpenCode 和 Hermes Agent 持平。 其每任务成本低 15% 到 43%。 pi 在两项指标上都与 goose 持平。
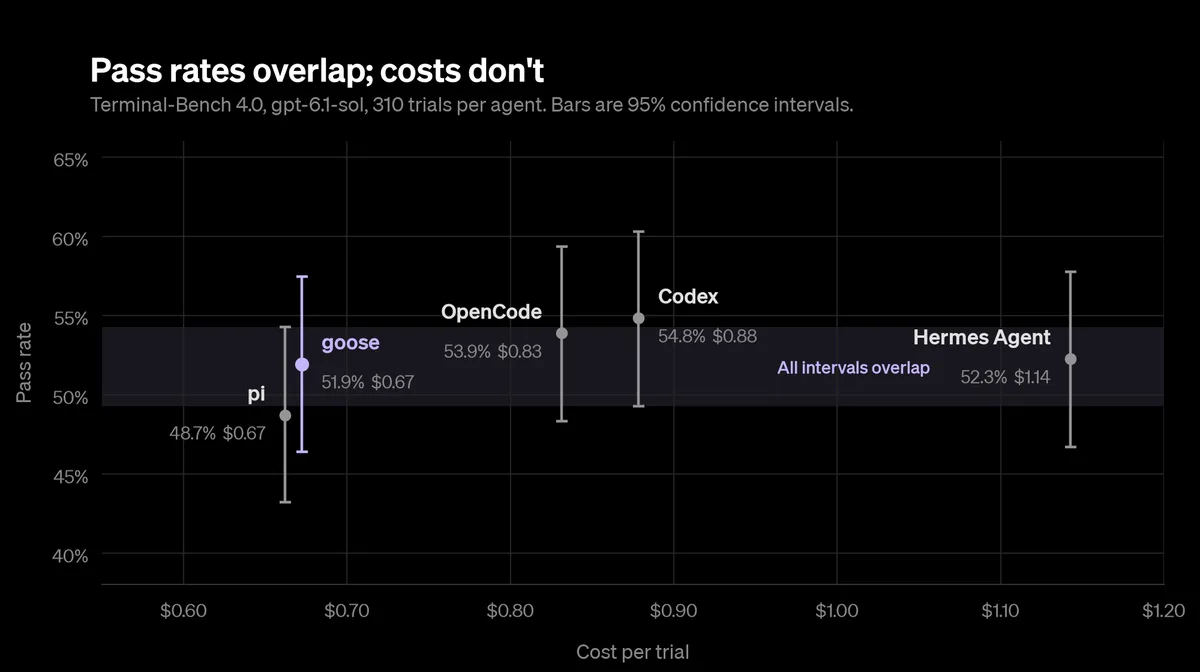
五个 harness 的通过率彼此相差约六个百分点以内,且没有一个与 goose 的差异在 95% 置信度下显著。 在底层使用同一模型的情况下,没有哪个 harness 明显解决了更多任务。
成本则是另一回事。 逐任务比较,Codex 的成本比 goose 高 31%,OpenCode 高 18%,Hermes Agent 高 75%,均在 95% 置信度下显著。 pi 的成本与 goose 大致相同。
| Harness | 通过率 | 每次试验成本 | 每个已解决任务的成本 |
|---|---|---|---|
| goose | 51.9% | $0.67 | $1.29 |
| pi | 48.7% | $0.67 | $1.37 |
| OpenCode | 53.9% | $0.83 | $1.54 |
| Codex CLI | 54.8% | $0.88 | $1.60 |
| Hermes Agent | 52.3% | $1.14 | $2.19 |
我们如何运行
- 任务: Terminal-Bench 4.0,共 66 个任务中的 62 个。我们排除了三个需要 GPU 的任务,以及一个所需 MCP 服务器有两个适配器无法连接的任务。
- Harness: goose(main 分支,位于
104ddde58)、Codex CLI 0.160.1、OpenCode 1.18.35、Hermes Agent v0.21.6 和 pi 1.0.4。每个都通过其在 Harbor 0.24 中的内置适配器运行,使用默认提示词和限制,并通过 harness 自身的配置将推理强度设为高。 - 轮次: 五轮完整运行,每轮每个 harness 对每个任务进行一次试验,使用默认任务超时,在单台 16 核、32 GB 服务器上运行。
- 成本: 我们没有使用任何 harness 自带的统计。代理捕获了每个请求和响应,我们按供应商报告的 token 用量以标价计算成本。
- 重跑: 代理从未启动的试验(例如软件包安装失败)被重跑。代理启动后失败的试验被计为失败。