人工智能
在 Amazon SageMaker HyperPod 上检测静默数据损坏并从中恢复静默数据损坏(SDC)是指 GPU 等硬件返回一个错误但看似合理的数值,却不报任何错误。在分布式训练中,这个错误数值可能流入每个副本的梯度和权重。损失值可能连续数小时看起来正常,等到团队发现无法解释的发散或模型变弱时,算力已经消耗殆尽。这种情况在大规模场景中确实会发生:在为期 54 天、使用多达 16K 块 H100 GPU 的 Llama 3 405B 预训练 期间,Meta 将 419 次意外作业中断中的 6 次归因于静默数据损坏,而这还只是那些中断了作业并被追溯到 SDC 的案例。
Amazon SageMaker HyperPod 已经会替换报告故障的节点:健康监控代理会监视 GPU 错误,深度健康检查会对节点进行压力测试,自动节点恢复会换掉有问题的硬件。SDC 能绕过所有这些功能,因为硬件从不报告任何信息。检测必须来自训练作业本身。
在本文中,我们向 PyTorch DistributedDataParallel(DDP)训练循环添加三项检查来检测 SDC。当某项检查触发时,我们将可疑 rank 映射到其节点,控制住损坏,并让 SageMaker HyperPod 替换该节点。每项检查覆盖故障可能出现的不同位置:
- 一项 非有限梯度检查 能够在 GPU 前向或反向传播中、在故障发生的那一步捕获 NaN、Inf 和溢出,也能捕获梯度 all-reduce 引入的 NaN 或 Inf。
- 一项 ring replay 审计能够捕获有限的错误数值。在审计步骤中,每块 GPU 都会从另一个节点重新计算一个微批次,并逐位比较损失值,同时通过指纹比较梯度。 ring replay 审计 能够捕获有限的错误数值。在审计步骤中,每块 GPU 都会从另一个节点重新计算一个微批次,并逐位比较损失值,同时通过指纹比较梯度。
- 一项权重指纹比对能够通过比较更新后每个副本的权重,捕获优化器步骤和存储权重中的损坏。 权重指纹比对 通过比较更新后每个副本的权重,捕获优化器步骤和存储权重中的损坏。
我们在一个配有 4 台 ml.p5.48xlarge 实例(32 块 NVIDIA H100 GPU)的 SageMaker HyperPod 集群上,通过软件注入故障的方式测试了这些检查,并在三台实例上重复了每一项测试,这是这些检查所需的最低实例数。该解决方案的完整代码可在 配套的 GitHub 仓库.
静默数据损坏是如何发生的,以及为什么常规检查会漏掉它
SDC 源于制造缺陷(边缘晶体管逃过供应商筛选)以及特定计算单元中的硅老化,最常见的是张量核心中的乘加通道,而这正是硬件模型训练反复冲击的部分。这个边缘电路在大多数时候计算正确,只在压力下出错:高温、电压跌落或特定操作数模式。由于算术逻辑路径没有 ECC 或奇偶校验(与内存不同),错误结果(例如 4.0001 而非 4.0000)永远不会被标记,并会通过激活和梯度流入每个副本的权重。
之所以如此难以捕捉,是因为 SDC 位于计算路径中,而你已经拥有的每一项完整性检查守护的都是不同的边界:
| 检查 | 它守护的是什么 | 为什么它会漏掉 SDC |
| ECC | 内存 | 它能捕获内存中的位翻转,但无法发现计算错误。张量核心的计算结果没有 ECC 保护。 |
| Xid 错误(NVRM) | GPU 驱动/硬件故障 | 当 GPU 检测到故障时会引发 Xid。根据定义,SDC 不会引发任何 Xid,因此不会有任何内容落入 /aws/sagemaker/Clusters/ HMA 日志。 |
| DCGM 深度健康检查 | 硬件故障 | 会漏掉需要你工作负载的操作数、热状态或时序才能发现的缺陷。它运行在空闲节点上,在你的作业之外。 |
| NVLink / PCIe / EFA 校验和 | 传输 | 验证收到的字节与发送时一致,而不是验证它们计算得是否正确。 |
| 检查点校验和 | 存储往返 | 一个被污染但保持一致的检查点在校验和上没有问题。 |
捕获 SDC 的方法是检查计算结果本身。
解决方案概述
该循环包含四个步骤。你的训练作业执行前两步,后两步则使用 Kubernetes 和 SageMaker HyperPod 的功能:
步骤 1。 检测: 训练循环中的三项检查通过比较数据并行副本来定位可疑 GPU。
步骤 2。 本地化: 在由 Amazon Elastic Kubernetes Service(Amazon EKS)编排的 SageMaker HyperPod 集群上,Kubernetes 节点名称中包含实例 ID,因此将可疑 rank 映射到节点只需一次查找。
步骤 3。 包含并关联: 停止作业,隔离该节点,并在 SageMaker HyperPod 可观测性仪表板中查看其 GPU 指标。
步骤 4。 确认并恢复: 确认:当告警存在歧义时,请在复核后替换节点,并从可疑窗口之前保存的检查点恢复。
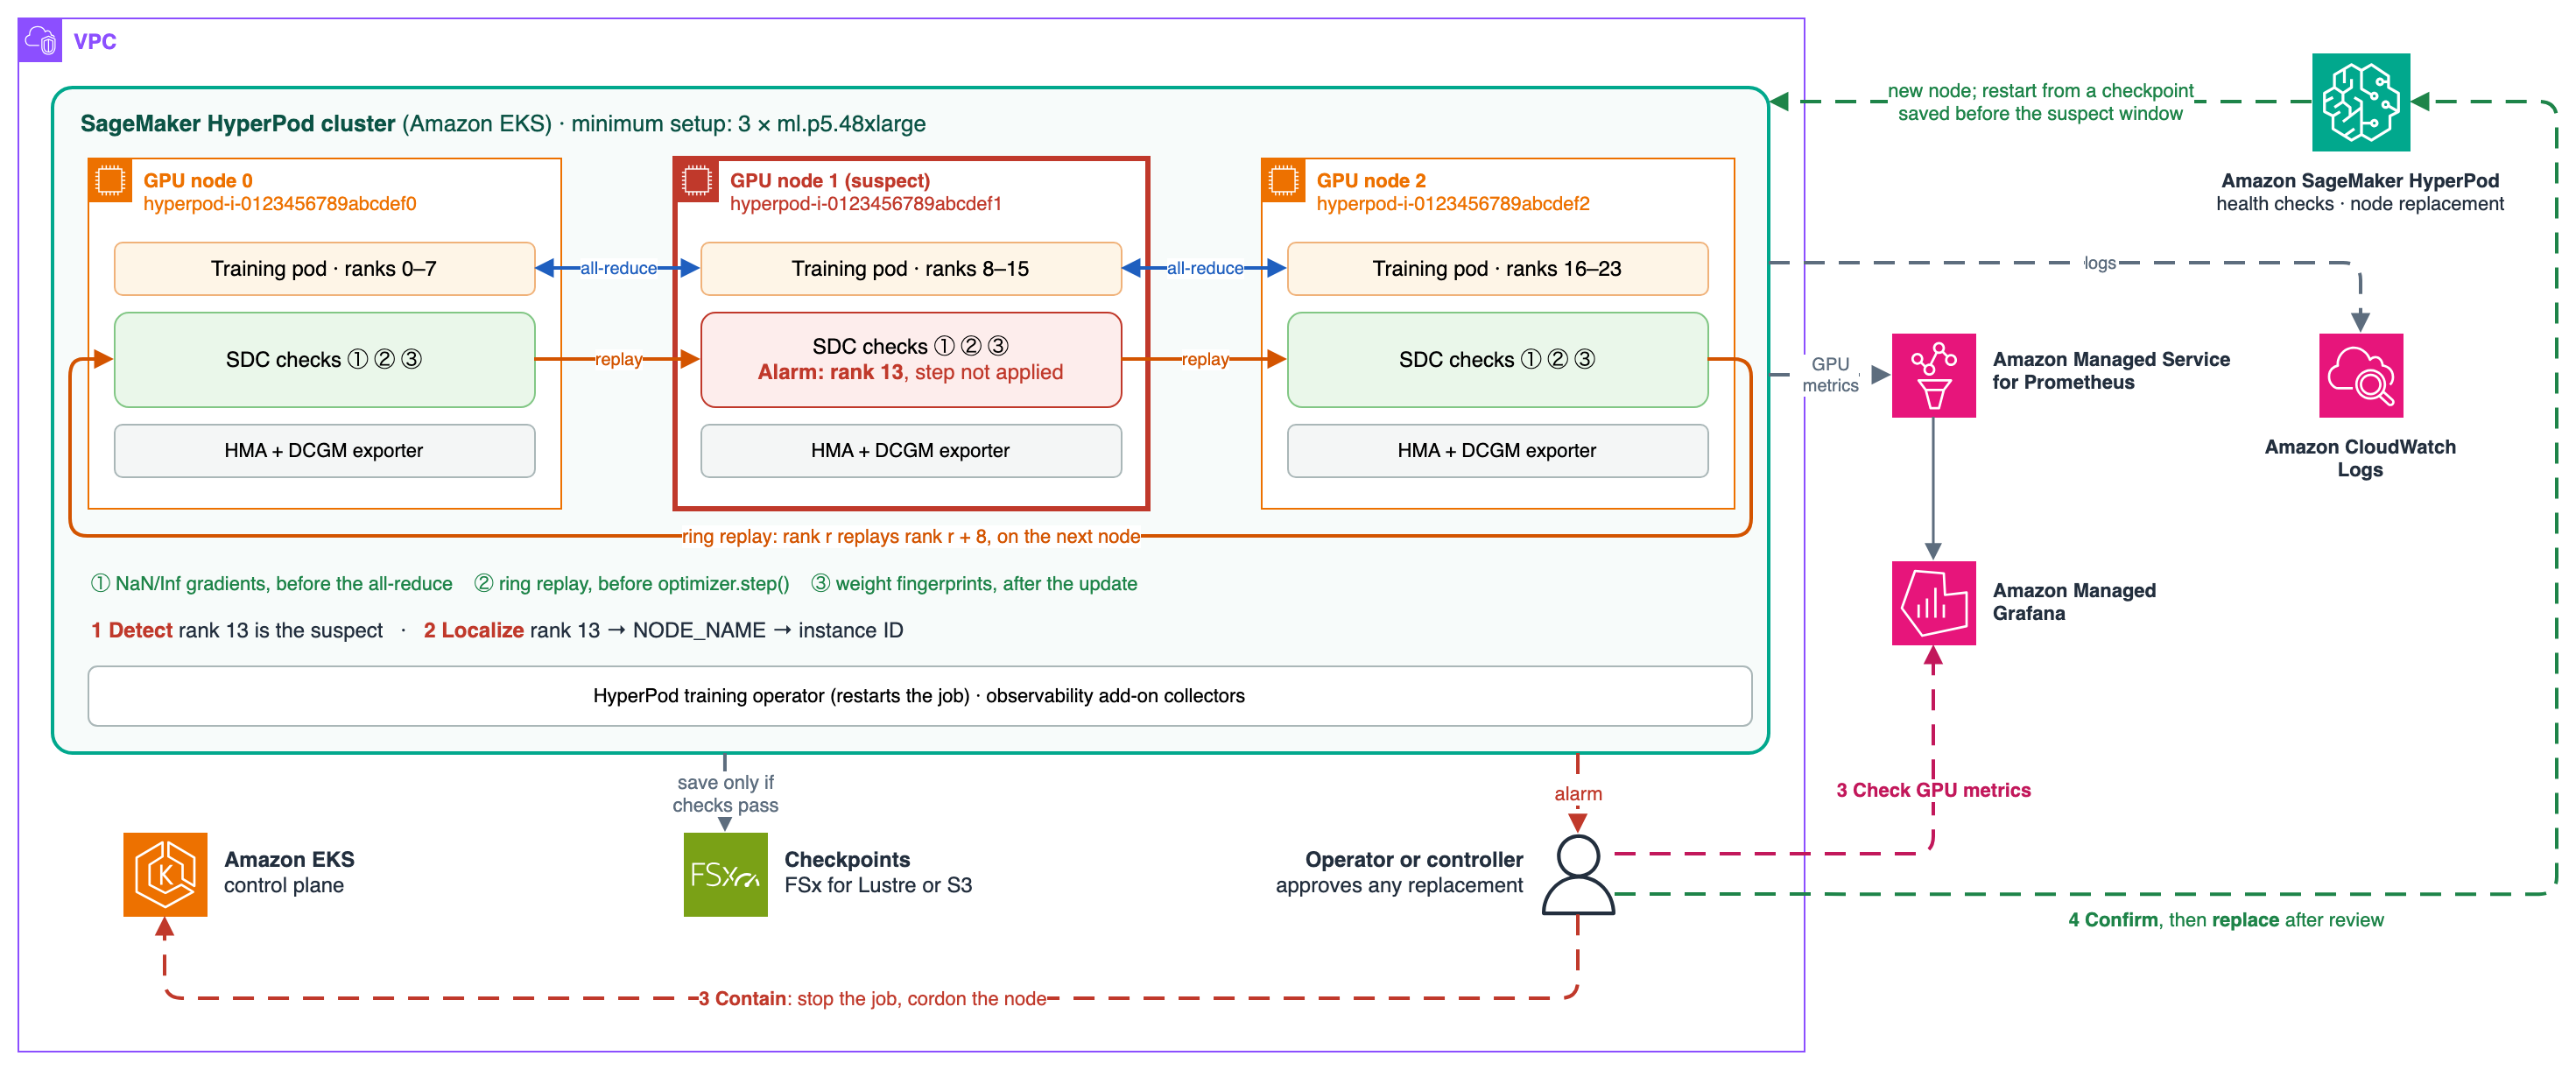
图 1:一个 SageMaker HyperPod EKS 集群,包含三个 p5 节点,运行训练 Pod 和 SDC 检查。节点 1 针对 rank 13 发出告警,建议的步骤是隔离该节点、检查 GPU 指标、替换该节点并重启训练
把这一循环看作多个层次会更容易理解,每一层都增加了不同的内容:
| 层 | 来源 | 它增加了什么 | 能捕获真正静默的 SDC 吗? |
| 1. 非有限梯度检查 | 你的训练脚本 | 在 all-reduce 之前,标记出本地梯度为 NaN 或 Inf 的 GPU,并在归约后的梯度为 NaN 或 Inf 时停止该步骤 | 仅捕获变为 NaN、Inf 或溢出的故障 |
| 2. Ring replay 审计 | 你的训练脚本 | 每块 GPU 都会重新计算另一个节点的微批次,并比较损失位和梯度指纹 | 是的,对于在审计步骤中会改变损失或梯度的有限计算路径故障 |
| 3. 权重指纹比对 | 你的训练脚本 | 指出在更新后权重与严格多数不一致的副本 | 是的,对于单个副本上的优化器步骤和存储权重故障有效。对计算路径故障和分片权重则无法检测。 |
| 4. 本地化 | 你的训练脚本,使用 SageMaker HyperPod 节点名称 | 将可疑 rank 映射到由 Kubernetes 节点名称得到的实例 ID | n/a:它进行本地化 |
| 5. DCGM 关联 | HyperPod 可观测性附加组件 | 告警前后可疑 GPU 的 DCGM 指标 | 它只在硬件计数器也出现相应故障时才确认故障。干净的遥测数据并不能证明某个节点没有问题。 |
| 6. 深度健康检查 | StartClusterHealthCheck (DCGM L4) |
对可疑节点执行按需硬件诊断 | 它能捕获由自身测试模式触发的硬件缺陷。这是分诊,不是证明 |
| 7. 重复违规历史 | 你基于保留的告警和遥测数据构建的查询 | 反复告警的节点 | 部分如此:它会暴露出值得尽早检查的节点 |
第 1–3 层是唯一能检测静默 SDC 的层,它们位于你的训练代码中。第 4 层将它们的告警转换为实例 ID,而 HyperPod 各层则对告警进行佐证并闭环处理。
前提条件
要跟着操作,你需要:
- 一个由 Amazon EKS 编排的 SageMaker HyperPod 集群,至少包含三个 GPU 节点。ring 审计需要为它判定的每一次比较使用三个不同的节点,而权重比对需要每个权重的三份副本才能找出那个异常副本。参见 使用 Amazon EKS 编排 SageMaker HyperPod 集群.
- 一个 PyTorch DDP 训练作业,其中每个副本都运行自己的优化器步骤,并配有数据管道,能够为给定步骤重建任意 rank 的微批次,例如带种子的采样器。
- 检查点存放在共享存储、Amazon FSx for Lustre 或 Amazon Simple Storage Service(Amazon S3)上。替换节点会销毁其根卷和辅助卷,包括本地 NVMe 上的任何内容。
- 这个 SageMaker HyperPod 可观测性附加组件 用于关联步骤。如需 ECC、NVLink 和节流计数器,请开启高级 DCGM 指标。
- 通过以下方式访问集群:
kubectl,以及用于以下操作的 AWS Identity and Access Management(IAM)权限:sagemaker:StartClusterHealthCheck以及sagemaker:BatchReplaceClusterNodes。参见 手动隔离、替换或重启节点.
第 1 步:在训练循环中通过三项检查进行检测
数据并行会同时训练模型的多个副本(称为 replica)。每个副本在批次的不同切片上训练。每次反向传播后,all-reduce 会对各副本的梯度求平均,每个副本在 optimizer.step()下面是一个权重在三个副本上的情况,学习率为 0.1:
| 副本 0 | 副本 1 | 副本 2 | ||
| 起始权重 | 0.500 | 0.500 | 0.500 | 相同 |
| 本地梯度 | 0.20 | 0.40 | 0.30 | 不同(不同数据) |
| 平均梯度 | 0.30 | 0.30 | 0.30 | 相同,在 all-reduce 之后 |
| 步后的权重 | 0.470 | 0.470 | 0.470 | 相同 |
本地梯度各不相同,因为每个副本看到的数据不同。而在优化器步骤之后,各副本的权重必须逐位完全一致。
故障发生在哪里,决定了哪项检查能发现它。如果副本 1 计算出的本地梯度是 4.00 而不是 0.40,all-reduce 会把这一误差传播到每个副本:三个副本都会应用同一个错误的更新,它们的权重仍然保持一致。只有副本 1 的本地梯度看起来不同,而且只在 all-reduce 之前。反之,如果副本 1 在优化器步骤期间或之后损坏了某个权重,它的权重就不再与其他副本一致。有一个例外:某个副本权重中的 NaN 或 Inf 会通过下一次 all-reduce 传到每个副本,此后各副本又恢复一致。all-reduce 本身内部的故障,例如某块 GPU 错误地累加部分和,也会同样地传到每个副本。
因此,计算路径上的故障必须在优化器步骤之前被捕获,此时错误的梯度仍可被丢弃;而更新过程中或更新之后存储权重中的故障则需另行处理。有限的错误数值需要重新计算:跨副本比较梯度范数只能捕获 NaN 和 Inf(参见 为什么不比较本地梯度范数?)。这样在每个训练步骤内按固定顺序对每个 DP rank 进行三项检查:
- 非有限梯度检查 – 在 all-reduce 之前,标记任何本地梯度为 NaN 或 Inf 的 rank。这样可以在 GPU 前向或反向传播中出现数值爆炸的那一步就捕获问题,并指出是哪块 GPU。在 all-reduce 之后,也要在更新之前检查归约后的梯度是否存在 NaN 或 Inf。
- Ring replay 审计 – 在审计步骤中,在优化器步骤之前,每个 rank 会在另一个节点上重新计算某个 rank 的微批次。它会逐位比较损失,并在使用确定性内核的情况下,比较每个参数的梯度指纹。这可以捕获计算路径中出现的有限错误值。
- 权重指纹比对 – 在优化器步骤之后、每隔 N 步以及每次检查点之前,比较每个副本的权重指纹。这样可以捕获优化器步骤和存储权重中的故障。
本步骤中的代码适用于 PyTorch DDP。对于张量并行、流水线并行或上下文并行,请参阅 超越 DDP.
执行顺序
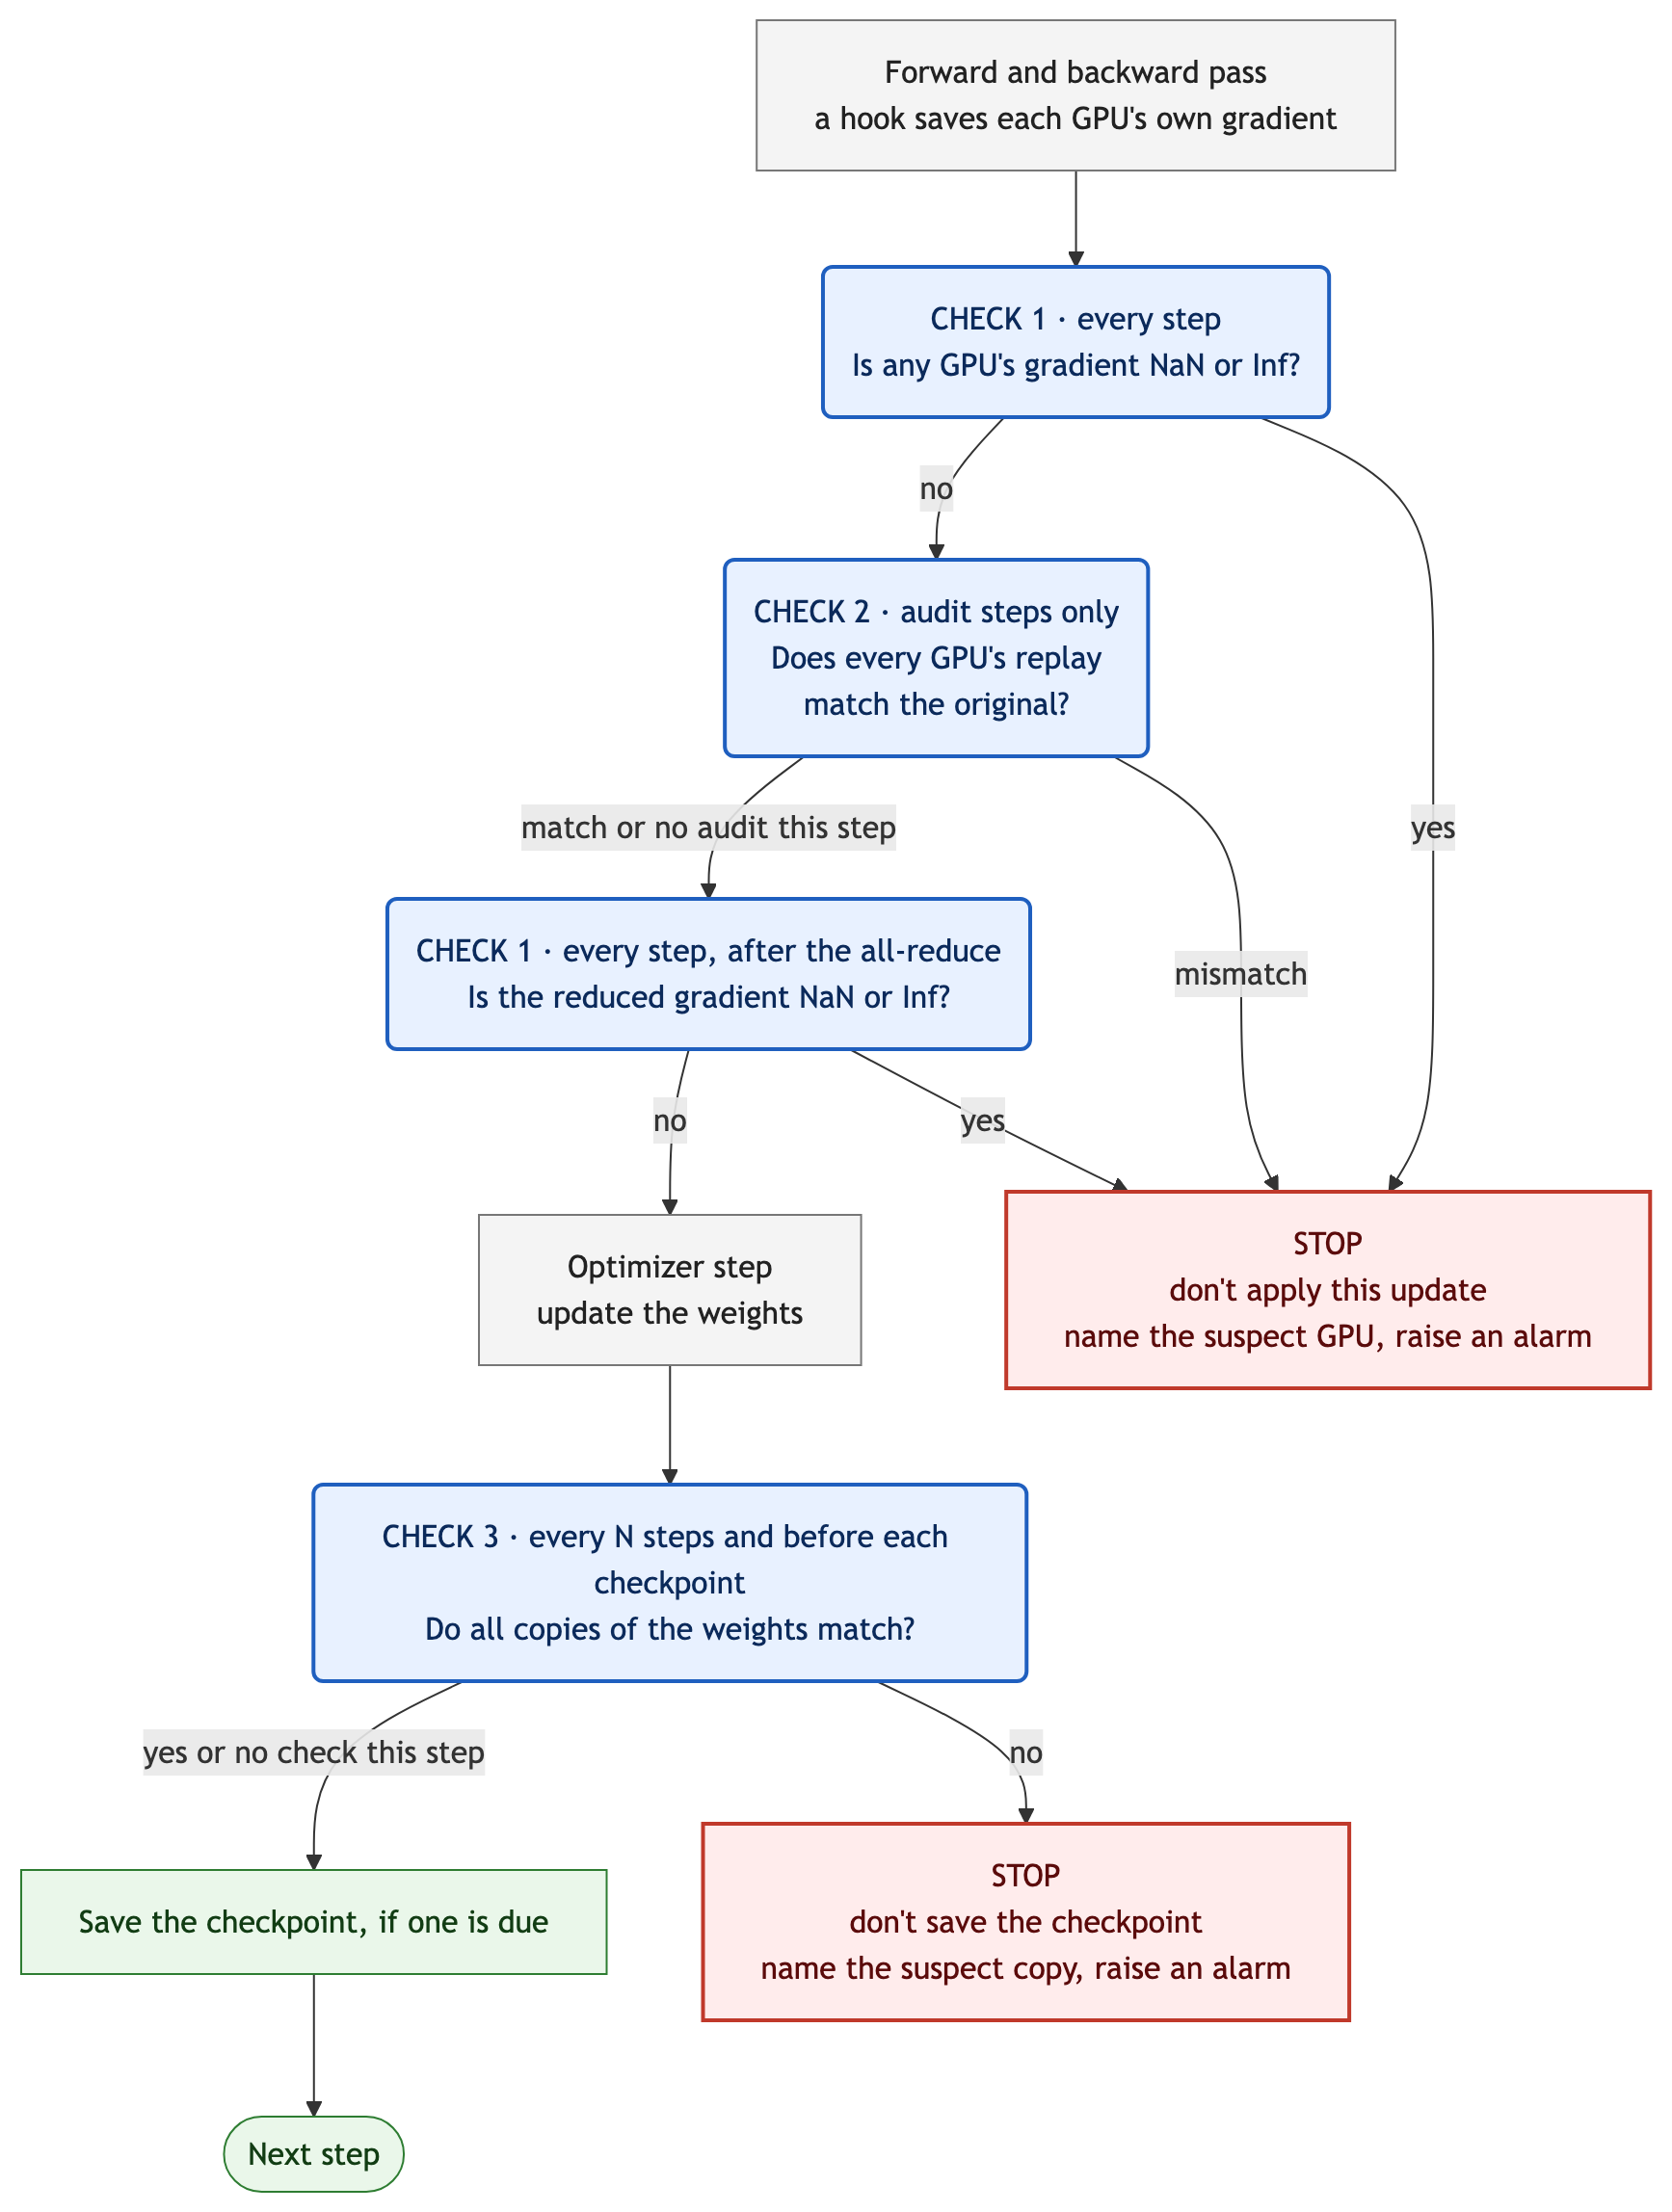
图 2:一个训练步骤的流程图。检查 1(all-reduce 前后的 NaN/Inf 梯度)和检查 2(审计步骤上的 ring replay)在优化器步骤之前运行,若触发则停止该步骤。检查 3(权重指纹)在其后运行,并阻止检查点。
为什么不比较本地梯度范数?
一个自然的初步设计(也是我们最初采用的设计)会标记出这样的 rank:其本地梯度范数与该步骤中位数之间的偏差超过 k 个中位数绝对偏差(MAD)。我们在 4 个实例上的三次无故障运行中记录了每一步每个 rank 的本地梯度范数(共 22,800 步,参见 无故障运行)在 32 块 H100 上训练一个 9.53 亿参数的模型,而该测试并不奏效:
- 健康分布的离散程度过大—— 每个 rank 看到的数据不同,因此在最初 800 步中,健康本地范数就已达到 224 MADs,而在所有健康步骤中则达到 1,240 MADs。
- 一个安静的阈值看不到任何有限的东西—— 在 k = 336(即前 800 个健康步骤中最高得分的 1.5 倍)时,它在其余 22,000 个健康步骤中触发了 11 次误报。而任何有限故障都远未接近:故障 rank 的得分从未超过 6.9,即使将一个激活值乘以 10,000 也是如此。
按指纹比对
检查 2 和检查 3 会跨 GPU 比较张量。直接发送完整张量的开销太大,因此每个张量都会被归约为一个指纹:对其原始位模式计算两个 64 位求和,一个为普通求和,另一个按位置加权。对于元素数少于 2³²、每个元素最多 4 字节的张量,只要其中一个或两个元素发生变化,指纹就会随之改变。这覆盖了我们注入的所有权重故障。理论上,更大的改动可能会相互抵消,因此指纹相同是张量相等的有力证据,而非证明。按位置加权的求和很重要:在我们的测试中,交换两个权重值并对另外两个值做补偿性改动后,普通求和保持不变,只有加权求和捕捉到了这些变化。
_INT_VIEW = {1: torch.uint8, 2: torch.int16, 4: torch.int32, 8: torch.int64}

@torch.no_grad()
def fingerprints(tensors, chunk=1 << 24):
    # ... picks the device and allocates out: one row of two int64 per tensor
    for k, t in enumerate(tensors):
        if t is None:
            continue
        bits = t.detach().contiguous().view(-1).view(_INT_VIEW[t.element_size()])
        for i in range(0, bits.numel(), chunk):  # chunked to bound temporary memory
            b = bits[i:i + chunk].to(torch.int64)
            pos = torch.arange(i + 1, i + 1 + b.numel(), dtype=torch.int64, device=dev)
            out[k, 0] += b.sum()
            out[k, 1] += (b * pos).sum()
    return out
检查 1:all-reduce 前后的 NaN/Inf 梯度
DDP 通信钩子在梯度被平均之前记录每个 rank 的本地梯度。它存储每个梯度桶的平方范数,并在确定性审计步骤中存储每个参数梯度的指纹(供检查 2 使用)。随后,它将该桶传递给 PyTorch 的标准 all-reduce。
在反向传播之后, nonfinite_ranks 从每个 rank 收集一个标量,并返回本地梯度范数为 NaN 或 Inf 的 rank。第一个被标记的 rank 就是故障 rank。如果应用了这一步,NaN 会在下一步传播到每个 rank。
def local_stats_hook(stats, bucket):
    stats.sq.append(bucket.buffer().float().pow(2).sum())
    if stats.record_fingerprints:  # per parameter, before allreduce_hook divides in place
        rows = [stats.row[p.data_ptr()] for p in bucket.parameters()]
        stats.fp[rows] = fingerprints(bucket.gradients())
    return allreduce_hook(stats.dp_group, bucket)

def attach(ddp_model, dp_group):
    stats = LocalStats(dp_group, list(ddp_model.module.parameters()))
    ddp_model.register_comm_hook(state=stats, hook=local_stats_hook)
    return stats

def nonfinite_ranks(stats):
    """After backward: global ranks whose local gradient norm is NaN or Inf."""
    local = torch.stack(stats.sq).sum().sqrt().reshape(1)
    n = dist.get_world_size(stats.dp_group)
    gathered = [torch.empty_like(local) for _ in range(n)]
    dist.all_gather(gathered, local, group=stats.dp_group)
    bad = ~torch.isfinite(torch.cat(gathered).cpu())
    return [dist.get_global_rank(stats.dp_group, r) for r in bad.nonzero().flatten().tolist()]
train() 还会在 all-reduce 之后检查梯度。在归约过程中产生的 NaN 或 Inf 会以同样的方式到达每个副本,因此各副本仍然保持一致,检查 3 也能通过。如果没有这项检查,NaN 就会变成每个副本上的 NaN 权重,而该步骤应保存的检查点也会带着这些 NaN 权重被保存,并被标记为通过。 clip_grad_norm_ 已经计算了归约后梯度的范数,因此该检查每步只增加一次单元素 all-reduce。归约过程中出现的有限误差仍能通过所有检查。
如果你使用 fp16 和梯度缩放器进行训练,请排除缩放器已经跳过的溢出步骤。bf16 没有这些步骤。
检查 2:优化器步骤之前的 ring replay
每个副本都持有相同的权重,直到 optimizer.step()因此,在反向传播与优化器步骤之间,任何 rank 都可以重新计算任何其他 rank 的微批次,而在确定性内核下,它必须得到完全相同的比特。
在审计步骤中,每个 rank 都会重新计算 rank r + 8 的微批次:向前 8 个位置,在 p5 实例上恰好相隔一个节点。它使用未包装的模块,因此不会进行任何 all-reduce,并在之后恢复梯度、模块的缓冲区以及随机数状态。无论有多少 rank 执行重放,重放都会阻塞作业,因此审计每个 rank 与审计一个 rank 所耗费的实际时间相同。随后每个 rank 都会出现在两次比较中:它自己的微批次(由对等节点重放)以及它为 s 重放的微批次 重新计算 rank 的微批次 r + 8向前 8 个位置,在 p5 实例上恰好相隔一个节点。它使用未包装的模块,因此不会进行任何 all-reduce,并在之后恢复梯度、模块的缓冲区以及随机数状态。无论有多少 rank 执行重放,重放都会阻塞作业,因此审计每个 rank 与审计一个 rank 所耗费的实际时间相同。
随后,每个 rank 都会出现在两次比较中:一次是它自己的微批次(由对等节点重放),另一次是它为其他 rank 重放的微批次。
- 两者都不匹配: 这个 rank 在两次比较中都计算错误,所以它就是罪魁祸首。
- 只有一个不匹配: 任何一方都可能是错的。
confirm它会在原地解决这个问题:目标之后八个位置的 GPU、第三个节点上的 GPU,以及目标本身,都会再次重放该目标的微批次。这也能区分持续性故障(目标能复现)和瞬态故障(目标无法复现)。
def ring_audit(module, compute_loss, rebuild_batch, step, stats, local_loss, offset, with_grads):
    # ... g is the DP group, n its size, and me this rank's position in it
    target = dist.get_global_rank(g, (me + offset) % n)
    replay = _replay(module, compute_loss, rebuild_batch(step, target), with_grads)
    # ... v = [this rank's own loss bits and gradient fingerprints, its replay of target]
    dist.all_gather_into_tensor(out, v, group=g)
    table = out.view(n, 2, -1).cpu()  # per DP rank: [own result, its replay of its target]
    pairs = [(dist.get_global_rank(g, (r + offset) % n), dist.get_global_rank(g, r))
             for r in range(n) if not torch.equal(table[(r + offset) % n, 0], table[r, 1])]
    return pairs, table

def localize(pairs):
    hits = Counter(r for p in pairs for r in p)
    culprits = sorted(r for r, c in hits.items() if c >= 2)
    ambiguous = [p for p in pairs if not set(p) & set(culprits)]
    return culprits, ambiguous

def confirm(module, compute_loss, rebuild_batch, step, pair, table, stats, offset, with_grads):
    # ... the third GPU (target + offset) and the target replay the target's micro-batch again
    third_r, self_r = v.cpu()
    orig, peer = table[ti, 0], table[ri, 1]
    if torch.equal(third_r, orig):
        return {"pair": pair, "third": third, "suspect": replayer, "kind": "replayer computed wrong"}
    if torch.equal(third_r, peer):
        kind = ("persistent" if torch.equal(self_r, orig) else
                "transient" if torch.equal(self_r, third_r) else "unclear")
        return {"pair": pair, "third": third, "suspect": target, "kind": kind}
    return {"pair": pair, "third": third, "suspect": None, "kind": "unattributable"}
只有当三块 GPU 位于三个不同节点上时,这一确认才是独立的。 check_topology 验证在训练开始前,对于每一对,从每个 pod 的 NODE_NAME,否则会报错。
选择审计模式:
- 默认内核: 仅比较损失。这需要一次损失在比特级可复现的前向传播,这在我们的测试中成立:健康重放的损失与原始损失逐比特一致。梯度无法用这种方式比较,因为注意力机制的默认反向传播不是确定性的。此模式可捕获会改变损失的前向传播故障。
- 确定性内核 (
deterministic_audits=True):整个审计步骤使用确定性算法和数学注意力内核运行。梯度指纹随后也能匹配,因此审计还能捕获仅反向传播的故障。没有确定性实现的算子会抛出错误,而不是产生误报。在我们的模型上,一次确定性审计步骤的成本是默认步骤的 2.4 倍。
绝不要只在可疑节点上重放该节点自身的工作。存在持续性缺陷的 GPU 可能会复现它自己的错误答案。
检查 3:优化器步骤之后的权重指纹
之后 optimizer.step(),每个副本的权重必须完全一致,因此没有可调的容差。每个 rank 都会为每个权重张量生成指纹,并收集所有 rank 的指纹。
只有当某个 rank 的张量副本与严格多数(即超过半数的副本)不一致时,才会点名该 rank。若只有两个副本,或分裂后不存在严格多数,比较会报告存在分歧,但不点名任何 rank。
def find_divergent_ranks(params, dp_group):
    local = fingerprints(params).flatten()
    # ... all-gathers every rank's fingerprints into table: [dp_size, num_tensors, 2]
    differs = (table != table[0]).any(dim=2).any(dim=0)
    if not differs.any():
        return {"diverged": False, "suspects": []}
    suspects = set()
    for k in differs.nonzero().flatten().tolist():
        copies = [tuple(row) for row in table[:, k].tolist()]
        value, count = Counter(copies).most_common(1)[0]
        if 2 * count <= n:
            return {"diverged": True, "suspects": None}  # no strict majority for tensor k
        suspects.update(r for r, c in enumerate(copies) if c != value)
    return {"diverged": True,
            "suspects": sorted(dist.get_global_rank(dp_group, r) for r in suspects)}
每 N 步以及每个检查点步骤都运行它。这是唯一在更新之后运行的检查,因此也是唯一能阻止从损坏副本写出检查点的检查。在我们的测试中,一次更新后立即损坏的权重在下一个检查点步骤被捕获,保存没有发生。如果没有强制检查,保存会从损坏的副本继续进行,而 ring 审计直到下一次审计(五步之后)才会发现。
在9.53亿参数模型上,每次检查耗时31.1毫秒:当每10步运行一次时,这相当于一步的2%。
将检查放入训练循环中
train 按图 2 的顺序运行每个步骤,并在第一个告警处停止。它在前向传播之前决定某一步是否为审计步骤,因为确定性比较需要原始计算也是确定性的。当检查 1 或 2 触发时,它会将梯度置零并直接返回,不进行裁剪或应用更新,因此坏梯度永远不会到达权重或优化器状态,而确切的状态仍然保留以便确认。裁剪之后,它会检查缩减后的梯度是否为 NaN 或 Inf,如果是,则在更新前返回。只有在没有任何检查触发时,它才会保存检查点。
def train(ddp_model, stats, optimizer, batches, compute_loss, rebuild_batch, save_checkpoint,
          sched, start_step=0):
    # ... setup, including check_topology(dp_group, sched.peer_offset)
    for step, batch in enumerate(batches, start_step):
        audit = step % sched.audit_every == 0  # 0. decide first
        det = audit and sched.deterministic_audits
        # ... resets the hook's per-step state
        with deterministic() if det else nullcontext():
            loss = compute_loss(ddp_model, batch)  # 1. forward, backward
            loss.backward()
        nonfinite = nonfinite_ranks(stats)  # 2. non-finite check
        pairs, table = [], None
        if audit or nonfinite:  # 3. ring replay
            pairs, table = ring_audit(module, compute_loss, rebuild_batch, step, stats,
                                      loss, sched.peer_offset, with_grads=det)
        if nonfinite or pairs:  # 4. gate
            optimizer.zero_grad(set_to_none=True)  # step not applied
            culprits, ambiguous = localize(pairs)
            verdicts = [confirm(module, compute_loss, rebuild_batch, step, p, table, stats,
                                sched.peer_offset, with_grads=det) for p in ambiguous]
            return {"step": step, "check": "compute", "nonfinite": nonfinite,
                    "mismatched_pairs": pairs, "culprits": culprits, "verdicts": verdicts,
                    "suspect_window": _window(last_audit, step, start_step),
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        if audit:
            last_audit = step
        grad_norm = torch.nn.utils.clip_grad_norm_(params, sched.max_grad_norm)
        bad = (~torch.isfinite(grad_norm)).to(torch.int32).reshape(1)  # reduced gradient
        dist.all_reduce(bad, op=dist.ReduceOp.MAX, group=dp_group)
        if bad.item():
            optimizer.zero_grad(set_to_none=True)  # step not applied
            return {"step": step, "check": "reduced gradient", "suspect_window": [step, step],
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        ckpt = step % sched.ckpt_every == 0
        if step % sched.check_every == 0 or (ckpt and sched.check_on_checkpoint):
            wc = find_divergent_ranks(params, dp_group)  # 5. weight check
            if wc["diverged"]:
                return {"step": step, "check": "weights", "suspects": wc["suspects"],
                        "suspect_window": _window(last_weights, step, start_step),
                        "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
            last_weights = step
        if ckpt:  # 6. checkpoint
            save_checkpoint(step, tags={"last_audit_pass": last_audit,
                                        "last_weight_check_pass": last_weights})
    return None
该告警的 suspect_window 是自触发该检查的上一次通过以来经过的步数范围。自启动以来每一步都处于活动状态的故障,其起始点就在该范围内。间歇性故障可能更早,而没有任何检查能发现的故障可能存在于任何检查点中,因此应将这些标签视为该步骤检查已通过的记录,而非已保存状态干净的证明。
训练脚本会这样调用它:
# ... imports, and the model, optimizer, and dataset setup
import sdc_order as S

stats = S.attach(ddp_model, dp_group)  # registers the comm hook, once
sched = S.Schedule(audit_every=10, deterministic_audits=True, check_every=10,
                   ckpt_every=100, peer_offset=8)  # 8 = GPUs per node

def compute_loss(model, batch):  # used for training AND replay
    x, y = batch
    with torch.autocast("cuda", dtype=torch.bfloat16):
        logits = model(x)
    return F.cross_entropy(logits.float().flatten(0, 1), y.flatten())

def rebuild_batch(step, rank):  # exactly the micro-batch `rank` trained on
    return dataset.micro_batch(step, rank)

# ... batches(start) yields this rank's micro-batches and sets the learning rate
alarm = S.train(ddp_model, stats, optimizer, batches(start), compute_loss, rebuild_batch,
                save_checkpoint, sched, start_step=start)
if alarm is not None:
    report_sdc(alarm)  # metric + log line; Step 2 maps the rank to a node
    sys.exit(3)
重放依赖以下几点:
- 确切的微批次:
rebuild_batch(step, rank)必须返回恰好是 rank 训练所用的那个微批次,例如来自带种子的采样器。 - 相同的损失函数:
compute_loss在训练和重放中必须是同一个函数,包括 autocast,并且其内部的任何随机性(例如 dropout)都必须按步和按 rank 设置种子。 - 模型中不存在集合通信操作或影响输出的状态: 确认重放只在两个 rank 上运行,即目标 rank 和第三个 GPU,因此如果模型在前向或反向传播中调用集合通信操作(例如 SyncBatchNorm),就会因告警含义不明确而挂起。如果某个缓冲区在前向传播中既被读取又被更新,那么健康的重放也会出现差异。
- 确定性设置: 在训练进程启动前设置,并确保模型中的每个算子都有确定性实现。
CUBLAS_WORKSPACE_CONFIG=:4096:8在训练进程启动前设置,并确保模型中的每个算子都有确定性实现。 - 对等偏移: 按节点逐个编号 DP rank,使得
peer_offset等于每个节点的 GPU 数量,就能让每个重放器都落在另一个节点上。check_topology会拒绝不符合这一要求的布局。 - 此处未测试: 未使用的参数、梯度累积、BatchNorm,以及带有副作用的前向钩子。对于未使用的参数,设置
deterministic_audits=False,它只比较损失。
audit_every 是成本与鲁棒性之间的主要权衡设置:
- 检测延迟: 一个持续存在的有限故障会被捕获在
audit_every如果它同样出现在审计所运行的内核中,则也会执行这些步骤。确定性审计运行确定性内核和数学注意力内核,因此仅局限于其他步骤所用默认内核的故障永远不会被审计。 - 损坏的更新: 最多
audit_every− 1 次损坏的更新可以在审计发现之前被应用。它们位于告警的suspect_window. - 一次性故障: 对于单个非审计步骤上不会重复出现的有限故障,则完全无法捕获。
使 ckpt_every 同时是两者的倍数 audit_every 和 check_every因此,每个检查点步骤都会在其更新前接受审计,并在更新后生成指纹。
我们在953M模型和32块H100上,针对每种调度方案,在1,000个连续步骤上端到端测量了平均步骤时间。每个带检查的调度方案还会每10步运行一次权重检查:
| 调度方案 | 平均步骤时间 | 在普通 DDP 下 |
| 普通 DDP,无检查 | 157.4 毫秒 | — |
| 检查,而非审计 | 169.0 毫秒 | +7.4% |
| 每 10 步执行一次确定性审计 | 211.9 毫秒 | +34.7% |
| 默认内核每 10 步审计一次 | 177.0 毫秒 | +12.5% |
| 每 100 步执行一次确定性审计 | +10.1% | +10.1% |
| 默认内核每 100 步审计一次 | 169.3 毫秒 | +7.6% |
每个调度方案约有7个百分点的成本不依赖于审计:梯度钩子、每一步的两次NaN/Inf检查,以及每10步一次的权重检查。生产环境的一个合理起点是每100步执行一次确定性审计,在此处成本为10%。它们仍能在100步内捕获持续存在的故障,包括仅出现在反向传播中的故障,代价是最多需要回滚99次已损坏的更新。当你需要更快检测时,例如在新容量的预热期间或监视可疑节点时,可每10步审计一次。在你自己的模型上测量成本:确定性注意力使用数学内核,其成本随序列长度的平方增长。
在 无故障运行,15,320 个审计步骤和 3,080 次权重检查均未触发告警,这将误报率限制在约每 5,100 个审计步骤 1 次(95% 置信度)。
步骤 2:将可疑 rank 定位到节点
rank 是一个逻辑 ID。要对其采取操作,你需要实例和物理 GPU。在 HyperPod EKS 上,Kubernetes 节点名称就是实例 ID 加上一个 hyperpod- 前缀。通过 Kubernetes downward API 将其传递给您的 pod:
env:
- name: NODE_NAME  # on HyperPod EKS, spec.nodeName is "hyperpod-<instance-id>"
  valueFrom:
    fieldRef:
      fieldPath: spec.nodeName
在作业启动时,记录一张表,将每个 rank 映射到其节点、实例和 GPU UUID:
import os
import torch
import torch.distributed as dist

node = os.environ["NODE_NAME"]  # "hyperpod-i-0123456789abcdef0"
instance_id = node.removeprefix("hyperpod-")  # "i-0123456789abcdef0", what the Replace API takes
gpu_uuid = "GPU-" + str(torch.cuda.get_device_properties(torch.cuda.current_device()).uuid)
info = {"rank": dist.get_rank(), "node": node,
        "instance_id": instance_id, "gpu_uuid": gpu_uuid}
table = [None] * dist.get_world_size()
dist.all_gather_object(table, info)
if dist.get_rank() == 0:
    print("rank_map", table)  # log at every job start
如果作业已经在没有 downward API 的情况下运行,你可以从外部用以下方式将 Pod 映射到其节点: kubectl get pod <pod> -o jsonpath='{.spec.nodeName}'.
步骤 3:控制损害并检查 GPU 指标
当告警触发时,先停止作业。然后在你调查期间,通过封锁节点来阻止新工作落到可疑节点上:
kubectl cordon <node-name> # marks the node unschedulable; existing pods keep running然后,在 SageMaker HyperPod 可观测性附加组件中打开 GPU 健康仪表板,筛选到可疑节点和 GPU,并查看告警触发的时间。该 GPU 上可纠正 ECC 错误、PCIe 重放、降频或温度的上升会提高硬件故障的可信度。面板干净并不能排除该节点:纯 SDC 往往不会在硬件遥测中留下任何痕迹。
步骤 4:确认,然后替换节点
在步骤1检查运行的情况下,告警已经指出了可疑的GPU。当你看到没有告警的症状(例如损失尖峰),或者想在更换任何部件之前先排除软件问题时,请从成本最低的解释入手。大多数损失尖峰并不是SDC,而在数据缺陷上追查SDC会浪费好几天:
Loss anomaly / suspected corruption
- Reproduces with the same seed on DIFFERENT nodes? -> deterministic bug, not SDC
- Goes away, or follows one node, when you move the job? -> strong SDC candidate
- DP replicas that must be bitwise identical disagree? -> strong SDC signal
- One rank's step replayed on another node gives different bits? -> strong SDC signal
- One rank's pre-all-reduce gradient is NaN or Inf? -> SDC candidate (use the first step it fired)
- Fleet-wide and gradual? -> likely recipe or optimizer
- Started at a data, config, or library change? -> usually software, but not proof
区分 SDC 与软件问题的测试在于:该问题是否跟随硬件。
- 可复现的故障并不能排除 SDC—— Meta 曾将一个失败的工作负载固定到 到一个核心上,并且对特定输入每次都得到相同的错误答案。
- 从软件变更开始的故障也同样如此—— Google 曾追踪到一起事件 ,这指向一次正确的库更新,该更新开始在有缺陷的核心上使用很少用到的指令。
- 不要指望全局损失能指向任何地方—— 前向故障首先改变故障 rank 自身的损失,随后 all-reduce 会将其梯度传播到每个副本。逐 rank 的检查与重放让你获得这种局部性。
判断告警的含义
| 告警 | 含义 | 建议操作 |
check == "weights", suspects == [r] |
更新后,rank r 的副本与严格多数不一致 | 保持对 r 节点的隔离。审查后再替换它 |
check == "weights", suspects is None |
副本之间不一致,但未形成严格多数 | 含义不明确:保持相关节点被隔离。检查 DCGM 并运行深度健康检查 |
culprits == [r] |
r 的两处 ring 比较均不匹配。这假设在相互重放的 GPU(具有相同本地索引的 GPU)中至多有一块故障 GPU。若有两块,则可将一块健康 GPU 判定为 | 保持隔离。审查后或故障再次出现后再替换 |
| 判定:持续性问题 | 目标复现了它自己的错误答案,而第三块 GPU 与重放方结果一致 | 保持隔离。审查后再替换 |
| 判定:瞬时性 | 目标的这次重试结果正确,并与第三块 GPU 的结果一致。间歇性故障可能看起来与此相同 | 保持隔离,直到以该节点为目标的审计或深度健康检查通过。如果再次发生,则替换它 |
| 判定:重放方计算错误 | 出错的是重放所用的 GPU,而不是目标 GPU | 将重放方视为可疑对象,并再次确认 |
| 非有限集合,无不匹配对 | 损失未显示的反向传播中出现 NaN 或 Inf,或梯度范数对 float32 来说过大(超过约 1.8 × 10¹⁹) | 含义不明确:以可疑对象为目标进行审计,或检查 DCGM 并运行深度健康检查 |
check == "reduced gradient" |
all-reduce 之后梯度为 NaN 或 Inf,尽管每个 rank 的本地梯度都是有限值。未指明任何 rank | 含义不明确:保持作业停止,检查 DCGM 并对作业中的每个节点运行深度健康检查,然后从告警步骤之前保存的检查点恢复 |
| 判定:无法归因或含义不明确 | 三块 GPU 对不上 | 含义不明确:检查 DCGM,并对涉及的节点运行深度健康检查 |
在生产环境中,请对每一次替换都保留人工审批,直到你有证据表明这些检查在你自己的工作负载上具有足够的精确度。像我们这样的合成测试并不能确立这一点。
确认含义不明确的告警
一个 深度健康检查 是处理含义不明确告警的主要工具。它的压力测试能捕获硬件上报的故障,而依赖数据的细微故障往往能通过测试。要在可疑的实例组上运行一次:
aws sagemaker start-cluster-health-check \
    --cluster-name <cluster-name> \
    --deep-health-check-configurations '[{"InstanceGroupName":"<instance-group>","InstanceIds":["i-0123456789abcdef0"],"DeepHealthChecks":["InstanceStress"]}]'
替换该节点
当你准备好替换节点时,有两种选择。两者都会触发相同的 SageMaker HyperPod 恢复流程,具体描述见 手动隔离、替换或重启节点.
如果开启了自动节点恢复,你可以给节点打上标签,让 SageMaker HyperPod 替换它,这便于实现自动化:
kubectl label node <node-name> \
    sagemaker.amazonaws.com/node-health-status=UnschedulablePendingReplacement --overwrite
要改用 API,请运行:
aws sagemaker batch-replace-cluster-nodes --cluster-name <cluster-name> --node-ids <instance-id>在使用 Karpenter 进行自动扩缩的集群上, BatchReplaceClusterNodes 会终止该节点,但仅在待处理的 Pod 需要时才创建替代节点。替代节点加入后,训练作业会通过 SageMaker HyperPod 训练操作器或作业的重启策略重新启动,你的训练脚本会从告警发生前保存的最新检查点恢复运行。 suspect_window 开始。调用 find_divergent_ranks 在加载后立即执行,在第一步之前。替换会销毁节点的根卷和辅助卷,因此请将检查点保存在共享存储上。
自动化工作流
手动步骤仅用于理解。在生产环境中,请将它们封装在一个运行于你自己的集群和账户中的小型控制器里:
- 触发: 训练作业会通过 Kubernetes 事件、一个小型自定义资源(例如 SDCReport{rank, job, step, check}),或针对相关指标的 Amazon CloudWatch 告警来报告该告警,这些指标包括
sdc_nonfinite_grad,sdc_replay_mismatch,以及sdc_divergent_tensors. - 解决: 控制器通过 Kubernetes API 将 rank 映射到 pod,再映射到节点,然后通过剥离前缀将节点映射到实例 ID。
hyperpod-前缀。 - 包含: 它会隔离该节点。
- 决定: 它应用第 4 步中的表格。ring 审计已确认存在含义不明确的配对,因此告警会携带判定结果。对于含义不明确的结果,它会运行一次节点范围的深度健康检查。
- 恢复: 作为替代方案,它请求人工批准,然后调用
BatchReplaceClusterNodes,或者在开启自动节点恢复时设置节点健康标签。然后它依赖训练操作器和你的检查点重新加载,并将每一步记录到 CloudWatch 中。
将其构建为轻量级 Kubernetes operator,或构建为针对 CloudWatch 告警的 Amazon EventBridge 规则,由该规则调用 AWS Lambda 函数。
用例:在 SageMaker HyperPod 上测试这些检查
我们在一个由 Amazon EKS 编排的 SageMaker HyperPod 集群上运行了两次测试,先后使用 4 台和 3 台 ml.p5.48xlarge 实例,每台配备 8 块 NVIDIA H100 80GB HBM3 GPU,并使用来自 AWS Deep Learning Containers 训练镜像的 PyTorch 2.9.0(CUDA 13.0)。模型是一个 9.53 亿参数的 Llama 风格解码器,具有 16 层、隐藏维度 2,048、16 个注意力头、32,000 词表以及 2,048 token 的序列长度。每块 GPU 每步处理 2 个序列(32 块 GPU 上每步 131,072 个 token),权重、梯度和优化器状态使用 fp32,计算使用 bf16 自动混合精度。我们使用 AdamW 训练,学习率为 3 × 10⁻⁴,先进行 100 步线性预热,betas 为 (0.9, 0.95),权重衰减为 0.1,梯度裁剪阈值为 1.0。数据是合成的:一个复制任务,token 服从 Zipf 分布,其前半部分重复,并按 rank 和 step 设置随机种子,以便任何微批次都可以重建。
故障场景
故障被注入到一层中,即 16 个解码器块中第 8 个块的 MLP 下投影,并注入到选定的 rank 和 step 上:
- 前向故障 会改变该层的输出,但保留其梯度路径,就像前向传播中一次错误的乘法。
- 仅反向故障 会改变该层输入或权重的梯度。
- 权重故障 在优化器步骤之后立即更改一块 GPU 上存储权重的副本:翻转一个比特、交换两个值,或对两个值做补偿性修改。
- 一个 持久性 故障会在这块故障 GPU 计算的所有内容中反复出现,包括它为其他 rank 运行的 replay。 瞬时 故障只触发一次。
每个场景都从经过 400 步预热后拍摄的快照重新开始,步数从该快照起算。除非另有说明,审计每 10 步运行一次并使用确定性内核,权重检查每 10 步一次,检查点每 20 步一次。表中展示了 4 个实例的结果。在 3 个实例上,每个场景都在同一步、由同一项检查、以相同的 rank 名称触发了相同的告警。只有对等 rank 发生了变化。
| 注入故障 | 结果 | 被捕获于 |
| 仅在第 25 步(非审计步)rank 13 的前向输出中有一个元素出现 NaN | 在第 25 步触发,并点名 rank 13。ring replay 也运行了。由 rank 21 和 rank 13 确认: rank 13 上的瞬时故障第 25 步未被应用。可疑窗口:第 21–25 步 | 检查 1 |
| 第 23 步起每一步中,rank 13 前向输出的一个元素乘以 1,000 | 第 23–29 步通过了检查 1 并被应用。第 30 步的审计出现不匹配:(13, 5) 和 (21, 13),并点名 rank 13。第 30 步未被应用。可疑窗口:第 21–30 步 | 检查 2 |
| 仅在第 30 步审计时,同样的 ×1,000 | 一对不匹配,(13, 5)。由第三个节点上的 rank 21 以及 rank 13 确认: rank 13 上的瞬时故障 | 检查 2 |
| 第 5 个 rank 上持续存在的 ×1,000 故障,它会重放第 13 个 rank 的微批次 | (13, 5) 与 (5, 29) 不匹配。点名 rank 5。由 rank 5 对 rank 13 进行一次重放,本会归咎于健康的 rank 13 | 检查 2 |
| 第 13 个 rank 上的其他前向故障,从第 23 步起每一步:一个元素 ×10,000,整个输出上 10% 的乘性噪声,一个 bf16 元素中第 3 位翻转,以及一个输出列 ×1.1 | 第 30 步时每个被点名的 rank 13。位翻转和 ×1.1 列也通过默认内核审计被捕获 | 检查 2 |
| 流入 rank 13 层梯度的一个元素,或其权重梯度的一个元素,×1,000,从第 23 步起每一步(仅反向) | 在第 30 步,仅凭梯度指纹就点名了每个 rank 13 | 检查 2 |
| 上述权重梯度故障,采用默认内核审计 | 50 步内无告警。 第 20 步和第 40 步的检查点被标记为通过了审计和权重检查,因为损失未受影响,而且每个副本都应用了相同的损坏更新 | 未捕获 |
| 同时在第 13 和第 22 个 rank 上持续存在的 ×1,000 前向故障 | 配对 (13, 5)、(21, 13)、(22, 14) 和 (30, 22) 不匹配。被点名的 rank 为 13 和 22 | 检查 2 |
| 在第 31 步更新后,rank 0 上的一个 fp32 权重元素中第 22 位发生翻转,每 5 步保存一次检查点 | 第 35 步检查点的强制权重检查点名了 rank 0,而保存并未发生。可疑窗口:第 31–35 步 | 检查 3 |
同样地,使用 check_on_checkpoint=False |
第 35 步的保存是从 rank 0 的损坏副本继续进行的。 其标签显示,最后一次通过的权重检查发生在第 30 步。ring 审计在第 40 步点名了 rank 0,依据是配对 (8, 0) 和 (0, 24)。 | 检查 2 |
| 在一个权重张量中交换了两个值,或对两个值的位模式分别加上 +4,096 和 −4,096,发生在 rank 0 上第 31 步更新之后,且没有审计,权重检查每 10 步一次 | 在第 40 步权重检查时,每个被点名的 rank 均为 0,尽管该张量的普通位和并未发生变化 | 检查 3 |
| 在恢复快照(相当于加载检查点)之后,rank 7 上的一个注意力权重中第 22 位发生了翻转 | find_divergent_ranks,在第一步之前运行,命名为 rank 7 |
检查 3 |
无故障运行
为了衡量误报情况,我们在两种集群规模上都在无故障条件下进行了训练,每种规模各采用三种调度方案。每个调度方案每 10 步执行一次权重检查,且不保存检查点;每次运行的时长以分钟为单位固定,因此每步都进行审计的两种调度方案贡献了大部分审计步数:
| 实例 | 审计 | 分钟 | 步骤 | 审计步骤 | 权重检查 | 警报 |
| 4 | 确定性,每一步 | 45 | 4,600 | 4,600 | 460 | 0 |
| 4 | 默认内核,每一步 | 22.5 | 5,400 | 5,400 | 540 | 0 |
| 4 | 确定性,每 10 步 | 45 | 12,800 | 1,280 | 1,280 | 0 |
| 3 | 确定性,每一步 | 15 | 1,600 | 1,600 | 160 | 0 |
| 3 | 默认内核,每一步 | 7.5 | 2,000 | 2,000 | 200 | 0 |
| 3 | 确定性,每 10 步 | 15 | 4,400 | 440 | 440 | 0 |
| 总计 | 150 | 30,800 | 15,320 | 3,080 | 0 |
在 15,320 个审计步骤中出现了 0 次警报,根据“三法则”,每次审计步骤的误报率 95% 置信上限为 3 / 15,320,约为 1/5,100。NaN/Inf 检查在任何无故障步骤上也均未触发。梯度范数分析在 为什么不比较局部梯度范数? 仅使用 4 实例运行。
超越 DDP
权重比对并不局限于 DDP。 find_divergent_ranks 它可以适用于任何数据并行组,因此也适用于张量并行、流水线并行和上下文并行、HSDP 以及专家混合,这些都是为每个权重保留独立副本的布局。在 ZeRO-1 或完全 FSDP 分片下它无法提供帮助,因为在这些情况下,每个分片的更新只在一个 rank 上计算。我们在本文中仅使用 DDP 测试了这些检查和训练循环。
要在另一种布局中使用它,请调用 find_divergent_ranks 与持有同一分片副本的组一起。只有两个副本时,它可以检测到不一致,但无法指出哪个副本有故障。
如果你更希望由服务来替你检查节点,SageMaker HyperPod 还提供 MultiNodeTraining 深度健康检查。它会在一批 GPU 节点上运行一个简短、固定的分布式训练作业,无需修改代码,并会替换那些训练损失变为 NaN 或 Inf、发散或未能按时完成的节点。在创建实例组时,你可以将其与 InstanceStress 和 InstanceConnectivity 一起选择,也可以按需运行它,使用 StartClusterHealthCheck它补充了本文中的检查:在作业落到新节点和替换节点上之前,先用它来筛查这些节点;而作业内检查则用于捕获你自己训练中那些从未变成 NaN 或 Inf 的错误数值。详情请访问 SageMaker HyperPod 深度健康检查.
清理
为避免持续产生费用,请删除你为测试而创建的资源。如果你创建了 HyperPod 集群,请使用以下命令将其删除: aws sagemaker delete-cluster --cluster-name <cluster-name>这只会删除 HyperPod 资源。请在删除 HyperPod 集群之后,单独删除 EKS 集群、其附加组件以及所有 Amazon FSx 卷。请参阅 删除 SageMaker HyperPod 集群.
结论
在本文中,我们展示了如何检测数据并行训练中的静默数据损坏,以及如何将可疑节点交给 SageMaker HyperPod 进行替换。三项检查覆盖了故障可能出现的三个位置:对每个 rank 的梯度以及归约后的梯度进行 NaN/Inf 检查;通过 ring replay 将每块 GPU 的计算与另一节点上的 GPU 进行比对;以及在更新后比较权重指纹。在优化器步骤之前运行前两项检查,不要应用未通过检查的步骤,并在每次检查点之前比较权重。SageMaker HyperPod EKS 集群上的节点名称可将可疑 rank 转换为实例 ID。然后隔离该节点,回滚到可疑窗口之前的检查点,并让节点健康标签或 Replace API 完成恢复。
首先,请查看 适用于 Amazon EKS 的 SageMaker HyperPod 弹性功能,并尝试使用 配套仓库。如需深入了解,请参阅 深度健康检查 以及 可观测性附加组件.