人工智能
GS Caltex 借助 Amazon SageMaker Canvas 实现生产级 MLOps,第 1 部分GS Caltex 使用 Amazon SageMaker Canvas 和 Amazon SageMaker Pipelines 将流程工程师的模型连接到生产工作流。这家韩国能源与化工公司将模型开发与运维工作分配给具备互补技能的工程师。
流程工程师无需编写代码,即可在 SageMaker Canvas 中基于自身的工艺知识构建并验证模型。机器学习(ML)工程师则配置 SageMaker Pipelines 工作流,用于部署和定时推理。
将资产从 SageMaker Canvas 迁移到 SageMaker Pipelines 仍需要集成工作。ML 工程师必须为生产环境设置数据路径、提供模型配置,并连接预处理作业与推理作业。GS Caltex 在复用 SageMaker Canvas 中所创建资产的同时,实现了这一交接流程的自动化。
GS Caltex 表示,其 ML 工程师现在可以在几小时内完成模型部署,而此前大约需要一周。该公司每 30 分钟运行一次批量推理,从而减少了对持续运行端点的需求。GS Caltex 表示,这已显著降低了其推理成本。
本文介绍 GS Caltex 如何将 SageMaker Canvas 连接到 SageMaker Pipelines,并在生产环境中复用经过验证的预处理流程和模型。
解决方案概述
机器学习运维(MLOps)工作流包含两条路径:为新模型版本做好部署准备,以及使用已部署的模型运行批量推理。
从经过验证的模型到可重复的工作流
您可以使用 SageMaker Canvas 以可视化方式准备数据、构建模型并生成批量预测。您还可以从 SageMaker Canvas 将经过验证的模型注册到 Amazon SageMaker Model Registry。GS Caltex 构建了一套独立的交接流程,将这些资产转化为可执行的 SageMaker Pipelines 步骤。
流程工程师了解工艺背后的变量和数据,并评估模型的预测是否有用。ML 工程师则将生成的资产转化为生产作业,并管理模型版本和执行历史记录。
| 领域 | 在 SageMaker Canvas 中准备的内容 | 在生产工作流中管理的内容 |
| 数据准备 | 使用 Data Wrangler 构建的预处理流程 | Amazon SageMaker Processing 中的预处理作业 |
| 模型开发 | 已训练的模型和评估结果 | Model Registry 中的模型版本和审批状态 |
| 预测 | 对模型预测的验证 | 使用已批准模型每 30 分钟进行一次批量推理 |
| 运维 | 单个模型的开发和验证 | 步骤执行历史记录、存储的结果和故障处理 |
参考架构
下图展示了流程工程师如何将 SageMaker Canvas 资产交接给 ML 工程师,用于部署和定时推理。ML 工程师使用 Amazon Simple Storage Service(Amazon S3)存放预处理流程,使用 Model Registry 管理模型版本,然后通过 Amazon EventBridge 调度管道运行。
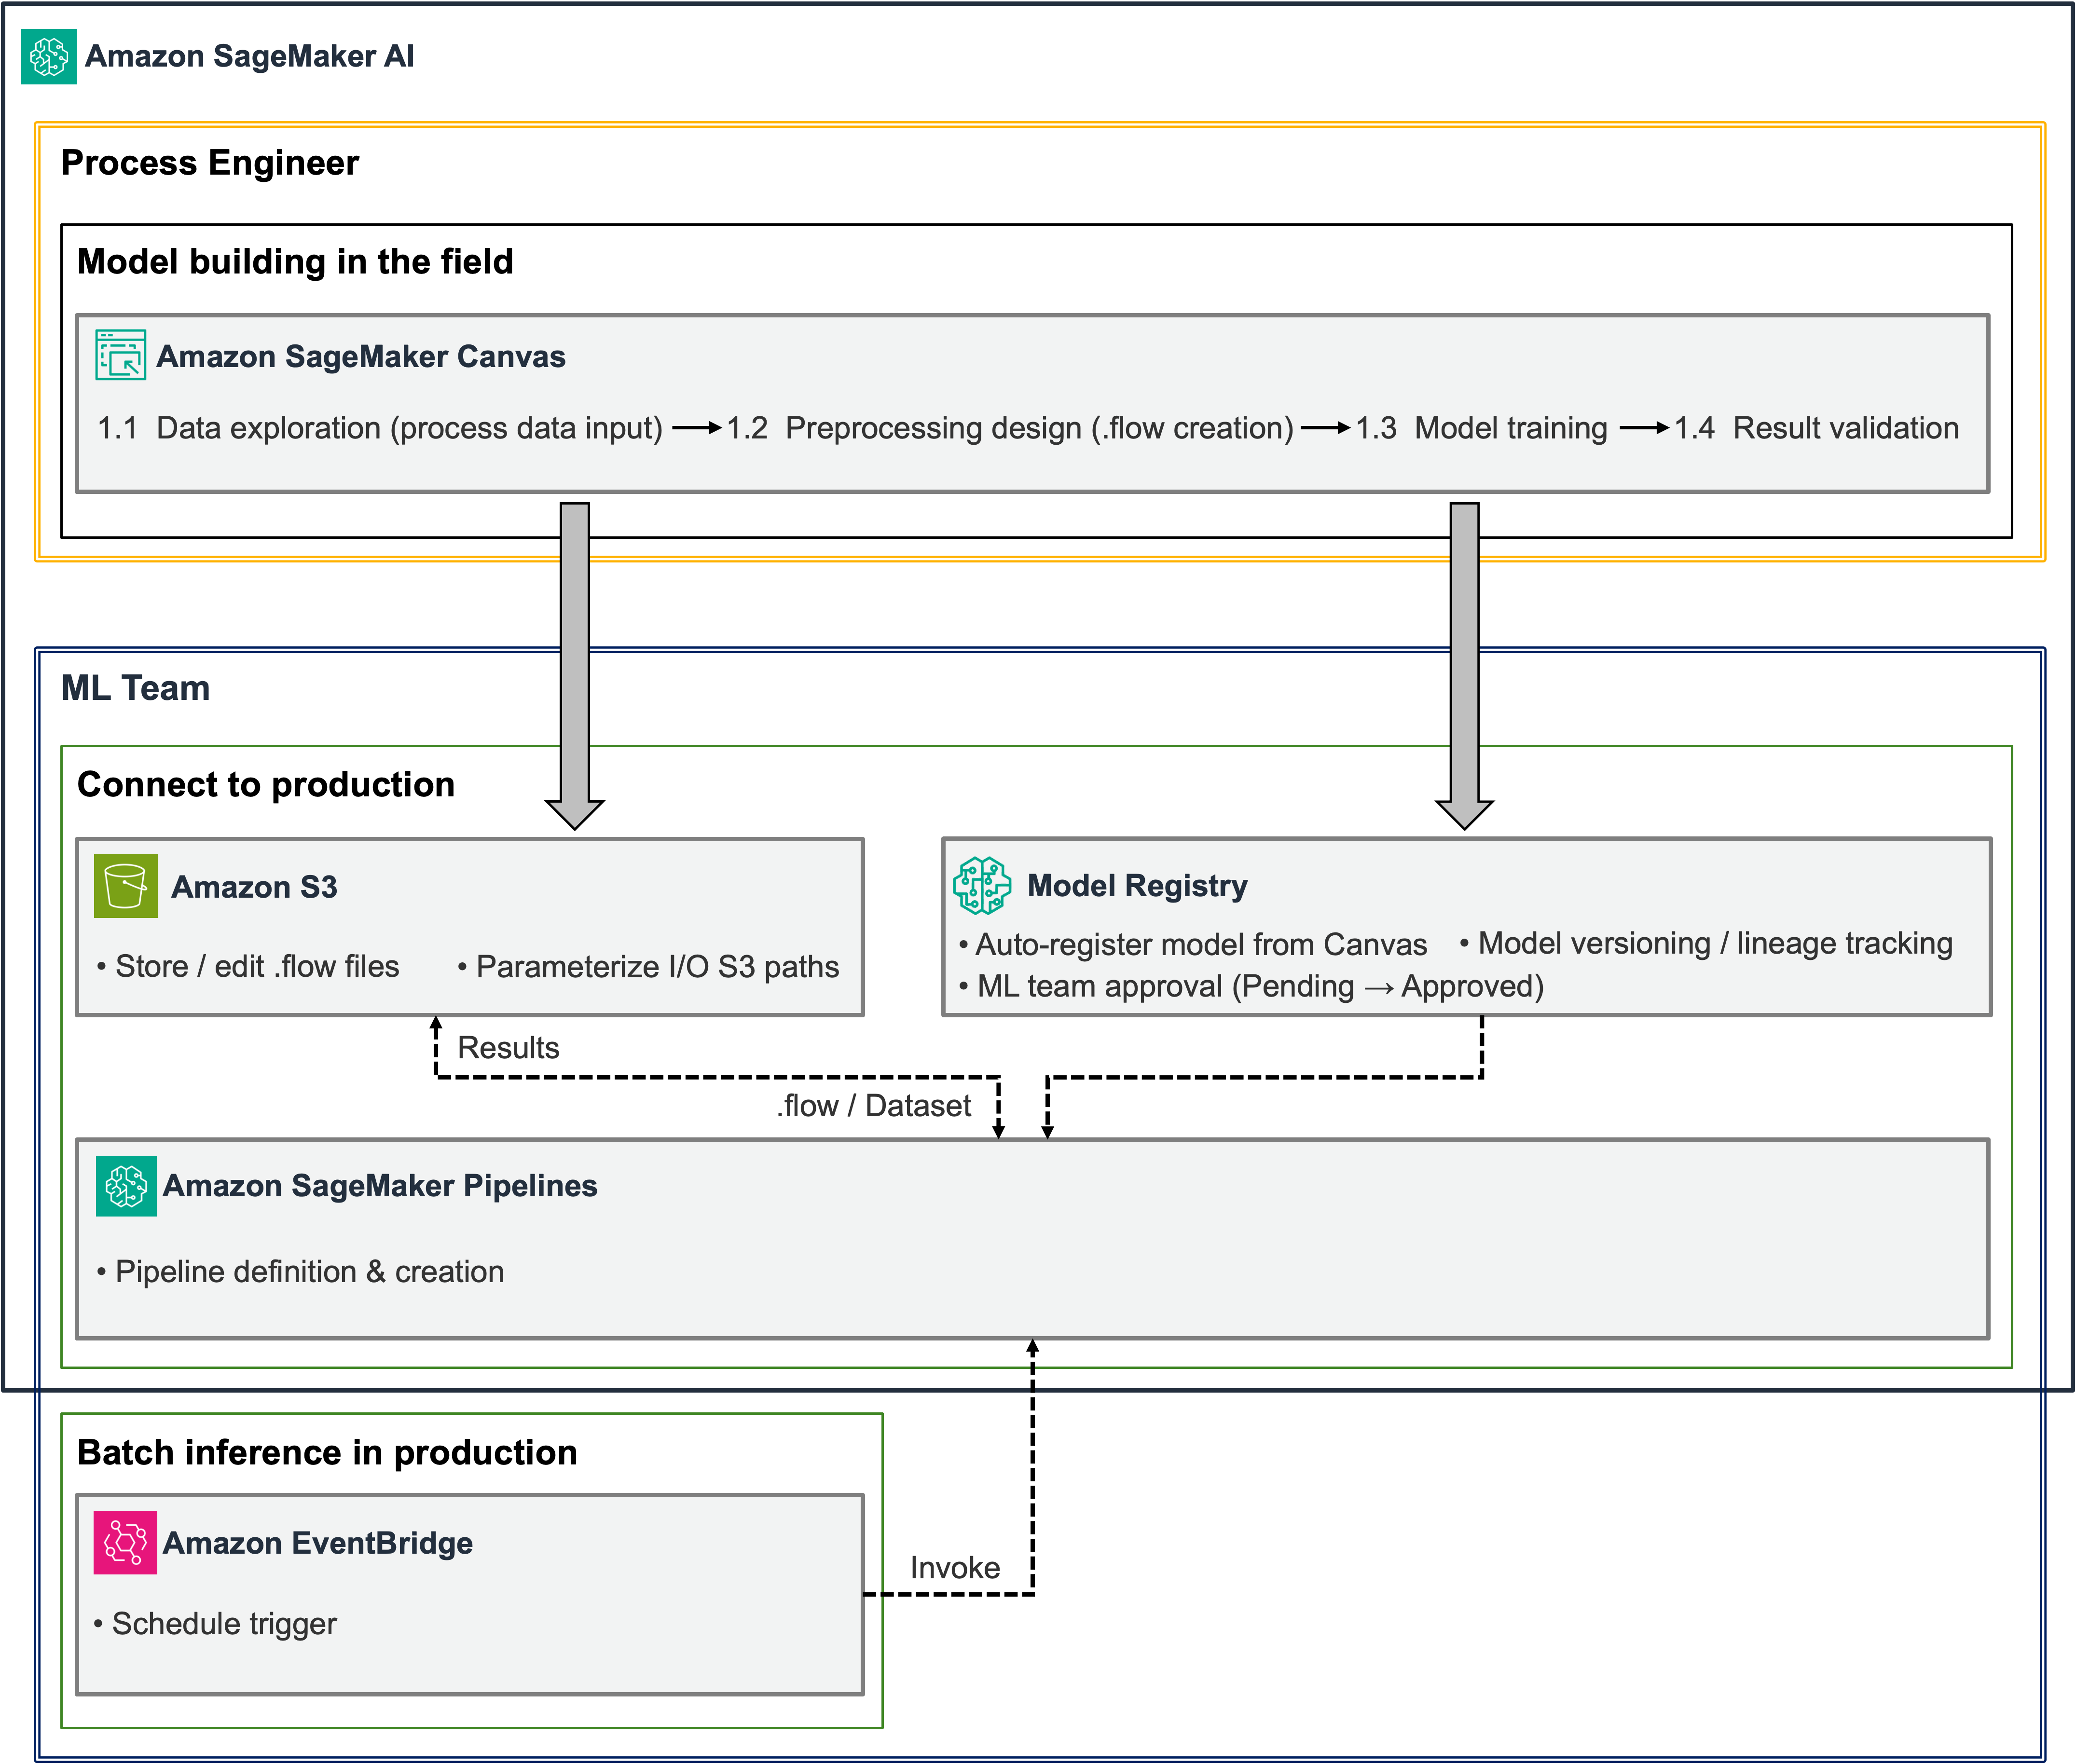
图 1:SageMaker Canvas 资产连接到 SageMaker Pipelines 工作流,用于定时批量推理
ML 工程师从 SageMaker Canvas 接收预处理流程和模型,并审查数据格式和预测结果。审查完成后,他们在 Model Registry 中批准该模型并进行部署。这一准备工作在部署新模型版本时进行。后续的推理运行会复用已部署的模型。
Amazon EventBridge 启动每次定时运行。SageMaker Pipelines 从 Amazon Simple Storage Service(Amazon S3)准备输入数据,运行预处理和 SageMaker Batch Transform, 并将结果存储到 S3。ML 工程师可以查看步骤状态和 Amazon CloudWatch 日志来监控工作流。
生产管道复用 SageMaker Canvas 中创建的预处理逻辑和已训练模型。ML 工程师配置输入和输出路径、设置执行顺序,并编写将审批和调度连接到工作流的代码。
先决条件
开始之前,请准备以下内容:
- 在 SageMaker Canvas 中构建并评估的 模型, 以及其 Data Wrangler 预处理流程
- 用于推理的 CSV 数据,以及用于存储文件的 S3 存储桶。
- 一个 SageMaker 执行角色 和一个 具有启动管道权限的 Amazon EventBridge 角色
- 已安装 Boto3 和 SageMaker Python SDK 2.x 的 Python 环境。
完整的参考实现可在 GitHub 仓库中获取。本文中的代码示例侧重于各组件之间的连接。该仓库使用一个示例贷款分类模型,因此请调整配置以匹配您模型的输入和输出格式。
技术实现
以下步骤涵盖预处理复用、模型审批与部署、管道构建以及定时推理。
1. 使用 SageMaker Processing 运行 SageMaker Canvas 预处理流程
在 SageMaker Canvas 中使用 Data Wrangler 创建的预处理流程会记录数据源和转换步骤。要设置参考实现,请使用 SageMaker Processing 将数据导出到 Amazon S3 , 然后检索作业设置以及该作业使用的 .flow 文件。
在导出设置中,关闭 自动作业配置 并选择 SageMaker Processing. 导出开始后,在 Amazon SageMaker AI 控制台上打开 Processing 作业详情。记录容器镜像 URI、名为 flow, 的输入的 S3 URI、执行角色以及输出设置。使用这些值配置运行 .flow 文件的管道步骤。
SageMaker 执行角色必须具有读取所需 S3 数据、写入结果以及访问容器镜像的权限。根据需要处理的数据量选择实例类型和数量。
保留流程工程师验证过的预处理逻辑,并针对生产环境调整数据源、路径和其他设置。对照原始作业配置检查容器镜像和输出节点。
| 检查项 | 操作 |
| 输入位置 | 检查数据源在 .flow 文件中引用的 S3 URI。将原始数据上传到其他位置不会更新此引用。 |
| 容器镜像 | 使用在 S3 导出期间创建的 Processing 作业中的镜像,并固定一个能够复现已验证转换的版本。 |
| 输出 ID | 使用导出配置中的输出节点和输出名称。如果所需格式为 {node_id}.{output_name}, 则完全匹配。 |
| 学习到的转换值 | 保留训练期间学习到的值,例如缩放和编码参数。不要在每次推理批次中重新拟合这些值。 |
| 验证 | 比较 SageMaker Canvas 和 Processing 对相同输入生成的列、数据类型和转换值。 |
某些 .flow 文件包含执行元数据,例如 internal_metadata.dw_job.container_uri。请检查实际的 Processing 作业设置,而不是假设每个导出都包含此字段。如果将工作流迁移到其他 AWS 区域,请验证容器镜像在该区域是否可用。
参考实现通过 runs/<execution-id>/下的执行来区分中间输出和最终输出。其 PrepareInput 步骤将数据写入 .flow 文件引用的固定 S3 位置。防止共享该输入路径的执行发生重叠。
为了也为每次执行隔离输入数据,请添加一个准备步骤,在 .flow 文件的副本中更新源 URI。声明 SageMaker Pipelines 参数并不会自动替换文件内的 URI。
2. 处理训练输入与推理输入之间的差异
目标列是训练数据和推理数据之间的一个差异。使用训练数据构建的流程可能包含期望输入架构中存在目标列的转换。推理数据不包含该已知结果。
参考实现在预处理之前添加了一个 PrepareInput 步骤。如果缺少目标列,此步骤会用一个占位值添加它。预处理之后, DropTargetColumn 会移除该列。使占位符的数据类型和列位置与训练架构匹配,并仅按原始顺序将预期特征传递给模型。
PrepareInput -> PreprocessNewData -> DropTargetColumn
             -> BatchPredict -> AssembleResults
仅当占位目标不影响特征值时,才使用此方法。如果流程按目标筛选行、从目标派生特征或应用目标编码,则需要额外处理。在这些情况下,请分离推理所需的转换和学习状态。
验证应涵盖列顺序和数量、数据类型、缺失值处理以及行数。移除目标后,检查剩余列是否与训练期间使用的特征顺序匹配。
3. 注册、审批并部署模型
在 Model Registry中注册已验证的 SageMaker Canvas 模型版本。注册的版本可以包含模型文件、推理配置和评估结果。ML 工程师在更改审批状态之前会审查此信息。
模型文件(例如 model.tar.gz) 必须与正确的推理容器和环境设置一起使用。Model Registry 中的模型包会将这些信息组合在一起。在此批处理架构中,部署会从已批准的包创建 SageMaker 模型资源,供 Batch Transform 引用。
以下示例检查已批准的包,然后创建模型资源。在部署期间提供 model_package_arn, model_name, 和 sagemaker_role_arn 。此示例为每个版本使用唯一的模型名称。
import boto3

sm_client = boto3.client("sagemaker")
package = sm_client.describe_model_package(
    ModelPackageName=model_package_arn
)

if package["ModelPackageStatus"] != "Completed":
    raise RuntimeError("Model package is not ready")
if package["ModelApprovalStatus"] != "Approved":
    raise RuntimeError("Model package is not approved")

sm_client.create_model(
    ModelName=model_name,
    ExecutionRoleArn=sagemaker_role_arn,
    PrimaryContainer={"ModelPackageName": model_package_arn},
)
Model Registry 记录审批状态,但不会对每个推理请求强制执行审批检查。请在部署代码中检查该状态,并在管道配置中保留所选包 ARN 和模型名称。如果审批被撤销,请更新使用该模型的计划和执行配置。
注册和部署在模型版本发布时进行。每 30 分钟运行的管道使用该模型创建 Batch Transform 作业,因此无需在每次运行时重新注册模型。
4. 连接预处理、推理和结果组装
推理管道包含五个步骤。
| 步骤 | 功能 | 输入和输出 |
PrepareInput |
如有需要,添加占位目标列 | 新的推理数据 -> 已提供目标列的数据 |
PreprocessNewData |
运行 SageMaker Canvas 预处理流程 | 准备好的输入和 .flow -> 转换后的数据 |
DropTargetColumn |
移除目标列和 CSV 表头 | 转换后的数据 -> 不带表头的特征 CSV |
BatchPredict |
使用已批准的模型运行批量推理 | 特征 CSV -> 预测文件 |
AssembleResults |
将预处理数据与预测结果合并 | 预处理数据和预测文件 -> 最终结果 CSV |
在连接步骤之前配置每个作业。在以下示例中, prepare_args, preprocess_args, drop_target_args, 和 assemble_args 保存由使用 run() 的处理器上的 PipelineSession调用返回的步骤参数。处理器和 transformer 共享 pipeline_session 对象。使用先前部署的 transformer 配置 model_name.
from sagemaker.workflow.pipeline import Pipeline
from sagemaker.workflow.steps import ProcessingStep, TransformStep

prepare = ProcessingStep(
    name="PrepareInput", step_args=prepare_args
)
preprocess = ProcessingStep(
    name="PreprocessNewData",
    step_args=preprocess_args,
    depends_on=[prepare],
)
drop_target = ProcessingStep(
    name="DropTargetColumn",
    step_args=drop_target_args,
    depends_on=[preprocess],
)

# The DropTargetColumn job defines an output named "features".
features_uri = (
    drop_target.properties.ProcessingOutputConfig
    .Outputs["features"].S3Output.S3Uri
)
predict = TransformStep(
    name="BatchPredict",
    step_args=transformer.transform(
        data=features_uri,
        content_type="text/csv",
        split_type="Line",
    ),
)
assemble = ProcessingStep(
    name="AssembleResults",
    step_args=assemble_args,
    depends_on=[predict],
)

pipeline = Pipeline(
    name="canvas-process-inference",
    steps=[prepare, preprocess, drop_target, predict, assemble],
    sagemaker_session=pipeline_session,
)
pipeline_arn = pipeline.upsert(role_arn=sagemaker_role_arn)["PipelineArn"]
以下执行图展示了示例贷款模型推理工作流中的五个步骤。它们准备输入、应用预处理、移除目标列、运行批量推理并组装结果。截取此屏幕截图时,执行处于 Executing 状态。
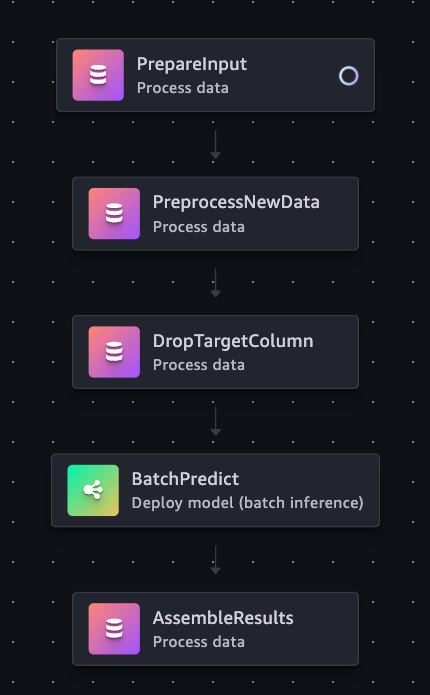
图 2:示例贷款模型的 SageMaker Pipelines 执行图
使用 depends_on 控制执行顺序,并通过步骤输出属性传递数据。例如, assemble_args 必须接收预处理数据的位置和 predict.properties.TransformOutput.S3OutputPath。输出名称 "features" 属于 DropTargetColumn。Data Wrangler 步骤使用其预处理流程中定义的输出 ID。
在参考实现中, AssembleResults 按行位置合并预处理数据和预测结果。在生产环境中使用之前,请添加检查以确保文件顺序和行数匹配,如果不匹配则停止生成结果。如果预处理对行进行排序或移除,请维护源记录 ID 与预测之间的显式映射。
5. 每 30 分钟调度一次推理
GS Caltex 每 30 分钟运行一次推理。以下示例使用 Amazon EventBridge 规则来调度 SageMaker Pipelines 执行先创建管道,并在附加计划前通过手动运行进行验证。
import boto3

events_client = boto3.client("events")
rule_name = "canvas-process-inference-every-30-minutes"

events_client.put_rule(
    Name=rule_name,
    ScheduleExpression="rate(30 minutes)",
    State="ENABLED",
)

result = events_client.put_targets(
    Rule=rule_name,
    Targets=[{
        "Id": "canvas-process-inference",
        "Arn": pipeline_arn,
        "RoleArn": eventbridge_role_arn,
    }],
)
if result["FailedEntryCount"]:
    raise RuntimeError(result["FailedEntries"])
将 eventbridge_role_arn 设置为信任 Amazon EventBridge 服务主体的角色, events.amazonaws.com,并具有目标管道的 sagemaker:StartPipelineExecution 权限。 pipeline_arn 值标识上一步中创建的管道。
表达式 rate(30 minutes) 将运行调度为每 30 分钟一次。要在整点和半点运行,请使用 cron(0/30 * * * ? *)。在输入准备步骤中决定每次运行处理哪个数据窗口,并将其与执行一起记录。
运维注意事项
在启用计划运行之前,请检查总成本、执行时间以及对无效或不匹配数据的处理。
评估整个工作流的批处理成本
Amazon SageMaker Pipelines 是一种无服务器工作流编排服务。它管理执行顺序和依赖关系,无需你预置或维护工作流服务器。处理作业和批量转换作业使用单独的计算资源,并根据实例类型和持续时间计费。
预置的实时端点非常适合需要持续低延迟响应的请求。批量转换适合可以一起处理一组记录的工作负载。作业完成后会释放作业的计算资源,因此你可以运行预测,而无需为每个模型持续保持推理端点运行。
| 考虑因素 | 预置实时端点 | 使用批量转换的 SageMaker Pipelines |
| 资源生命周期 | 实例保持可用以处理请求 | 为每个作业预置和释放资源 |
| 成本驱动因素 | 端点正常运行时间和容量 | 作业持续时间、频率、实例数量和支持服务 |
| 适用工作负载 | 即时响应和持续的在线请求 | 按计划间隔处理累积数据 |
| 添加模型 | 端点容量和持续托管成本 | 额外的处理、作业持续时间和并发限制 |
30 分钟的计划每天会产生 48 次计划运行。估算总运行时间时,请包括预处理、实例启动、推理和后处理。成本比较还应考虑工作流使用的处理、S3、CloudWatch 和其他服务。
使用每个工作负载的实测用量来评估其成本,包括支持服务和每个计划作业的完整运行时间。
检查运行时间和重叠执行
每 30 分钟启动一次运行的计划并不保证每次运行都能在该间隔内完成。使用代表性数据测量完整管道运行时间,包括实例启动和重试失败作业所需的时间。
决定如何处理在上一次执行完成之前到达的计划运行。控制管道内的并行步骤并不能防止不同的管道执行重叠。检查活动执行,防止对同一输入窗口进行重复处理,并为每次运行分离输出路径。
记录每次运行的输入数据窗口、预处理流程版本、模型包 ARN、管道执行 ARN 和输出位置。这些详细信息有助于复现结果和调查错误。
验证输出和失败行为
在启用计划之前,请完成以下检查:
- 通过 SageMaker Canvas 和处理运行验证数据集。比较输出列、数据类型、行数和关键转换值。
- 检查添加占位目标不会改变特征值,并且目标已从模型输入中移除。
- 使用已批准的模型版本运行批量转换,并验证源记录与预测之间的关联。
- 确认无效的输入架构或预处理失败会阻止下游推理和结果发布。
- 测量运行时间和成本,测试重叠执行和同一输入窗口的重新处理,然后启用 30 分钟计划。
为作业失败和处理延迟添加 CloudWatch 告警,并根据需要添加数据质量或模型监控。根据实测运行时间和数据特征设置初始阈值,并在模型或数据量变化时审查这些阈值。
采用方法和结果
通过分阶段推广,团队可以在跨模型标准化之前验证交接。以下各节描述了采用方法和 GS Caltex 报告的结果。
从模型开发转向常规运营
首先为一个模型验证通往生产的路径,然后标准化跨部署重复的步骤。以下序列是基于 GS Caltex 经验的建议采用方法。
| 阶段 | 目标 | 范围 |
| 爬行 | 在生产中复现开发结果 | 验证 SageMaker Canvas 模型,在模型注册表中注册它,并手动运行管道 |
| 行走 | 建立可靠的计划运营 | 检查审批,按所需间隔计划运行,添加失败告警,并按执行管理输出 |
| 运行 | 跨模型复用运营流程 | 引入通用模板、持续集成和持续交付(CI/CD)、变更验证以及转移运营责任的程序 |
随着自动化扩展,工艺工程师继续评估预测对工艺是否有用。ML 工程师管理管道执行和变更。
GS Caltex 的结果
GS Caltex 减少了将 SageMaker Canvas 模型连接到生产所需的重复工作。ML 工程师现在可以在几小时内完成模型部署,而之前大约需要一周。他们还复用了工艺工程师在 SageMaker Canvas 中验证的资产。
工艺工程师在看到他们的模型用于生产后,开始在其他工艺中提出应用。ML 工程师花在重复集成工作上的时间减少,可以专注于运营和监控管道。
| 成果 | 报告结果 |
| 模型部署时间 | 之前约一周。现在几小时内 |
| 推理频率 | 每 30 分钟 |
| 成本影响 | 显著的成本节约 |
| 工程工作 | 工艺工程师提出新应用;ML 工程师专注于管道运维和监控 |
清理测试资源
对于测试部署,请先禁用 Amazon EventBridge 规则并移除其目标。在活动管道执行和作业完成后,删除测试管道及其 SageMaker 模型资源。
如果你为测试创建了实时端点,也请将其删除。从 S3 中移除输入、中间和预测文件,并根据你的保留策略清理 CloudWatch 日志。在删除模型文件和 Model Registry 版本之前,请检查其他执行或审计要求是否仍依赖它们。
结论
在 GS Caltex,工艺工程师在 SageMaker Canvas 中创建并验证模型,ML 工程师则使用这些资产在 SageMaker Pipelines 中运行生产工作流。这种交接减少了重复的集成工作。GS Caltex 报告称,ML 工程师现在可以在几小时内完成模型部署,而此前大约需要一周。
交接内容需要包括预处理流程、输入架构、推理配置和审批流程,以及模型文件。请验证该工作流能够复现预期结果,并能按所需计划可靠运行。
要尝试这种方法,请从你在 SageMaker Canvas 中验证过的一个模型开始,并使用 GitHub 仓库. 有关定义和运行工作流的详细信息,请参阅 SageMaker Pipelines 开发者指南 。通过手动执行检查预处理和批量预测结果,然后按你的应用所需的间隔安排运行。
在第 2 部分中,我们将展示 GS Caltex 如何使用 Amazon Bedrock 自动将现有模型迁移到此管道。