精选项目

摘要
Helion 现在采用编译期启发式,通过分析内核的 IR 和数据流来选择快速配置,无需缓慢的自动调优。它会将内核归类为 matmul、reduction 或 pointwise,并选择块大小、warp 数和流水级数,从而免费获得接近自动调优的速度。
引言
Helion 是 PyTorch 面向性能可移植机器学习内核的领域特定语言(DSL),其性能高度依赖自动调优。自动调优时间可能成为主要瓶颈:例如,此前一个团队在 72 种形状上调优单个 paged-attention 内核,在 Helion 的快速模式下花费了 10 小时,在全力调优下花费了 25 小时。为解决这些问题,我们开发了 一组启发式规则 ,它在编译期读取内核的 IR 和数据流并直接生成配置, 无需任何自动调优.
我们根据内核包含的操作将其划分为大类——matmul、reduction 或 pointwise——并对每一类应用特定的启发式规则。这些类别有意保持宽泛:例如,matmul 启发式会查找任何包含 matmul 操作(如 hl.dot 或 torch.baddbmm)的内核,而不仅仅是标准的 m-n-k 矩阵乘法。这些规则被设计为通用规则,可广泛适用于用户可能编写的自定义内核。
亮点:
- 自动调优器启发式。 我们的启发式覆盖大量内核,包括 GEMM、reduction,甚至线性注意力。
- 线性注意力。 在涵盖九种线性注意力变体的 96 个以上内核与形状组合上,计算出的配置在 H100 上前向传播比 Flash Linear Attention (FLA)中手写的 Triton 快 1.18 倍 ,包含反向传播时快 1.12 倍 。总体而言,该启发式在 H100 上比 Helion 此前无自动调优的默认配置快 2.13 倍 。
- vLLM reduction 内核。 在 H100 上六个生产内核的 153 个以上内核与形状组合上,计算出的配置比 vLLM 自己手写的 CUDA/C++ 算子快 1.27 倍 ,比 Helion 此前的默认配置快 2.2 倍 。
- 分析本身开销很低。 开启与关闭启发式编译内核的差异微乎其微(数十毫秒),这在 Triton 编译的噪声中根本察觉不到。
我们的方法:在编译期决定配置
单个 Helion 内核可以降级为数千个不同的 Triton 内核。一个定义涵盖块大小、循环顺序、索引模式和流水线策略,但自动调优器必须通过编译和基准测试大量候选配置,来决定生成这数千个中的哪一个。而且这种自动调优成本是 按内核和按形状计算的,你希望支持的内核、形状和硬件后端越多,问题就越成倍放大。
我们在编译期计算配置,而不是在调优时搜索配置。我们读取设备 IR 并记录其结构事实:哪些轴被分块、哪些块大小可调、哪些块在内核的哪个部分处于活跃状态等。启发式读取这些事实并生成配置。
这里的目的不是提出比自动调优器更好的配置——后者可以在选择之前对可能数千个配置进行基准测试。目的是在性能和等待时间之间的权衡空间中增加一个点。
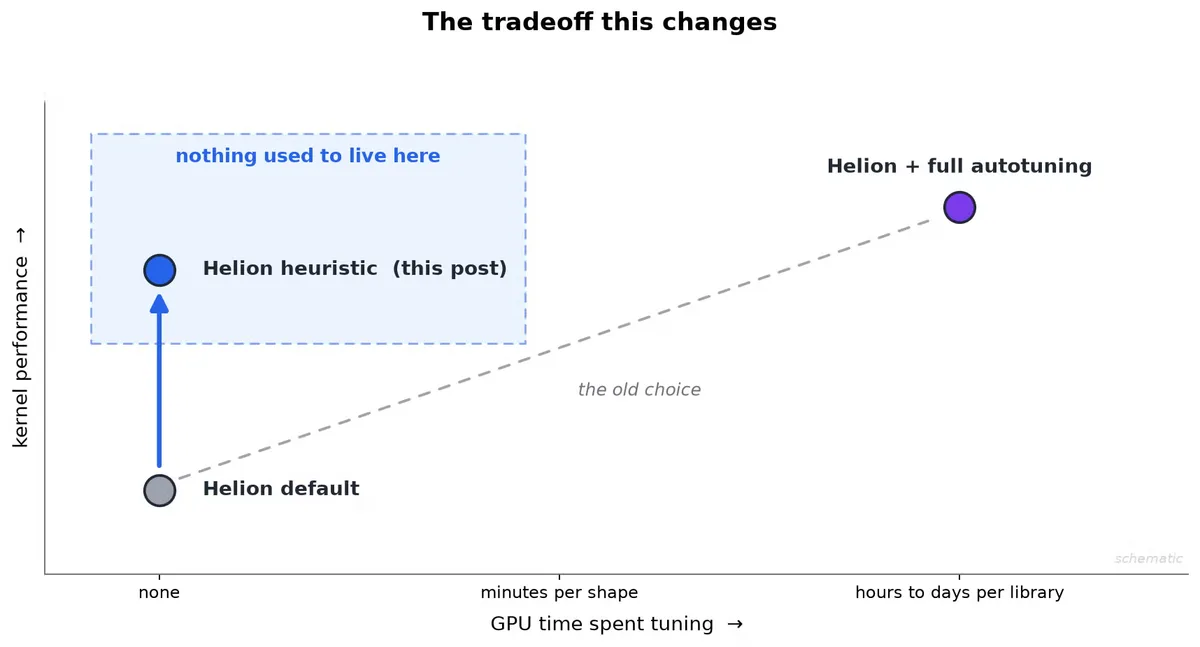
我们的启发式有两个用途。主启发式生成在禁用自动调优时使用的默认配置。当启用自动调优时,辅助启发式生成大约 5–20 个相关或替代配置,作为自动调优器的种子。两者的目标不同:默认配置应能独立表现良好,而种子应为自动调优器提供几个有希望的起点以加速自动调优。在本博客中,我们将涉及两者,但重点放在自动调优关闭时生成的主启发式上。
启发式如何工作
启发式为一组配置参数设定值,这些参数必须仔细调优才能实现高性能,通常由自动调优器选择。这些参数包括每个分块轴的块大小、num_warps、num_stages、L2 分组、加载驱逐策略等。
我们通过扫描设备 IR 中内核包含的操作来选择启发式。任何 matmul 都会路由到 matmul 启发式,无论内核中还有什么;没有 matmul 的 reduction 路由到 reduction 启发式;其他所有情况都使用 pointwise 启发式。如果内核的维度并非全部在编译期已知,则不会触发任何启发式,Helion 回退到原始默认配置。
我们的启发式都依赖同一套底层分析,该分析估算内核的资源使用情况。在内核的任何步骤,该分析都会确定:给定一组候选块大小,一个 CTA 在那一刻需要多少寄存器、共享内存,以及在 Blackwell 上需要多少张量内存。
为此,我们对编译器 IR 运行活跃性分析,并遍历每个图以找出每个值的最后使用位置,并推测它将放置在内存中的何处。这是一个难题:我们试图预测 Triton 会将什么保留在寄存器中、什么会通过共享内存暂存、什么会实际物化而不是被融合掉。有时预测比较容易(例如,我们假设 hl.dot 的输出在 B200 上会放入 TMEM),但估算只是近似的。
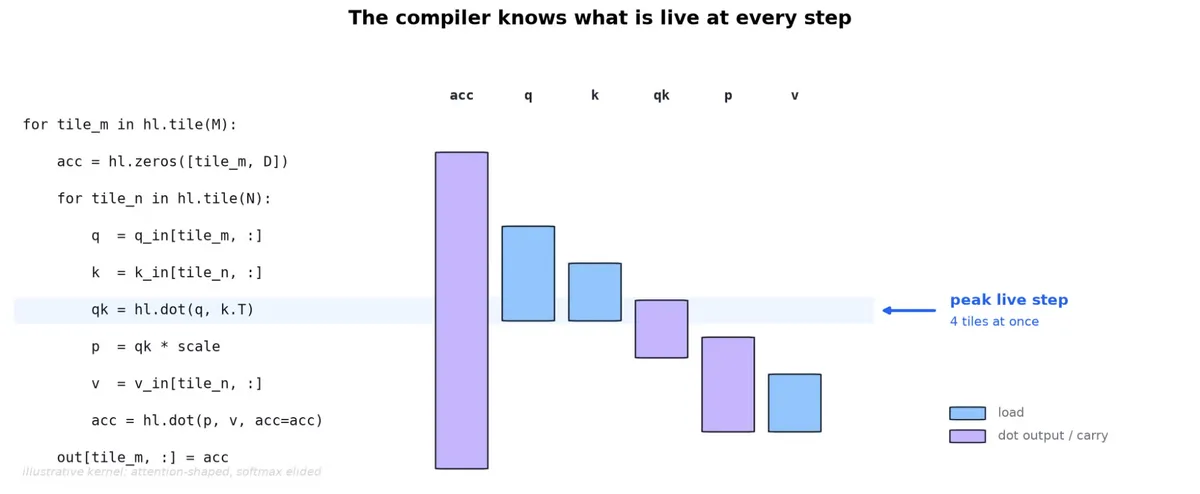
利用这一点,我们可以估算对性能重要的事项,例如:
- 占用率: 一个 SM 上能同时容纳多少个 CTA。哪种空间先耗尽就由它决定,例如,一个 CTA 需要 SM 十分之一的寄存器和十分之一的共享内存,但需要十分之六的张量内存,则每个 SM 只能容纳一个 CTA,因为两个 CTA 会超出张量内存预算 20%(0.6 x 2 = 1.2)。
- 寄存器压力: 我们打算启动的线程上分布的峰值活跃寄存器数量告诉我们汇编器是否会被迫溢出。
这些考虑因素会影响不同配置参数的选择。我们将以 matmul 启发式:
- 的 block_size 为例来说明: 如果启动产生的 CTA 数量少于 GPU 的 SM 数量,我们就在某个网格轴上缩小块大小,以产生更多 CTA。
- num_stages: 更多阶段能隐藏更多加载延迟,因此我们希望阶段数尽可能多,只要共享内存允许。但阶段数也可能意外地损失占用率:六个阶段也许放得下,但会吃掉 CTA 的全部共享内存预算,导致每个 SM 只能容纳一个 CTA,而三个阶段加每个 SM 两个 CTA 才是更好的取舍。
- num_warps。 有两点因素在拉扯这个参数:
- Triton 发出哪条指令。 在少于四个 warp,或 M 块小于 64 时,Triton 使用较小的同步 MMA;否则使用大的高吞吐版本(Hopper 上是 wgmma,Blackwell 上是 tcgen05)。通常我们希望用大的那个。但当矩阵乘法工作量很小时,有时更好的答案是每个 SM 上运行多个 CTA,执行彼此重叠加载的小型 MMA。因此我们统计 动态矩阵乘法工作量 (本质上是统计 hl.dot 将被动态执行的次数),并据此选择。
- 寄存器压力。 Warp 将 tile 分摊到更多线程上,因此 warp 越多,每个线程的压力越小。如果当前数量下的峰值活跃状态会导致溢出,那就倾向于增加 warp。
- 可行性检查。 对整个内核做最后一次悲观检查:把张量内存、共享内存和寄存器加起来,确认该配置确实能够启动。上述调整已经遵守了这些预算,所以这一步主要是防御性的。
当一个内核中存在 多个矩阵乘法 时(例如用于注意力和线性注意力),我们对每个 hl.dot 运行矩阵乘法启发式,并将结果作为起点。它们可能不一致:两个 dot 可能共享同一个块大小参数——一个 dot 的 N 常常是下一个 dot 的 K——而整个内核只有一个 num_warps。
为了解决这些取舍,我们按估计的重要性对每个 dot 排序:优先考虑任何带有循环携带累加器的 dot,因为该累加器在整个循环期间常驻,其 tile 决定了内核的占用规模;其次是它的动态矩阵乘法工作量;再次是它自身的输出面积。当两个 dot 对某个参数意见不一致时,排名更高的那个胜出(例如 num_warps 仅由排名最高的 dot 决定)。
reduction 启发式 通过一组类似的参数来工作: num_warps。
- 这里有三种压力,方向各不相同: 足够的 warp 来执行归约。
- 宽归约需要多个 warp 参与,因此从最大的被选归约出发设定起点:128 个元素需要一两个 warp,16,384 个元素则需要多得多。 驻留。
- 每个 CTA 的 warp 越多,每个 SM 的 CTA 就越少(每个 SM 有 CTA 数量上限),因此我们也会测试更少的 warp。 寄存器压力。
- 调整 warp 以避免寄存器溢出。 block_size。
- 每个 SM 容纳更多 CTA 意味着可能使用 更小 的 tile,因此我们缩小块以换取驻留。约束在于,步长为 1 的轴是承载合并加载的那个轴,把它缩得太小会失去加载合并。 持久化。
- 归约可以保持常驻并一次完成,也可以分块遍历。真正重要的情况是内核会读取两次的某一行——RMSNorm 先读一次以计算缩放,再读一次以应用它——当我们能证明这一点时,允许持久化付出一些溢出和驻留的代价,因为它省去了第二次内存访问。 由于 warp 数量取决于块,而块又取决于 warp 数量,我们迭代直到两者在一整轮中都不再变化(实践中这不会花很长时间)。
结果 1:配置质量,且无需调优时间
线性注意力
我们在 H100 上,针对六种生产形状,测量了九种线性注意力变体的前向和正向加反向。这六种形状覆盖 batch 1 到 8、8 到 96 个头、序列长度 1024 到 16384、头维度 64 到 256。基线是
Flash Linear Attention (FLA),一个开源、被广泛使用的手写 Triton 内核库。图表中的自动调优分支(“Helion AOT config”)是对每种形状运行一次完整自动调优器并保存胜出者的结果——也就是今天你会如何为已知的一组形状发布 Helion 内核。 在这项工作之前,选择是二元的:采用 Helion 的无自动调优默认值,运行速度为手写 FLA Triton 的
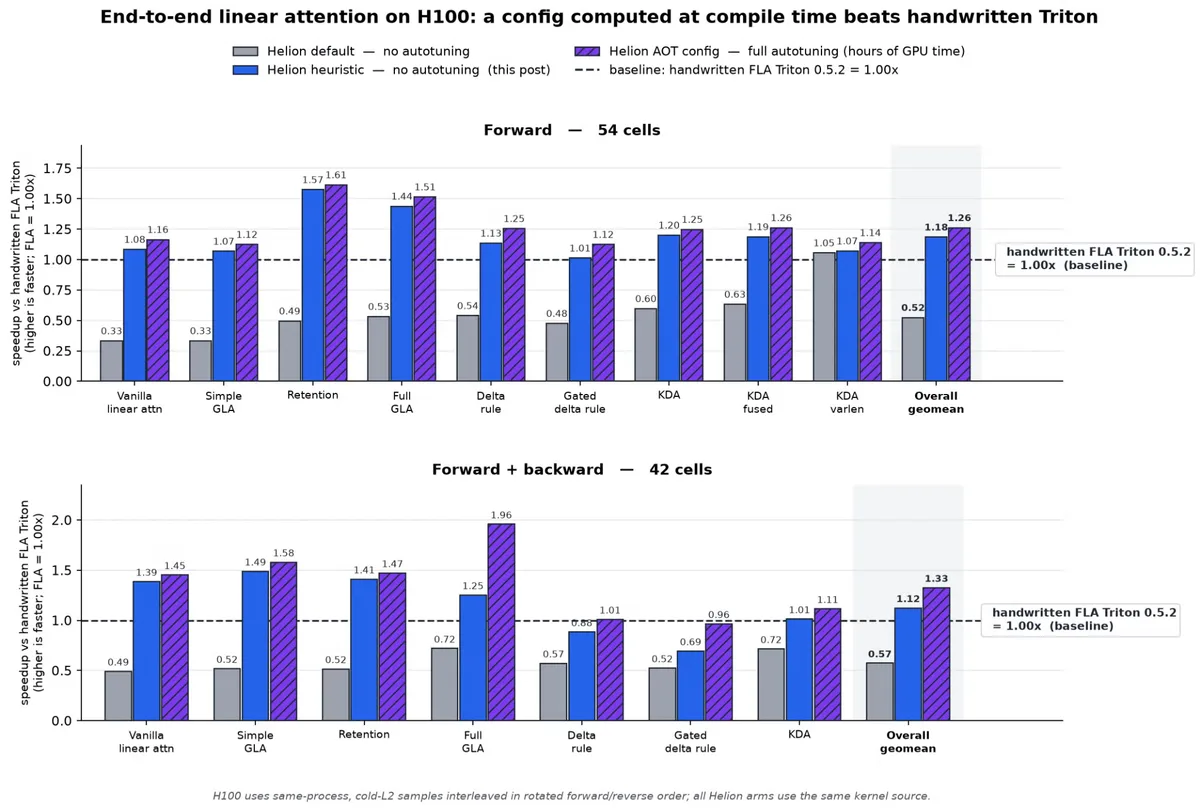
0.52x ,或者花费 GPU 小时进行自动调优,达到 1.26x 。该启发式增加了此前不存在的第三种选择:1.18x ,且没有自动调优的代价(自动调优所发现的大部分结果可立即获得),并且它把 Helion 的开箱即用行为从输给 手写 Triton 变为 胜过 它,至少对这组内核而言如此。 vLLM 的归约内核
vLLM
是一个被广泛部署的开源 LLM 推理引擎,它为其服务热路径上的操作自带手写 CUDA/C++ 内核。共有六个归约内核——两个 FP8 量化器、分别与量化融合的 RMSNorm 和 SiLU-and-multiply,以及融合的 QK 归一化加 RoPE——vLLM 已经有它们的 Helion 实现,由 本系列早前一篇博文 背后的团队贡献。这使它们成为一个很好的测试:由他人编写的生产内核,对比它们本要取代的手写 CUDA。我们在另一个代码库中得到了类似的结果。Helion 的无自动调优默认值运行速度为 vLLM CUDA 的
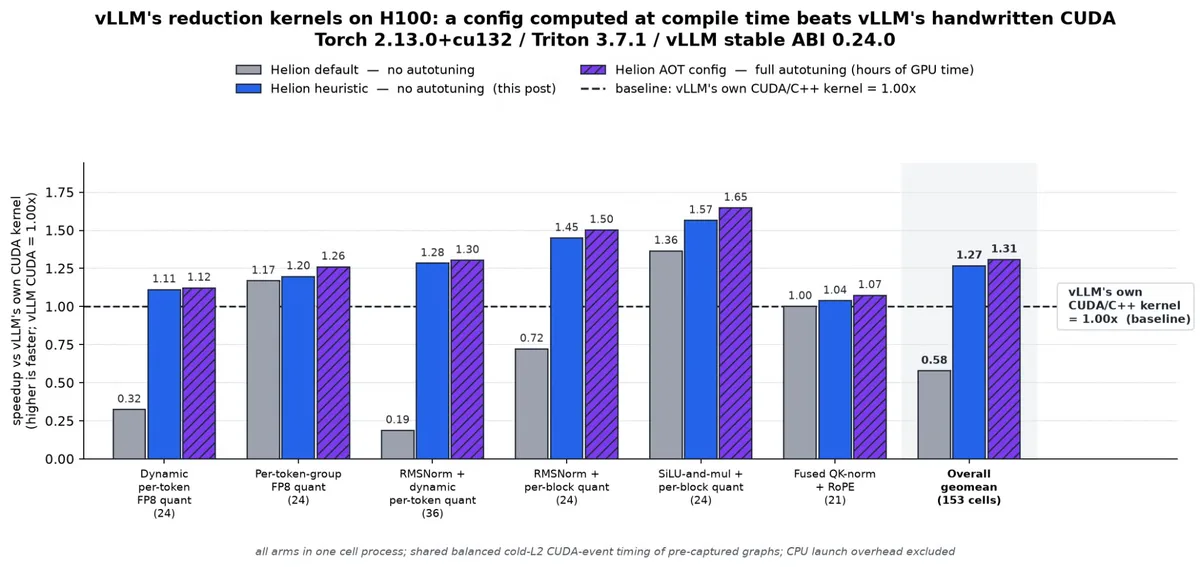
0.58x ;计算出的配置达到 1.27x ;完整自动调优达到1.31x 。有意思的数字是最后的差距:在这些内核上,自动调优相比我们免费计算出的配置只多买了约。 3% 日常内核,对比 torch.compile
上述两个比较都是专业库——线性注意力变体和 FP8 量化器。这一个则刻意相反:人人都写的内核。RMSNorm、LayerNorm、softmax、交叉熵及其同类,类似于
介绍博文 在首次测量 Helion 时基准测试的套件。本节中基准测试的大多数内核可以在 这里 找到.
这里的参考基线是 torch.compile(mode=”max-autotune-no-cudagraphs”):我们强制 torch.compile 使用其 Triton 后端,因此我们比较的对象不是手写库(例如 cuBLAS),而是由广泛使用的编译器生成的 Triton 代码。本节没有调优配置组,原因很简单:我们没有这些内核的完整自动调优运行结果(那将需要耗费大量 GPU 小时)。
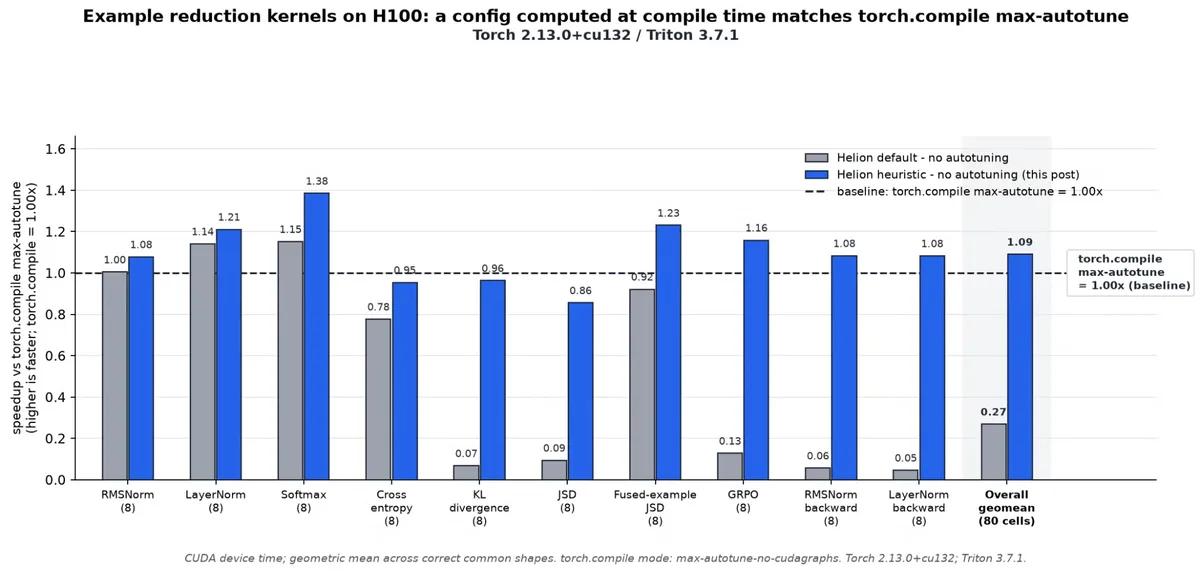
在一组包含十个归约内核和 80 个(内核、形状)组合的测试套件上,计算出的配置达到 max-autotune torch.compile 的 1.09x ,且自身未进行任何调优。Helion 未播种的默认值为 0.27x.
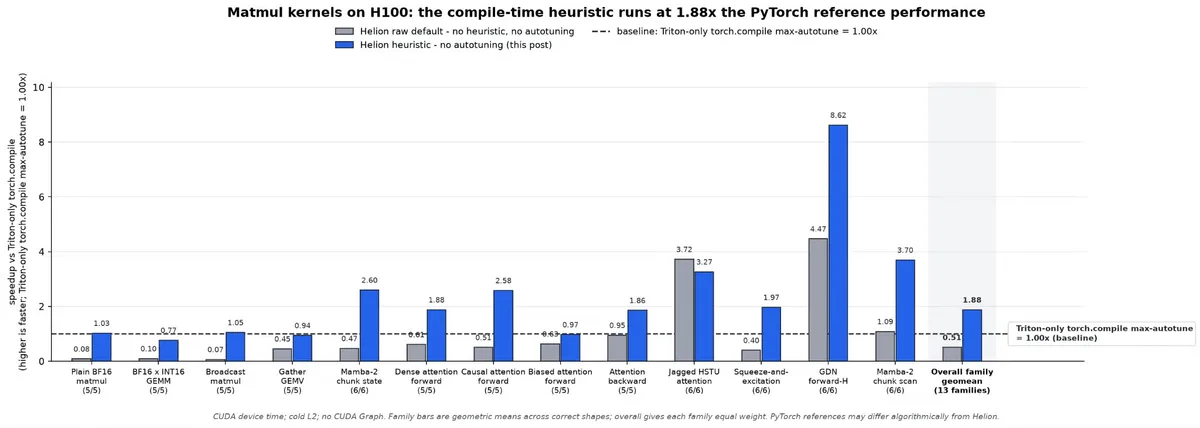
我们还扫描了 13 个 matmul 内核家族、共 70 种形状。计算出的配置总体达到 max-autotune torch.compile 的 1.88x ,而 Helion 的默认值为 0.51x 。关于这个 1.88x 有两点说明。这些比较并不总是完全对等的——对于其中一些内核,PyTorch 实现会物化中间结果,而 Helion 内核会将其融合。并且锯齿状 HSTU 注意力确实出现了性能回退:旧的默认值恰好在那里落在了一个好的配置上(3.72x),而启发式方法表现更差(3.27x)。
结果 2:种子能让搜索更快吗?
以上所有内容都关于自动调优 关闭. 时 Helion 所输出的配置。但同样的配置可以作为自动调优器的初始种群交给它,原则上,一个好的起点应该能让搜索更早完成。除了这个主配置之外,辅助启发式方法还会添加大约 5 到 20 个新的变体/方法。
为了测试这一点,我们选取了 38 个 matmul 和 multi-matmul 内核——线性注意力、注意力、Mamba,以及 squeeze-and-excitation 等其他类型——并为每个内核选取一种形状。然后我们对每个单元运行两次完整的自动调优:一次从随机配置开始,一次将编译器的种子放入初始种群。
这次运行的简短结论是: 播种在早期收益很大,但在后期收益小得多. 下面是一个单元,被选为该模式的清晰示例。x 轴表示尝试的配置数量,y 轴表示相对于我们找到的最佳配置的性能。
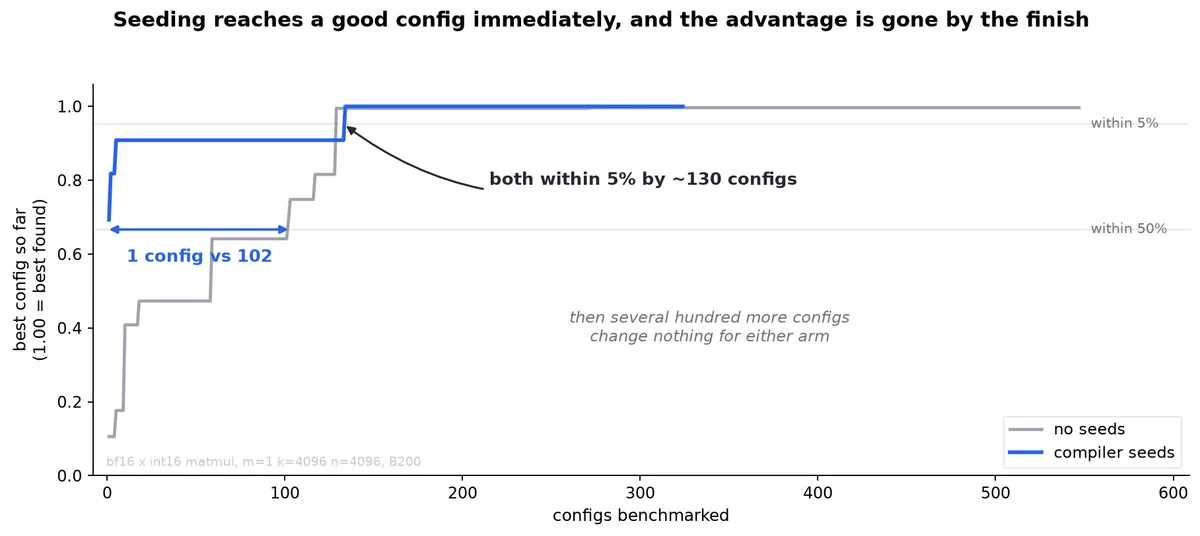
在播种的情况下, 第一个 配置远优于未播种的第一个配置。但未播种很快赶上,它们最终落在相同的答案上,而搜索还要再磨过数百个配置。早期优势巨大,而最终优势为零。
这就是全部 38 个单元的模式。中位数如下;计数包括编译失败或未能产生计时的配置,因为它们同样消耗预算。
| 搜索目标 | 中位数配置数(无种子/有种子) |
|---|---|
| 达到最佳找到值的 50% 以内 | 35.5 / 1.0 |
| 25% 以内 | 103.5 / 2.5 |
| 5% 以内 | 255.5 / 175.0 |
| 完成搜索 | 521.5 / 420.5 |
优势完全集中在开始阶段:达到仅仅尚可的水平所需配置少 35 倍,达到 25% 以内少 41 倍,但达到 5% 以内只少 1.5 倍,完成搜索只少 1.2 倍。
这个结果并不意味着:播种不会让最终配置变得更好。在同一块 GPU 上重放两组的获胜者,它们的差距在百分之零点几以内。这关乎搜索需要多长时间,而不是它最终落在哪里。
局限性与未来工作
一个核心局限是,这些启发式方法预测的是另一个编译器会做什么。每个预算都依赖于猜测一个值最终落在哪里——寄存器、共享内存还是张量内存——而那是 Triton 的决定,不是我们的。其中一些可以安全押注:在 B200 上,matmul 结果会位于张量内存中。很多地方我们会猜错。未来工作有几个可能的方向。
测量而非预测。 针对上述局限最干净的修复是停止猜测:编译一次,读取汇编器报告的寄存器和共享内存使用量,并据此修正估计。
在更多内核上触发。 目前,当我们缺乏信息来为任何东西确定尺寸时——例如一个在仅运行时才知道的范围上分块的循环——我们就会放弃。一个不那么有根据的猜测会很容易:一个默认范围、一个均值、随便什么。没有这些信息,配置会更差,但今天的替代方案是基础默认值,而上述结果表明它非常糟糕——所以这个猜测可能仍然值得做。
触及更多旋钮。 我们设置了块大小、num_warps 和 num_stages,以及一些 L2 分组和 L2 驱逐策略。这留下了一长串未触及的选项——张量描述符与指针算术、持久化与扁平启动等。单独来看,这些可能不如我们确实设置的那些有价值,但肯定还有性能留在桌上。
特化启发式方法。 它们被刻意设计为通用的:一个 multi-matmul 启发式方法必须在注意力 和 线性注意力上都表现良好,一个归约启发式方法必须在 RMSNorm 和 vLLM 的量化内核上都表现良好。另一种选择是父启发式方法带子启发式方法——一个 vLLMQuantizationHeuristic,从 ReductionHeuristic 的答案开始,然后根据它对该家族的了解进行特化。
其他后端。 这里的一切都在 NVIDIA 上评估,启发式方法在 Triton 后端上为 H100 和 B200 默认启用。该方法中没有任何 NVIDIA 特有的东西——分析由应适用于各后端的硬件限制参数化——但常量和阶梯是针对这两款芯片调优的。
结论
这些启发式方法已合并到 Helion 中,并在 Triton 后端上为 H100 和 B200 默认启用。如果您想了解更多,请查看 自动调优器启发式方法.
关键不在于静态分析胜过搜索,而在于如今这一差距已经小到对某些内核来说跳过搜索是合理的做法。Helion 的开箱即用表现从手写 FLA Triton 的 0.52 倍提升到 1.18 倍,从 vLLM 手写 CUDA 的 0.58 倍提升到 1.27 倍,而且无需编译、无需基准测试。在通用归约内核套件上,它达到 torch.compile max-autotune 的 1.09 倍。当你发布一组固定的形状并且能够一次性承担调优成本时,完整自动调优仍然是正确的选择;改变的是,替代方案不再是一种巨大的让步。
/row /row