 2026年11月10日
作者: Dan Feigin, Oz Bar-Shalom, Ekin Karabulut 和 Schwinn Saereesitthipitak
讨论 (0)
AI 生成的摘要
- NVIDIA Snapshot 是一个面向 Kubernetes 上 GPU 工作负载的开源检查点与恢复系统,可捕获完全初始化的 CPU 和 GPU 内存状态。
- 从快照工件恢复可在测试配置中于 3.6 至 42.7 秒内让推理副本上线,相比需要数分钟的冷启动实现 8 倍至 36 倍的加速。
- 该系统通过张量并行、数据和专家并行,以及针对大型混合专家模型的解码上下文并行来支持多 GPU 工作负载,检查点规模在八块 GPU 上最高可达 1 TB。
- 检查点创建耗时 15 秒至 5.5 分钟,具体取决于模型规模,而在所有测试配置中,检查点加恢复的总时间都短于单次冷启动。
- 在配备 VAST NFS 存储的 NVIDIA B200 GPU 上的基准测试结果表明,在大型恢复中 GPU 状态恢复占主导,耗时 18 至 29 秒,而基于 CRIU 的 CPU 进程恢复耗时 4.2 至 10.8 秒。
后续步骤
- 探索 NVIDIA Snapshot 仓库 以获取安装说明和使用指南。
- 请遵循 NVIDIA Dynamo 用户指南 使用 Snapshot 恢复工作进程。
- 加入 NVIDIA Dynamo Slack 工作区 ,在 #snapshot-dev 频道讨论集成或提供反馈。
NVIDIA Snapshot是 NVIDIA DSX AI Factory Platform的一个全新开源组件,它使已初始化的 GPU 工作负载可在多个推理副本之间复用,从而加快启动和恢复速度。
当推理需求激增或某个副本发生故障时,可用的 GPU 并不会立即转化为服务容量。初始化 LLM 工作负载——这一过程被称为冷启动——可能需要数分钟,从而延迟扩缩容和恢复。
Snapshot 是 Kubernetes 上 GPU 工作负载的检查点与恢复系统。它会捕获完全初始化的工作负载(包括 CPU 和 GPU 内存),并在兼容的基础设施上恢复该状态,使推理容量在数秒而非数分钟内上线。图 1 展示了启动序列。Snapshot 跳过了重复的工作负载初始化;基础设施预配和容器镜像加载仍不在所测量的恢复路径之内。
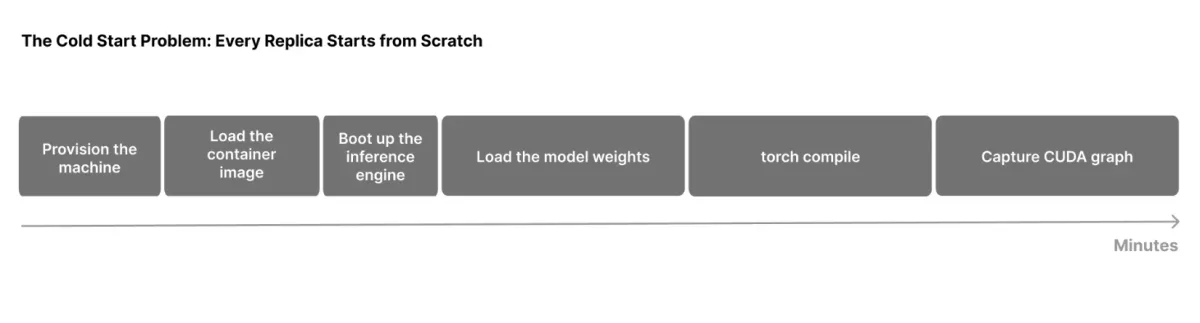
本文介绍 Snapshot 如何对 GPU 工作负载执行检查点与恢复、平台团队如何集成它,以及在三种推理引擎上恢复时间与冷启动的对比情况。
面向 AI 工厂运营的 Snapshot
Snapshot 最初为 NVIDIA Dynamo 推理工作进程开发,提供检查点与恢复能力,其他推理引擎、调度器、控制器和平台均可集成。
Snapshot 为 GPU Pod 提供两种操作:
- 检查点:工作负载完全初始化后,将其 CPU 和 GPU 内存捕获为可移植产物。
- 恢复:在具有相同 GPU 型号和驱动的任意节点上,从该产物启动新的 Pod。进程从检查点处继续运行,因此跳过权重加载、编译和图捕获。
这两种操作都使用 Kubernetes 自定义资源。要对已在运行的 Pod 执行检查点,请创建一个 PodSnapshot 来指定该 Pod。要从模板启动 Pod 并在其就绪后立即执行检查点,请改为创建一个 SnapshotJob 。要执行恢复,请向新 Pod 添加注解 nvidia.com/restore-from ,并指定要从中恢复的 PodSnapshot 。工作负载只需进行少量握手,即可在检查点前暂停、在恢复后继续运行。该仓库已提供 面向 vLLM、SGLang 和 NVIDIA TensorRT LLM 的现成示例.
Snapshot 可以将单节点上跨多个 GPU 的兼容工作负载作为单个检查点产物跨 rank 进行统一检查点与恢复。这支持使用张量并行(TP)、数据与专家并行(DEP)以及解码上下文并行(DCP)等并行策略的大型混合专家(MoE)模型快速启动。工作负载必须满足 Snapshot 的 检查点/恢复与运行时兼容性要求。请参阅 示例配置.
基准测试
设计合作伙伴还在自己的工作负载上评估了 Snapshot:
- Crusoe是 Snapshot 的上游贡献者,在 NVIDIA HGX B300 上将 GLM-5.3 Pod 的就绪时间从约 8 分钟缩短至 31 秒。
- Saturn Cloud是一家 token factory 平台,针对从零扩展的推理对 NVIDIA Snapshot 进行了基准测试,在 NVIDIA HGX B300.
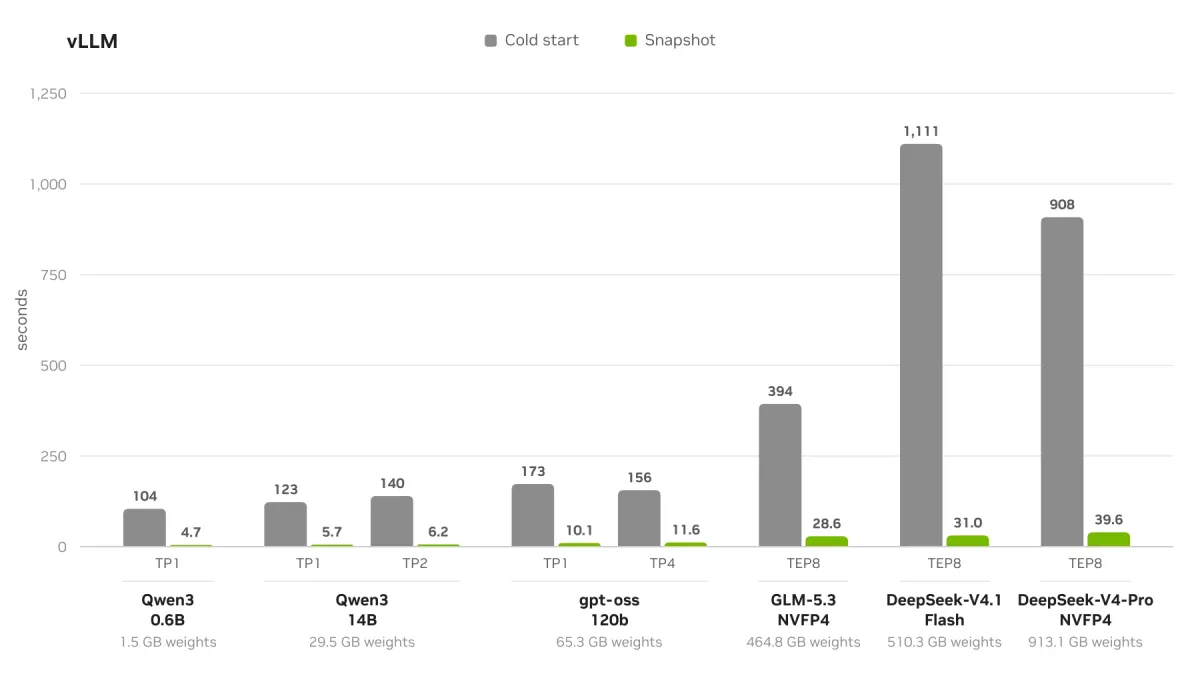
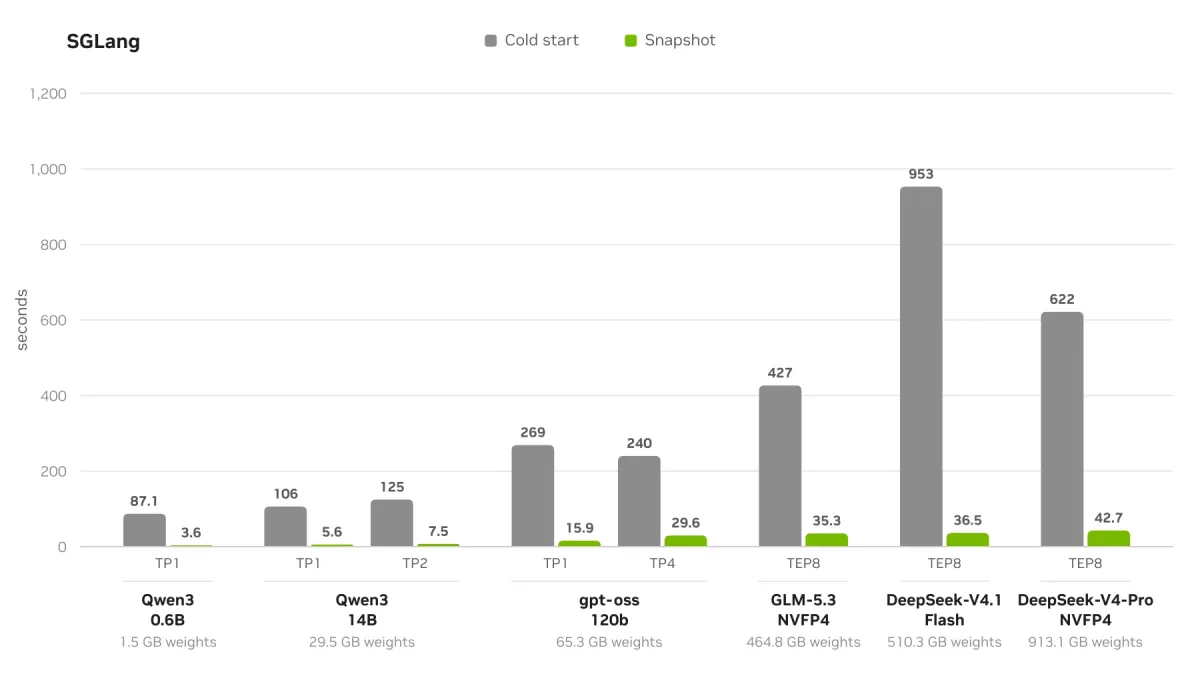
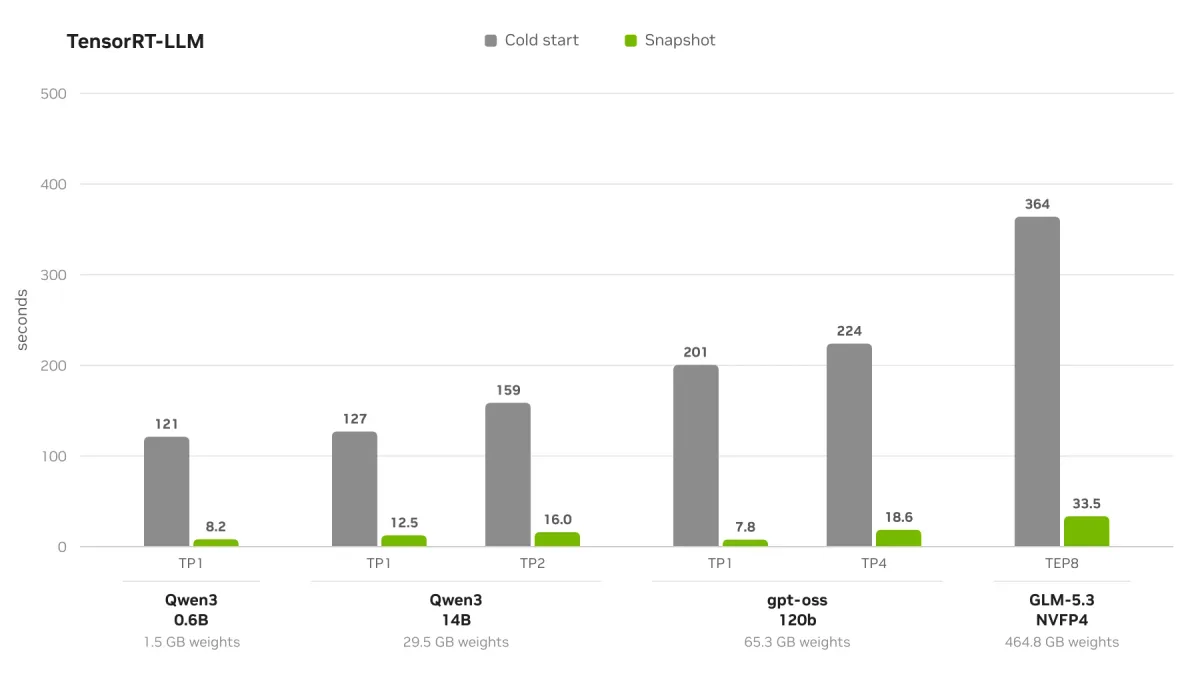
以下基准测试展示了 Snapshot 如何在 vLLM、SGLang 和 NVIDIA TensorRT LLM(TRT-LLM)上加速推理启动——涵盖从 6 亿参数到 混合专家 (MoE)模型,在 8 块 GPU 上具有 1 TB 检查点。在所有测试配置中,Snapshot 都能在 45 秒内恢复一个副本,比冷启动快 8 倍到 36 倍。
方法
每个配置都在相同的硬件和软件栈上使用两种策略进行测试:
- 冷启动: 工作负载从零开始。计时从进程启动开始,直到引擎初始化返回、推理开始之前。测量分为四个阶段(表 2):
- 启动: 启动引擎和工作进程,导入 Python 库,并建立 GPU 之间的通信。部分即时(JIT)内核编译也在此阶段进行。
- 模型加载: 读取模型权重并构建模型的张量,包括加载期间执行的任何引擎特定转换或重新打包。
- 初始化: 准备已加载的模型以提供服务:内存分析、分配键值(KV)缓存和运行时缓冲区,以及其他内核和运行时准备工作。
- 编译、自动调优和图捕获: 编译内核(例如,使用
torch.compile),针对 GPU 进行自动调优,并捕获 CUDA 图。
- 快照: 工作负载从其检查点恢复。计时从要求快照执行恢复的那一刻开始,直到工作负载再次开始提供服务。测量分为四个阶段(表 3):
- 代理设置: 节点上的快照代理定位检查点产物,并准备目标 Pod 和 GPU。
- 用户空间检查点/恢复(CRIU)恢复: CRIU 是用于进程检查点的标准 Linux 工具,它将进程映像从存储读入主机内存。速度主要由存储后端决定。
- CUDA 恢复: 将 GPU 状态复制回 GPU 内存。
- 唤醒/重映射: 使进程适配新节点并唤醒引擎。
两项测量均不包含拉取容器镜像和搭建容器运行时。每次检查点之前都会触发 KV 缓存释放,因此它不属于该产物的一部分。
表 1 还报告了检查点时间和大小:捕获一个完全初始化的副本需要多长时间,以及存储该产物需要多少存储空间。这是每个模型和配置的一次性成本。
设置
- GPU: NVIDIA B200
- NVIDIA 驱动: 615.71.09
- 存储后端: VAST(NFS)
- 推理引擎:
- vLLM 0.31.0
- SGLang 0.5.21
- TensorRT LLM 1.3.0
结果
基准测试显示了四项主要发现。
- 恢复时间保持在43秒以内: 在所有测试配置中,Snapshot 恢复副本耗时 3.6 至 42.7 秒——比冷启动快 8 至 36 倍。最大的 MoE 模型在八块 GPU 上的检查点约为 600 GB 至 1 TB,恢复时间不到 43 秒,而冷启动时间为 6 至 19 分钟。
- 恢复过程跳过的不仅是权重加载: 冷启动时间包括加载权重、编译和自动调优内核,以及捕获 CUDA 图。Snapshot 恢复的是已初始化的负载,从而跳过这些重复步骤。
- 检查点在第一个恢复的副本上就能收回成本: 在每个测试配置中,检查点时间加恢复时间都短于一次冷启动。检查点创建耗时 15 秒至 5.5 分钟,具体取决于模型和配置。
- GPU 状态迁移在大型恢复中占主导: 对于八 GPU 的 MoE 配置,恢复 GPU 状态耗时 18 至 29 秒。使用 CRIU 恢复 CPU 进程状态耗时 4.2 至 10.8 秒。
图 2 至图 4 对比了 vLLM、SGLang 和 TensorRT LLM 在受测模型与并行配置下的冷启动时间和 Snapshot 恢复时间。表 1 提供了每种配置的数据,包括检查点时间和大小。所有时间均以秒为单位。在图表中, TEP8 表示跨八块 GPU 的张量并行与专家并行.
| 模型 | 引擎 | 并行方式 | 权重大小(GB) | 检查点大小(GB) | 检查点时间(秒) | 冷启动(秒) | Snapshot agent 恢复(秒) | 加速比 |
|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | vLLM | TP1 | 1.50 | 8.13 | 15.30 | 104.43 | 4.66 | 22.40x |
| Qwen3-0.6B | SGLang | TP1 | 1.50 | 9.42 | 20.71 | 87.08 | 3.59 | 24.26x |
| Qwen3-0.6B | TRT-LLM | TP1 | 1.50 | 8.04 | 20.07 | 121.26 | 8.15 | 14.88x |
| Qwen3-14B | vLLM | TP1 | 29.54 | 37.71 | 19.98 | 122.76 | 5.72 | 21.45x |
| Qwen3-14B | vLLM | TP2 | 29.54 | 48.29 | 38.37 | 139.63 | 6.19 | 22.55x |
| Qwen3-14B | SGLang | TP1 | 29.54 | 40.19 | 26.17 | 106.26 | 5.60 | 18.96x |
| Qwen3-14B | SGLang | TP2 | 29.54 | 51.93 | 33.88 | 124.72 | 7.45 | 16.75x |
| Qwen3-14B | TRT-LLM | TP1 | 29.54 | 36.38 | 23.72 | 127.02 | 12.50 | 10.16x |
| Qwen3-14B | TRT-LLM | TP2 | 29.54 | 47.97 | 42.90 | 158.66 | 15.99 | 9.92x |
| gpt-oss-120b | vLLM | TP1 | 65.25 | 81.56 | 44.37 | 172.80 | 10.09 | 17.12x |
| gpt-oss-120b | vLLM | TP4 | 65.25 | 119.69 | 133.01 | 155.66 | 11.62 | 13.40x |
| gpt-oss-120b | SGLang | TP1 | 65.25 | 172.32 | 55.63 | 268.96 | 15.94 | 16.87x |
| gpt-oss-120b | SGLang | TP4 | 65.25 | 693.89 | 174.20 | 240.17 | 29.64 | 8.10x |
| gpt-oss-120b | TRT-LLM | TP1 | 65.25 | 77.87 | 29.98 | 200.55 | 7.79 | 25.75x |
| gpt-oss-120b | TRT-LLM | TP4 | 65.25 | 111.34 | 85.29 | 223.96 | 18.58 | 12.05x |
| GLM-5.3-NVFP4 | vLLM | TEP8 | 464.82 | 604.00 | 282.80 | 393.65 | 28.64 | 13.74x |
| GLM-5.3-NVFP4 | SGLang | TEP8 | 464.82 | 669.49 | 327.20 | 426.70 | 35.34 | 12.07倍 |
| GLM-5.3-NVFP4 | TRT-LLM | TEP8 | 464.82 | 628.30 | 231.33 | 363.90 | 33.55 | 10.85倍 |
| DeepSeek-V4.1-Flash | vLLM | TEP8 | 510.30 | 647.18 | 274.75 | 1110.65 | 30.96 | 35.87倍 |
| DeepSeek-V4.1-Flash | SGLang | TEP8 | 510.30 | 743.35 | 286.77 | 953.09 | 36.54 | 26.08倍 |
| DeepSeek-V4-Pro-NVFP4 | vLLM | TEP8 | 913.09 | 996.53 | 193.84 | 908.48 | 39.56 | 22.96倍 |
| DeepSeek-V4-Pro-NVFP4 | SGLang | TEP8 | 913.09 | 1039.09 | 253.72 | 621.55 | 42.69 | 14.56倍 |
表2 细分了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。
| 模型 | Engine | 并行 | 初创公司 | 模型加载(秒) | 初始化(秒) | 编译、自动调优与图捕获(秒) | 总计(秒) |
|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | vLLM | 表1. 在配备 VAST(NFS)存储的 NVIDIA B200 上,使用 1 至 8 块 GPU 时,冷启动与快照恢复的对比。检查点时间为每种配置的一次性开销。加速比为冷启动时间除以快照恢复时间。表2 细分了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。模型引擎并行方式启动(秒)模型加载(秒)初始化(秒)编译、自动调优与图捕获(秒)总计(秒)Qwen3-0.6B vLLM | 31.37 | 17.27 | 14.58 | 41.21 | 104.43 |
| Qwen3-0.6B | SGLang | 33.7411.678.4133.2687.0825.793.7940.6451.04121.2631.1626.1515.3050.15122.7642.1818.9615.2963.20139.6333.4520.798.2843.74106.2647.6218.938.2949.88124.7225.3511.5439.3650.77127.0227.428.8870.6251.74158.6635.1538.6910.4988.47172.8049.9124.7112.1368.91155.6642.5434.440.36191.62268.9657.9749.061.33131.81240.1726.2147.5042.8583.99200.5534.2842.7222.34124.62223.9665.4765.8848.88213.42393.6560.7773.982.66289.29426.7031.5890.39120.43121.50363.9063.96184.9077.25784.541110.6556.1874.2138.50784.20953.0964.4 | 33.74 | 11.67 | 8.41 | 33.26 | 87.08 |
| Qwen3-0.6B | TRT-LLM | 在配备 VAST(NFS)存储的 NVIDIA B200 上,于 1 至 8 块 GPU 上进行快照恢复。检查点时间是每种配置的一次性开销。加速比为冷启动时间除以快照恢复时间。表2 细分了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。模型引擎并行方式启动(秒)模型加载(秒)初始化(秒)编译、自动调优与图捕获(秒)总计(秒)Qwen3-0.6B vLLM TP1 31.37 17.27 14.58 41.21 104.43 Qwen3-0.6B SGLang TP1 33.74 11.67 8.41 33.26 87.08 Qwen3-0.6B TRT-LLM | 25.79 | 3.79 | 40.64 | 51.04 | 121.26 |
| Qwen3-14B | vLLM | 在配备 VAST(NFS)存储的 NVIDIA B200 上,于 1 至 8 块 GPU 上进行快照恢复。检查点时间是每种配置的一次性开销。加速比为冷启动时间除以快照恢复时间。表2 细分了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。模型引擎并行方式启动(秒)模型加载(秒)初始化(秒)编译、自动调优与图捕获(秒)总计(秒)Qwen3-0.6B vLLM TP1 31.37 17.27 14.58 41.21 104.43 Qwen3-0.6B SGLang TP1 33.74 11.67 8.41 33.26 87.08 Qwen3-0.6B TRT-LLM TP1 25.79 3.79 40.64 51.04 121.26 Qwen3-14B vLLM | 31.16 | 26.15 | 15.30 | 50.15 | 122.76 |
| Qwen3-14B | vLLM | 42.18 18.96 15.29 63.20 139.63 Qwen3-14B SGLang TP1 33.45 20.79 8.28 43.74 106.26 Qwen3-14B SGLang TP2 47.62 18.93 8.29 49.88 124.72 Qwen3-14B TRT-LLM TP1 25.35 11.54 39.36 50.77 127.02 Qwen3-14B TRT-LLM TP2 27.42 8.88 70.62 51.74 158.66 gpt-oss-120b vLLM TP1 35.15 38.69 10.49 88.47 172.80 gpt-oss-120b vLLM TP4 49.91 24.71 12.13 68.91 155.66 gpt-oss-120b SGLang TP1 42.54 34.44 0.36 191.62 268.96 gpt-oss-120b SGLang TP4 57.97 49.06 1.33 131.81 240.17 gpt-oss-120b TRT-LLM TP1 26.21 47.50 42.85 83.99 200.55 gpt-oss-120b TRT-LLM TP4 34.28 42.72 22.34 124.62 223.96 GLM-5.3-NVFP4 vLLM T | 42.18 | 18.96 | 15.29 | 63.20 | 139.63 |
| Qwen3-14B | SGLang | 加速比等于冷启动时间除以 Snapshot 恢复时间。表 2 细分了冷启动时间,展示恢复过程跳过了哪些初始化阶段。模型引擎并行方式启动(秒)模型加载(秒)初始化(秒)编译、自动调优与图捕获(秒)总计(秒)Qwen3-0.6B vLLM TP1 31.37 17.27 14.58 41.21 104.43 Qwen3-0.6B SGLang TP1 33.74 11.67 8.41 33.26 87.08 Qwen3-0.6B TRT-LLM TP1 25.79 3.79 40.64 51.04 121.26 Qwen3-14B vLLM TP1 31.16 26.15 15.30 50.15 122.76 Qwen3-14B vLLM TP2 42.18 18.96 15.29 63.20 139.63 Qwen3-14B SGLang TP1 33.45 20.79 8.28 43.74 106.26 Qwen3-14B SGLang TP2 47.62 18.93 8.29 49.88 124.72 Qwen3-14B TRT-LLM TP1 25.35 11.54 39.36 50.77 127.02 Qwen3-14B TRT-LLM TP2 27.42 8.88 70.62 51.74 158.66 gpt-oss-120b vLLM TP1 35.15 38.69 10.49 88.47 172.80 gpt-oss-120b vLLM TP4 49.91 24.71 12.13 68.91 155.66 gpt-oss-120b SGLang TP1 42.54 34.44 0.36 191.62 268.96 gpt-oss-120b SGLang TP4 57.97 49.06 1.33 131.81 240.17 gpt-oss-120b TRT-LLM TP1 26.21 47.50 42.85 83.99 200.55 gpt-oss-120b TRT-LLM TP4 34.28 42.72 22.34 124.62 223.96 GLM-5.3-NVFP4 vLLM TEP8 65.47 65.88 48.88 213.42 393.65 GLM-5.3-NVFP4 S | 33.45 | 20.79 | 8.28 | 43.74 | 106.26 |
| Qwen3-14B | SGLang | 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。 | 47.62 | 18.93 | 8.29 | 49.88 | 124.72 |
| Qwen3-14B | TRT-LLM | 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。 | 25.35 | 11.54 | 39.36 | 50.77 | 127.02 |
| Qwen3-14B | TRT-LLM | 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。 | 27.42 | 8.88 | 70.62 | 51.74 | 158.66 |
| gpt-oss-120b | vLLM | 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。 | 35.15 | 38.69 | 10.49 | 88.47 | 172.80 |
| gpt-oss-120b | vLLM | TP4 | 49.91 | 24.71 | 12.13 | 68.91 | 155.66 |
| gpt-oss-120b | SGLang | TP1 | 42.54 | 34.44 | 0.36 | 191.62 | 268.96 |
| gpt-oss-120b | SGLang | GLang TP1 42.54 34.44 0.36 191.62 268.96 gpt-oss-120b SGLang TP4 57.97 49.06 1.33 131.81 240.17 gpt-oss-120b TRT-LLM TP1 26.21 47.50 42.85 83.99 200.55 gpt-oss-120b TRT-LLM TP4 34.28 42.72 22.34 124.62 223.96 GLM-5.3-NVFP4 vLLM TEP8 65.47 65.88 48.88 213.42 393.65 GLM-5.3-NVFP4 S33.45 20.79 8.28 43.74 106.26 Qwen3-14B SGLang 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。47.62 18.93 8.29 49.88 124.72 Qwen3-14B TRT-LLM 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。25.35 11.54 39.36 50.77 127.02 Qwen3-14B TRT-LLM 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。27.42 8.88 70.62 51.74 158.66 gpt-oss-120b vLLM 表2 分解了冷启动时间,展示了恢复过程会跳过哪些初始化阶段。35.15 38.69 10.49 88.47 172.80 gpt-oss-120b vLLM TP4 49.91 24.71 12.13 68.91 155.66 gpt-oss-120b SGLang TP1 42.54 34.44 0.36 191.62 268.96 gpt-oss-120b SGLang | 57.97 | 49.06 | 1.33 | 131.81 | 240.17 |
| gpt-oss-120b | TRT-LLM | gpt-oss-120b TRT-LLM TP1 26.21 47.50 42.85 83.99 200.55 gpt-oss-120b TRT-LLM TP4 34.28 42.72 22.34 124.62 223.96 GLM-5.3-NVFP4 vLLM TEP8 65.47 65.88 48.88 213.42 393.65 GLM-5.3-NVFP4 SGLang TEP8 60.77 73.98 2.66 289.29 426.70 GLM-5.3-NVFP4 TRT-LLM TEP8 31.58 90.39 120.43 121.50 363.90 DeepSeek-V4.1-Flash vLLM TEP8 63.96 184.90 77.25 784.54 1110.65 DeepSeek-V4.1-Flash SGLang TEP8 56.18 74.21 38.50 784.20 953.09 DeepSeek-V4-Pro-NVFP4 vLLM TEP8 64.42 95.14 64.87 684.05 908.48 DeepSeek-V4-Pro-NVFP4 SGLang TEP8 58.80 87.68 42.55 432.52 621.55 表2. 冷启动时间按阶段分解 | 26.21 | 47.50 | 42.85 | 83.99 | 200.55 |
| gpt-oss-120b | TRT-LLM | TP4 | 34.28 | 42.72 | 22.34 | 124.62 | 223.96 |
| GLM-5.3-NVFP4 | vLLM | GLang57.9749.061.33131.81240.17gpt-oss-120bTRT-LLMgpt-oss-120b TRT-LLM TP1 26.21 47.50 42.85 83.99 200.55 gpt-oss-120b TRT-LLM TP4 34.28 42.72 22.34 124.62 223.96 GLM-5.3-NVFP4 vLLM TEP8 65.47 65.88 48.88 213.42 393.65 GLM-5.3-NVFP4 SGLang TEP8 60.77 73.98 2.66 289.29 426.70 GLM-5.3-NVFP4 TRT-LLM TEP8 31.58 90.39 120.43 121.50 363.90 DeepSeek-V4.1-Flash vLLM TEP8 63.96 184.90 77.25 784.54 1110.65 DeepSeek-V4.1-Flash SGLang TEP8 56.18 74.21 38.50 784.20 953.09 DeepSeek-V4-Pro-NVFP4 vLLM TEP8 64.42 95.14 64.87 684.05 908.48 DeepSeek-V4-Pro-NVFP4 SGLang TEP8 58.80 87.68 42.55 432.52 621.55 表2. 冷启动时间按阶段分解 | 65.47 | 65.88 | 48.88 | 213.42 | 393.65 |
| GLM-5.3-NVFP4 | SGLang | TEP8 | 60.77 | 73.98 | 2.66 | 289.29 | 426.70 |
| GLM-5.3-NVFP4 | TRT-LLM | TEP8 | 31.58 | 90.39 | 120.43 | 121.50 | 363.90 |
| DeepSeek-V4.1-Flash | vLLM | TEP8 | 63.96 | 184.90 | 77.25 | 784.54 | 1110.65 |
| DeepSeek-V4.1-Flash | SGLang | TEP8 | 56.18 | 74.21 | 38.50 | 784.20 | 953.09 |
| DeepSeek-V4-Pro-NVFP4 | vLLM | TEP8 | 64.42 | 95.14 | 64.87 | 684.05 | 908.48 |
| DeepSeek-V4-Pro-NVFP4 | SGLang | TEP8 | 58.80 | 87.68 | 42.55 | 432.52 | 621.55 |
表3将恢复时间分解为代理设置、CRIU恢复、CUDA恢复以及唤醒/重映射。
| 模型 | 模型 | 并行性 | 快照:代理设置 | 快照:CRIU 恢复 | 快照:CUDA 恢复 | 快照:唤醒/重映射 | 总计(秒) |
|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | vLLM | TP1 | 2.30 | 1.36 | 0.78 | 0.22 | 4.66 |
| Qwen3-0.6B | SGLang | 0.241.331.020.993.59Qwen3-0.6BTRT-LLMTP15.721.430.840.168.15Qwen3-14BvLLMTP10.131.583.160.855.72Qwen3-14BvLLMTP20.572.033.430.176.19Qwen3-14BSGLangTP10.241.353.670.345.60Qwen3-14BSGLangTP20.922.173.490.877.45Qwen3-14BTRT-LLMTP16.802.702.820.1812.50Qwen3-14BTRT-LLMTP29.653.522.410.4115.99gpt-oss-120bvLLMTP10.482.606.710.3010.09gpt-oss-120bvLLMTP41.024.405.570.6211.62gpt-oss-120bSGLangTP10.261.6913.460.5415.94gpt-oss-120bSGLangTP42.694.3421.690.9329.64gpt-oss-120bTRT-LLMTP10.281.515.740.267.79gpt- | 0.24 | 1.33 | 1.02 | 0.99 | 3.59 |
| Qwen3-0.6B | TRT-LLM | 5.721.430.840.168.15Qwen3-14BvLLMTP10.131.583.160.855.72Qwen3-14BvLLMTP20.572.033.430.176.19Qwen3-14BSGLangTP10.241.353.670.345.60Qwen3-14BSGLangTP20.922.173.490.877.45Qwen3-14BTRT-LLMTP16.802.702.820.1812.50Qwen3-14BTRT-LLMTP29.653.522.410.4115.99gpt-oss-120bvLLMTP10.482.606.710.3010.09gpt-oss-120bvLLMTP41.024.405.570.6211.62gpt-oss-120bSGLangTP10.261.6913.460.5415.94gpt-oss-120bSGLangTP42.694.3421.690.9329.64gpt-oss-120bTRT-LLMTP10.281.515.740.267.79gpt-oss-120bTRT-LLMTP49.993.304.340.9518.58G | 5.72 | 1.43 | 0.84 | 0.16 | 8.15 |
| Qwen3-14B | vLLM | 冷启动时间按阶段划分,单位为秒。由于四舍五入或日志与监测工具未捕获的间隔,各阶段耗时之和可能与总计略有出入。表3将恢复时间细分为代理设置、CRIU 恢复、CUDA 恢复以及唤醒/重映射。ModelEngineParallelismSnapshot: agent setupSnapshot: CRIU restoreSnapshot: CUDA restoreSnapshot: wake/remapTotal (s)Qwen3-0.6BvLLMTP12.301.360.780.224.66Qwen3-0.6BSGLangTP10.241.331.020.993.59Qwen3-0.6BTRT-LLMTP15.721.430.840.168.15Qwen3-14BvLLM | 0.13 | 1.58 | 3.16 | 0.85 | 5.72 |
| Qwen3-14B | vLLM | 0.572.033.430.176.190.241.353.670.345.600.922.173.490.877.456.802.702.820.1812.509.653.522.410.4115.990.482.606.710.3010.091.024.405.570.6211.620.261.6913.460.5415.942.694.3421.690.9329.640.281.515.740.267.799.993.304.340.9518.583.794.1820.610.0628.643.2710.8019.961.3135.349.815.3218.170.2533.554.845.7119.371.0430.964.349.7721.401.0336.545.444.7328.980.4239.563.1310.1328.600.8342.69.. | | | | | | | | | | | | 0.57 | 2.03 | 3.43 | 0.17 | 6.19 |
| Qwen3-14B | SGLang | TP1 | 0.24 | 1.35 | 3.67 | 0.34 | 5.60 |
| Qwen3-14B | SGLang | TP2 | 0.92 | 2.17 | 3.49 | 0.87 | 7.45 |
| Qwen3-14B | TRT-LLM | 表3将恢复时间细分为代理设置、CRIU 恢复、CUDA 恢复以及唤醒/重映射。 | 6.80 | 2.70 | 2.82 | 0.18 | 12.50 |
| Qwen3-14B | TRT-LLM | 表3将恢复时间细分为代理设置、CRIU 恢复、CUDA 恢复以及唤醒/重映射。 | 9.65 | 3.52 | 2.41 | 0.41 | 15.99 |
| gpt-oss-120b | vLLM | TP1 | 0.48 | 2.60 | 6.71 | 0.30 | 10.09 |
| gpt-oss-120b | vLLM | TP4 | 1.02 | 4.40 | 5.57 | 0.62 | 11.62 |
| gpt-oss-120b | SGLang | 表3将恢复时间细分为代理设置、CRIU 恢复、CUDA 恢复以及唤醒/重映射。 | 0.26 | 1.69 | 13.46 | 0.54 | 15.94 |
| gpt-oss-120b | SGLang | TP4 | 2.69 | 4.34 | 21.69 | 0.93 | 29.64 |
| gpt-oss-120b | TRT-LLM | 表3:按阶段划分的 Snapshot 恢复时间(秒)。四个阶段合计 | 0.28 | 1.51 | 5.74 | 0.26 | 7.79 |
| gpt-oss-120b | TRT-LLM | 表3:按阶段划分的 Snapshot 恢复时间(秒)。四个阶段合计构成表1中的 Snapshot 列。 | 9.99 | 3.30 | 4.34 | 0.95 | 18.58 |
| GLM-5.3-NVFP4 | vLLM | 表3:按阶段划分的 Snapshot 恢复时间(秒)。四个阶段合计构成表1中的 Snapshot 列。图5展示了 vL 的恢复时间细分 | 3.79 | 4.18 | 20.61 | 0.06 | 28.64 |
| GLM-5.3-NVFP4 | SGLang | 3.2710.8019.961.3135.34GLM-5.3-NVFP4TRT-LLMTEP89.815.3218.170.2533.55DeepSeek-V4.1-FlashvLLMTEP84.845.7119.371.0430.96DeepSeek-V4.1-FlashSGLangTEP84.349.7721.401.0336.54DeepSeek-V4-Pro-NVFP4vLLMTEP85.444.7328.980.4239.56DeepSeek-V4-Pro-NVFP4SGLangTEP83.1310.1328.600.8342.69表3:按阶段划分的 Snapshot 恢复时间(秒)。四个阶段合计构成表1中的 Snapshot 列。图5展示了 vLLM 的恢复时间细分。图5:按阶段划分的 Snapshot 恢复时间 | 3.27 | 10.80 | 19.96 | 1.31 | 35.34 |
| GLM-5.3-NVFP4 | TRT-LLM | TEP8 | 9.81 | 5.32 | 18.17 | 0.25 | 33.55 |
| DeepSeek-V4.1-Flash | vLLM | TEP8 | 4.84 | 5.71 | 19.37 | 1.04 | 30.96 |
| DeepSeek-V4.1-Flash | SGLang | 基准测试工具与复现说明见 | 4.34 | 9.77 | 21.40 | 1.03 | 36.54 |
| DeepSeek-V4-Pro-NVFP4 | vLLM | 开始使用 要试用 Snaps | 5.44 | 4.73 | 28.98 | 0.42 | 39.56 |
| DeepSeek-V4-Pro-NVFP4 | SGLang | 3.1310.1328.600.8342.69 | 3.13 | 10.13 | 28.60 | 0.83 | 42.69 |
图5展示了vLLM的恢复时间细分。
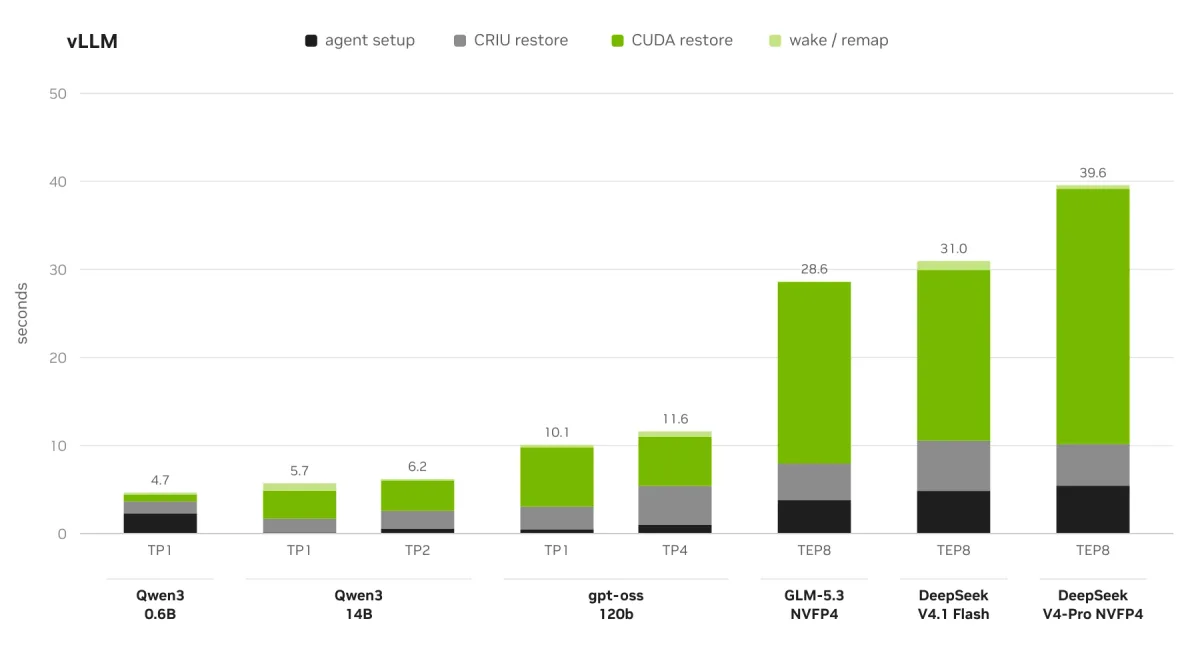
基准测试工具与复现说明 均可在该仓库中获取。
开始使用
要在 Kubernetes 上试用 Snapshot 的 GPU 工作负载,请先阅读 NVIDIA Snapshot 仓库中的安装说明和 使用指南。.
按照以下说明,使用 NVIDIA Dynamo 试用该功能以恢复 worker: 用户指南.
要讨论集成或提供反馈, 提交 issue 或加入 NVIDIA Dynamo Slack 工作区 并访问 #snapshot-dev 频道。
欢迎莅临 NVIDIA 展位 #170,KubeCon ,用于 Kubernetes 深度探讨和现场演示。
讨论(0)标签
AI 平台/部署 | 数据中心 / 云 | MLOps | 综合 | DSX | 中级技术 | 基准测试 | 云服务 | 精选 | KubeCon | Kubernetes | 开源关于作者
 关于 Dan Feigin
Dan Feigin 是 NVIDIA 的高级软件工程师,专注于容器状态恢复和 GPU 检查点/恢复机制。他致力于开发利用 Snapshot 恢复、CRIU 和 CUDA 的解决方案,以最大限度地缩短 Kubernetes 上大规模推理服务和分数 GPU 工作负载的启动时间。 查看 Dan Feigin 的所有文章
 关于 Oz Bar-Shalom
Oz Bar-Shalom 是一位拥有十年云基础设施经验的产品经理。在 NVIDIA,他负责 Run:ai 产品,帮助组织优化其 AI 基础设施。他专注于推理、多租户和基础设施兼容性方面的挑战,推动相关解决方案,使运行大规模工作负载的组织能够便捷、高效地使用复杂的 AI 系统。此前,他曾担任 Run:ai 的产品经理,并在 Oosto 担任工程领导职务,负责构建基于 AI 的产品。 查看 Oz Bar-Shalom 的所有文章
 关于 Ekin Karabulut
Ekin Karabulut 是一名数据科学家和开发者关系倡导者,曾任职于 Run:ai,现就职于 NVIDIA,探索大型模型在不同生产场景中的高效使用。此前,她研究联邦学习的隐私影响,专注于分布式训练技术,并对研究和工业环境中 GPU 使用效率低下的问题产生了浓厚兴趣。她创立了 AI Infrastructure Club,现居德国慕尼黑。 查看 Ekin Karabulut 的所有文章
 关于 Schwinn Saereesitthipitak
Schwinn Saereesitthipitak 是 NVIDIA 的软件工程师,专攻大规模分布式推理系统。他的工作贯通推理栈的研究与工程,使生产工作负载在大规模下具备弹性与韧性。 查看 Schwinn Saereesitthipitak 的所有文章