人工智能
在 vLLM 中通过双向 KV 传输改善多轮智能体工作负载的 TTFT多轮智能体工作负载建立在智能体推理、调用工具并整合先前结果时不断累积的上下文之上。每进入新一轮,客户端都会重新发送对话历史,包括系统指令、先前的提示、工具结果和模型响应,导致不断增长的上下文被反复处理。在 预填充-解码(P-D)分离架构中,每个请求被拆分到专用节点上:预填充节点处理提示并构建其键值(KV)缓存,随后解码节点获取这些 KV 块并生成响应。
然而,传统的分离式服务只在一个方向上传输 KV 缓存:从预填充节点到解码节点。这种单向流动给多轮工作负载带来了两处低效。首先,在生成响应后,解码节点同时持有提示和新生成 token 的 KV 缓存条目。处理下一轮时,预填充节点无法获取这些条目,因此必须重新计算先前响应 token 的 KV 投影。其次,解码节点维护会话状态,而预填充节点不维护,这增加了预填充节点上活跃会话的缓存被逐出的概率。在完全缓存未命中的情况下,预填充节点必须重新计算整个对话历史的 KV 投影,包括系统指令、先前的用户请求、工具结果和模型生成的响应。随着对话增长,这种冗余工作会消耗更多加速器容量,并增加首 token 延迟(TTFT)。
在构建对话式助手和智能体应用时,更长的交互历史会因重复的预填充计算而增加延迟并消耗加速器容量。在本文中,我们将展示 双向 KV 缓存传输 如何让预填充节点和解码节点跨轮次复用先前计算过的上下文,从而提升加速器利用率,并帮助应用在对话增长时保持响应迅速的 TTFT。
在我们使用 Amazon Elastic Compute Cloud(Amazon EC2)P5en 实例进行 1P1D 部署的多轮基准测试中,双向 KV 传输使 Qwen3-32B 的 TTFT 最高改善 1.6 倍,使 zai-org/GLM-5-FP8 最高改善 3.3 倍(参见性能数据部分)。结果会因工作负载和配置而异。这些实例通过 AWS Elastic Fabric Adapter(AWS EFA)连接,这是一种在 AWS 中各服务器之间使用的低延迟远程直接内存访问(RDMA)网络。在 受支持的实例类型上,AWS EFA 支持 GPUDirect RDMA 和 Neuron Direct RDMA,可在预填充节点和解码节点的 GPU 或 AWS Trainium 设备内存之间直接移动 KV 块。
我们最初在通过 EFA 连接的 AWS Trainium 实例集群上构建并验证了该功能,并将其作为与加速器无关的能力贡献给 vLLM。本文展示的结果来自配备 EFA 的 Amazon EC2 P5en GPU 集群,表明这些优势同样适用于 GPU。本文介绍了双向 KV 传输架构、路由器元数据流、KV 块保留与重计算控制、性能结果,以及如何复现该基准测试。
双向 KV 传输
双向 KV 传输是一种机制,解码节点在对话的后续轮次中将先前计算好的 KV 返回给预填充节点。这避免了在预填充节点上重新计算共享上下文,并由可配置的 KV 重计算阈值控制。它缓解了前文描述的两类计算冗余场景。要使其生效,KV 必须在其产生的轮次之后继续存活,并沿反方向传输,由具备 KV 缓存感知能力的路由器进行协调。
面向双向传输的 NIXL KV 连接器增强
我们扩展了 NVIDIA Inference Xfer Library(NIXL) KV 连接器 ,使预填充节点能够消费远程 KV 块,类似于解码节点已经消费预填充节点提供的 KV 块的方式。这并非简单的改动,因为这两类节点在架构上不同:预填充节点为新提示 token 计算 KV 表示,并能提供完整的提示 KV 块。解码节点缺乏生成完整 KV 表示的能力(或效率),只能提供先前缓存的 KV 块。因此,预填充节点和解码节点仍各自承担计算远程和本地 KV 块元数据的角色与逻辑。不过,实际的 KV 传输机制(NIXL READ)在 P->D 和 D->P 两个方向上都是通用的。
下图首先以蓝色展示现有流程。路由器将请求发送到预填充节点,预填充节点计算提示 KV 并返回其块元数据,随后路由器将请求和元数据转发到解码节点,以执行标准的 P→D NIXL READ。带编号的红色路径展示了双向 KV 传输的新增部分:(1) 解码节点在生成后保留符合条件的 KV 块,(2) 在流式响应中返回其元数据,(3) 路由器缓存该元数据以供下一次预填充请求使用。随后预填充节点 (4) 在应用本地缓存匹配后检查可远程复用的 KV,(5) 当可复用 token 数量达到阈值时排队一次异步接收,并 (6) 在计算剩余后缀之前执行 D→P NIXL READ。
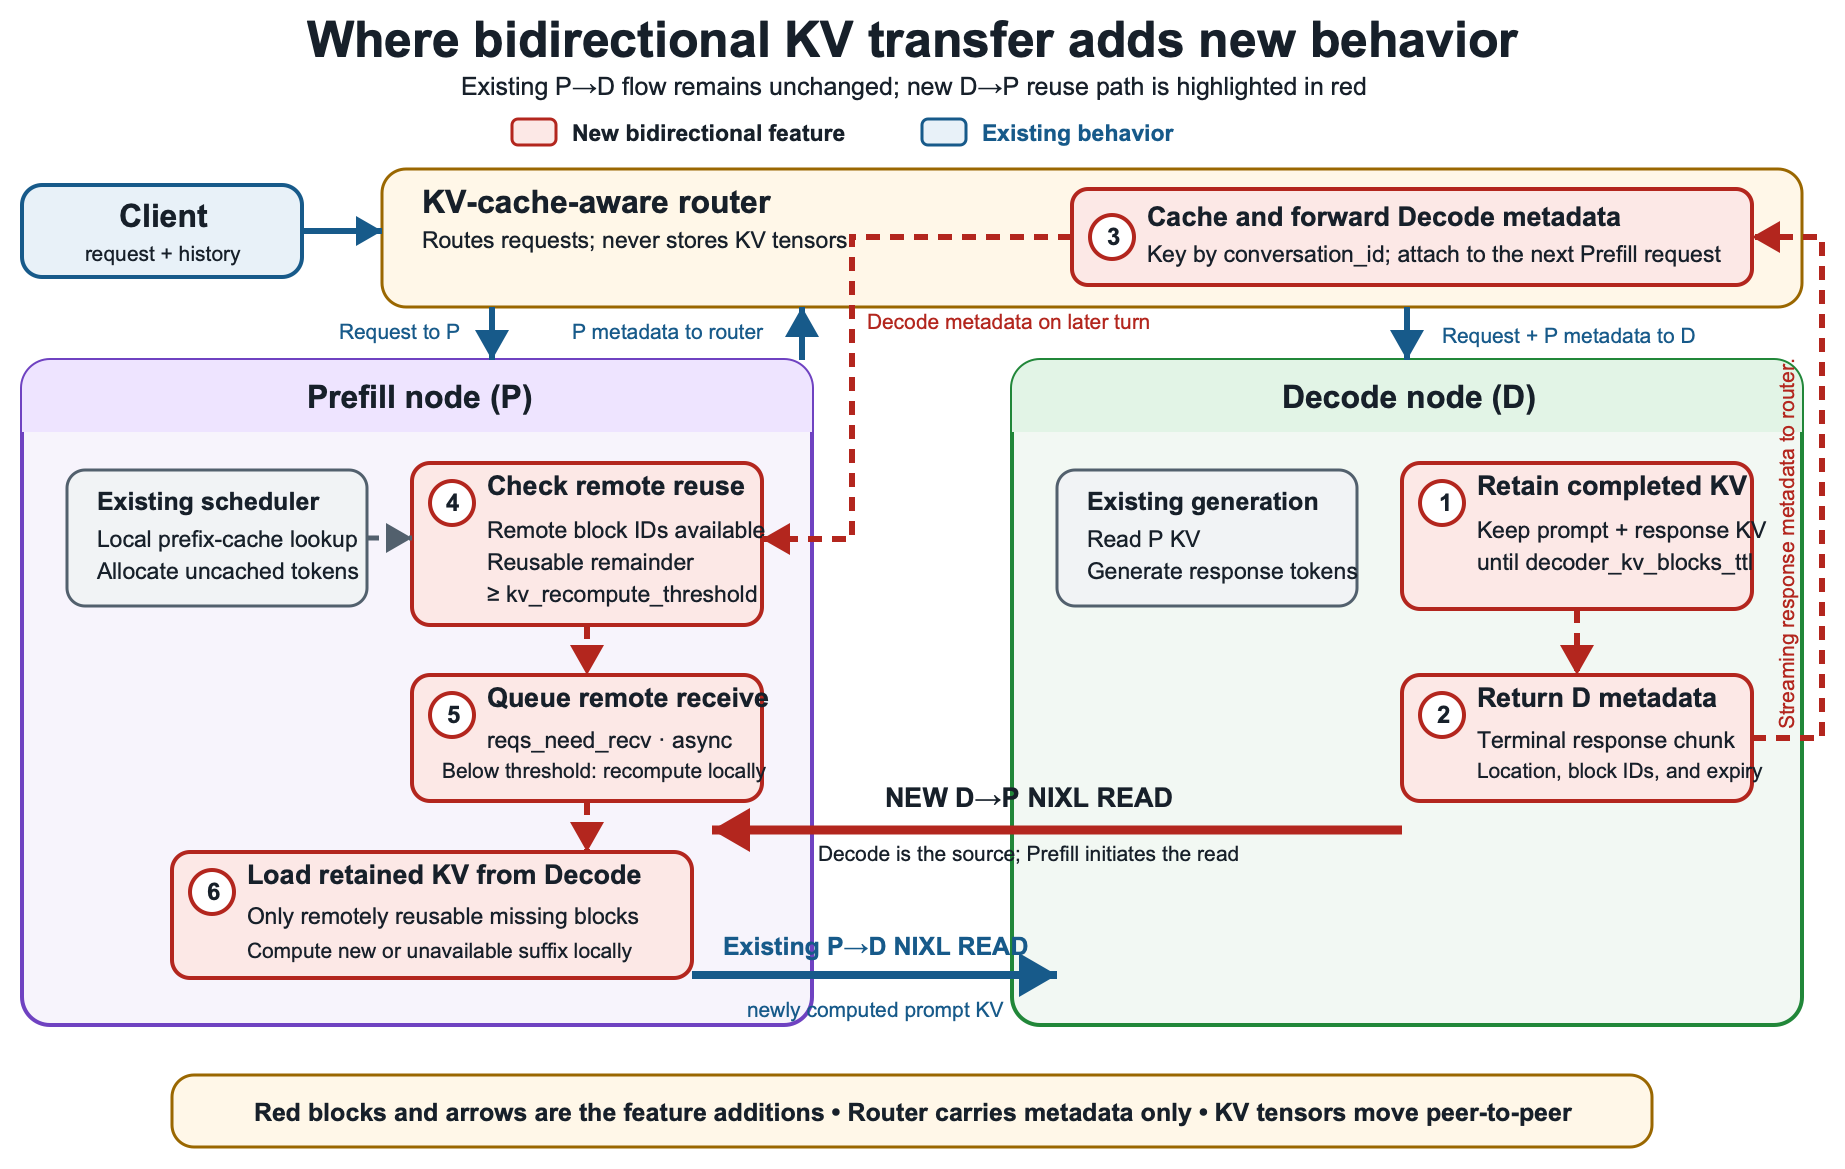
图 1:标准的预填充到解码流程(蓝色)以及双向 KV 传输的新增部分(红色)
KV 缓存感知路由器
vLLM 在连接器侧包含对双向 KV 传输的支持,而跨对话轮次协调 KV 复用则需要具备 KV 缓存感知能力的路由器。vLLM GitHub 提供了一个 示例代理 ,它实现了本文所用的流程,可针对你的环境进行调整。
KV 缓存感知路由器是位于客户端、预填充节点和解码节点之间的轻量级有状态控制平面组件。它维护一个内存中的映射,从客户端提供的 conversation_id 到解码节点的 kv_transfer_params路由器只存储块位置元数据,而不存储 KV 张量,并且它从响应流中获取该元数据,而不是单独查询解码节点。
下图展示了路由器如何在多轮对话中管理 KV 元数据。在第一轮中,缓存查找未命中,请求遵循标准的 P→D 流程。随后路由器从响应流中保存解码节点的元数据。在后续轮次中,路由器使用该元数据来检索 conversation_id ,以便预填充节点能够复用来自解码节点的 KV。然后在生成完成后刷新元数据,供下一轮使用。
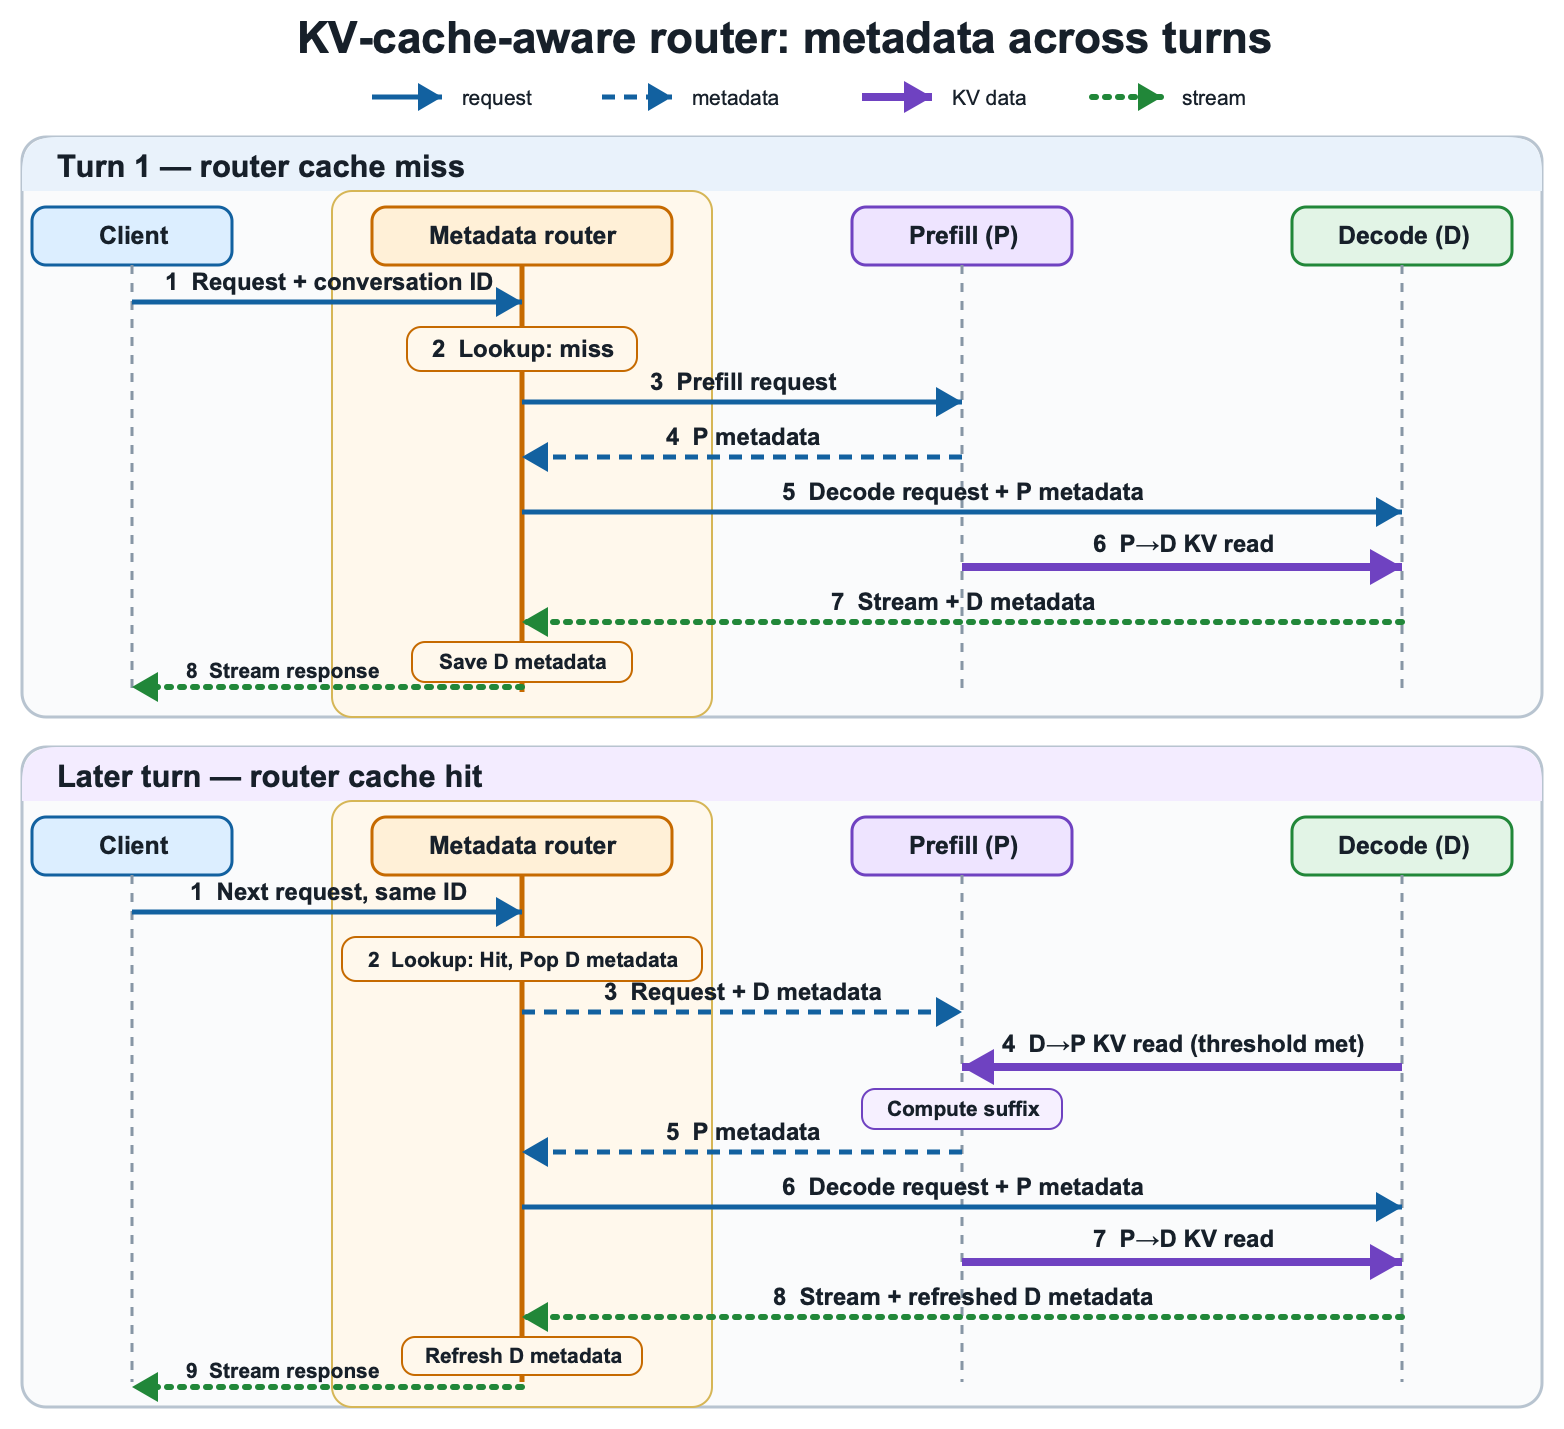
图 2:KV 缓存感知路由器在对话轮次间的元数据流转
块保留 TTL
通常,解码实例在生成完成后会立即释放请求的块。在双向 KV 传输模式下,它会将这些块保留一段可配置的生存期(decoder_kv_blocks_ttl,默认 480 秒),并发布其位置和过期时间。这样,对话的 KV(包括提示前缀和生成的响应)就能在下一轮中继续可用。对于在生存期(TTL)到期之前到达的轮次,预填充节点会复用该 KV。对于之后到达的轮次,则回退到常规预填充。由于该 TTL 是固定的且不会续期,应根据轮次之间的预期时间来调整它,以在 KV 复用与加速器内存使用之间取得平衡。一个自然的后续改进是将心跳续期的租约扩展到解码侧。这样,解码实例就可以在对话空闲时立即回收块,而不是等到固定计时器结束。
KV 重算阈值
KV 复用并不总是比本地重算更快。对于较短的可复用前缀,互连和协调开销可能超过重算这些 token 所需的时间。 kv_recompute_threshold 设置(默认 64 个 token)控制这一决策。当需要计算的 token 数低于阈值时,预填充节点会重算;当达到或超过阈值时,则从解码节点拉取 KV。部署方可以根据模型计算时间、KV 大小和互连性能来调整该值。
性能数据
在评估中,我们在 1P1D 部署上使用了 Qwen3-32B 和 GLM-5-FP8 模型,采用通过 EFA 连接的 Amazon EC2 P5en 实例。为了模拟预填充节点已驱逐其本地缓存,或路由器选择了另一个没有该对话 KV 块的预填充节点的场景,我们通过以下方式在预填充节点上禁用了前缀缓存: --no-enable-prefix-caching.
在两个模型上,开启双向 KV 传输都能减少多轮对话中的预填充计算量,而且收益通常随提示长度增加而增长。关闭该功能时,预填充实例每轮都会重算整个增长的上下文,因此 TTFT 急剧上升。Qwen3-32B 从 2k 时的 158 ms 上升到 24k 时的 778 ms,GLM-5-FP8 从 2k 时的 500 ms 上升到 20k 时的 2,334 ms。开启该功能后,解码实例保留的 KV 会被复用而不是重算,使 TTFT 保持平稳得多。Qwen3-32B 在同一范围内仅从 122 ms 上升到 460 ms(在最长提示下约降低 1.6 倍),而 GLM-5-FP8 从 358 ms 上升到 702 ms,在长提示下比重算路径低至多 3.3 倍。预填充耗时的分解说明了原因。
双向传输会增加少量 KV 传输时间(Qwen3-32B 约为 30 ms 至 130 ms;GLM-5-FP8 约为 29 ms 至 110 ms),但它所省去的预填充计算远超这一 KV 传输时间。因此,开启传输后的总预填充时长(Qwen3-32B:128 ms 至 414 ms;GLM-5-FP8:316 ms 至 541 ms)仍远低于仅重算路径(Qwen3-32B:153 ms 至 744 ms;GLM-5-FP8:500 ms 至 2,331 ms)。更大的 GLM-5-FP8 模型表现出更大的绝对差距和相对差距,因为其更高的单 token 重算时间使得 KV 复用随着模型和上下文规模的增长而收益更大。
Qwen3-32B
下图绘制了 Qwen3-32B 的 TTFT 随提示长度变化的曲线,对比了双向 KV 传输开启与关闭两种情况。
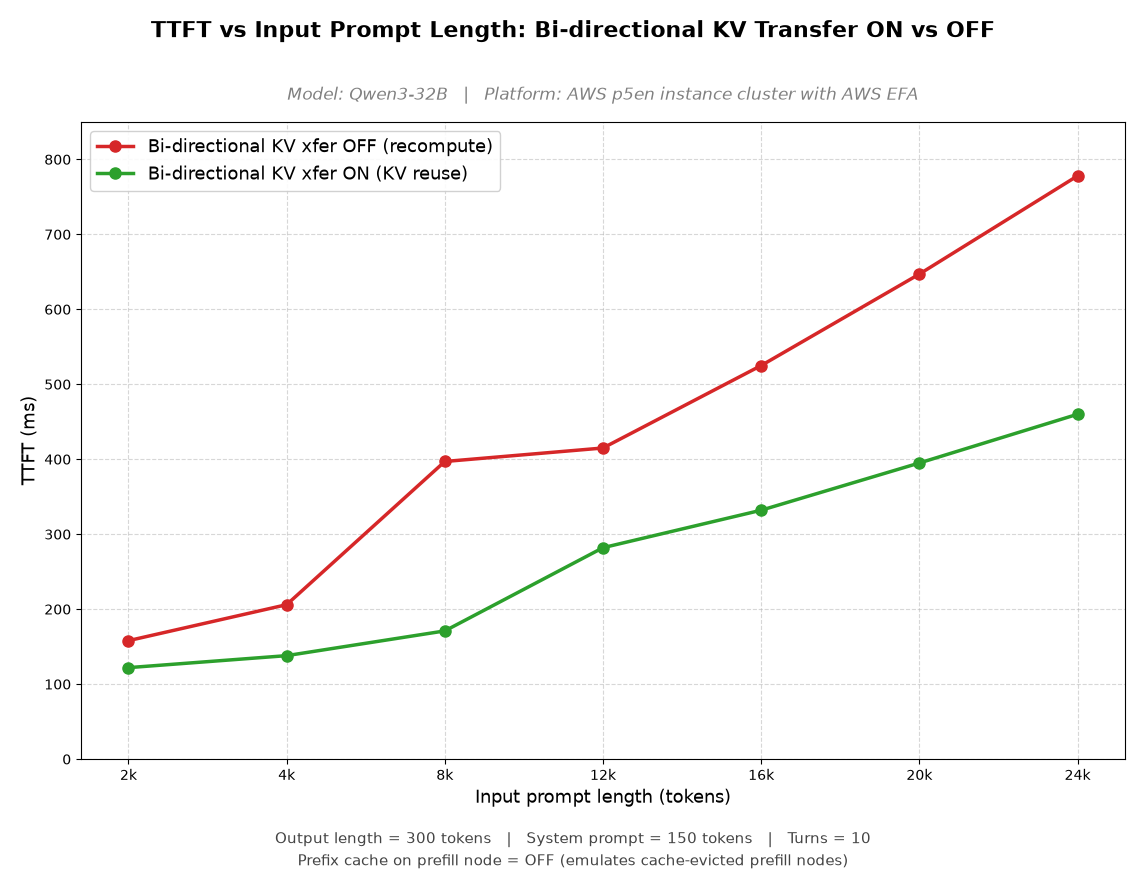
图 3:双向 KV 传输开启与关闭时 Qwen3-32B 的 TTFT 随提示长度变化
下一张图将相同运行的预填充时长拆分为重算和 KV 传输两个组成部分。
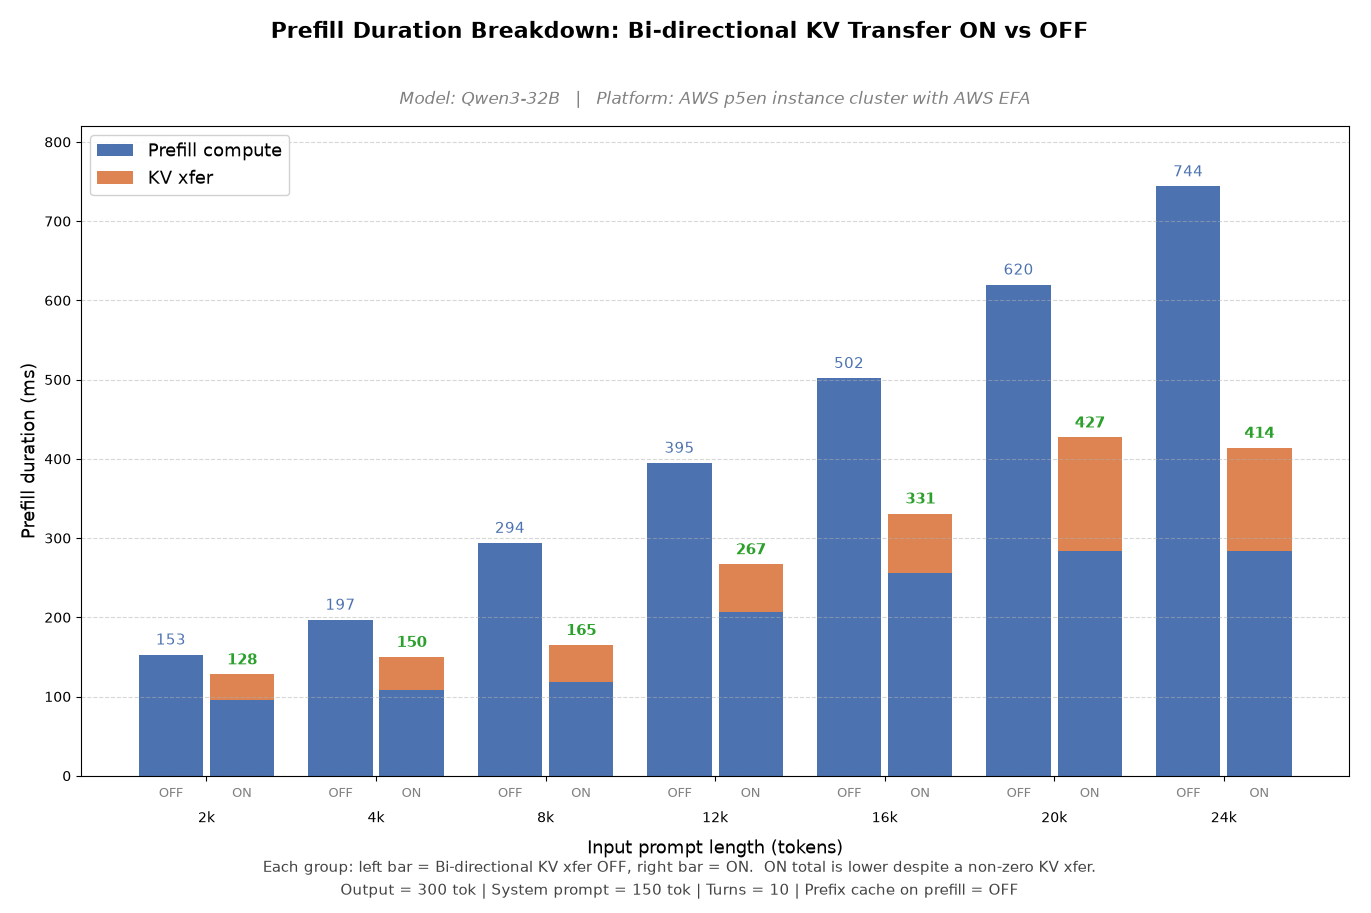
图 4:Qwen3-32B 预填充时长拆分为重算和 KV 传输两部分
两张图共同表明,开启该功能时 TTFT 几乎保持平稳,而关闭时该路径随上下文增长而急剧攀升,因为少量 KV 传输时间远小于它所省去的重算时间。
zai-org/GLM-5-FP8
GLM-5-FP8 也采用同样的两个视角。第一张图绘制了该功能开启与关闭时 TTFT 随提示长度变化的曲线。
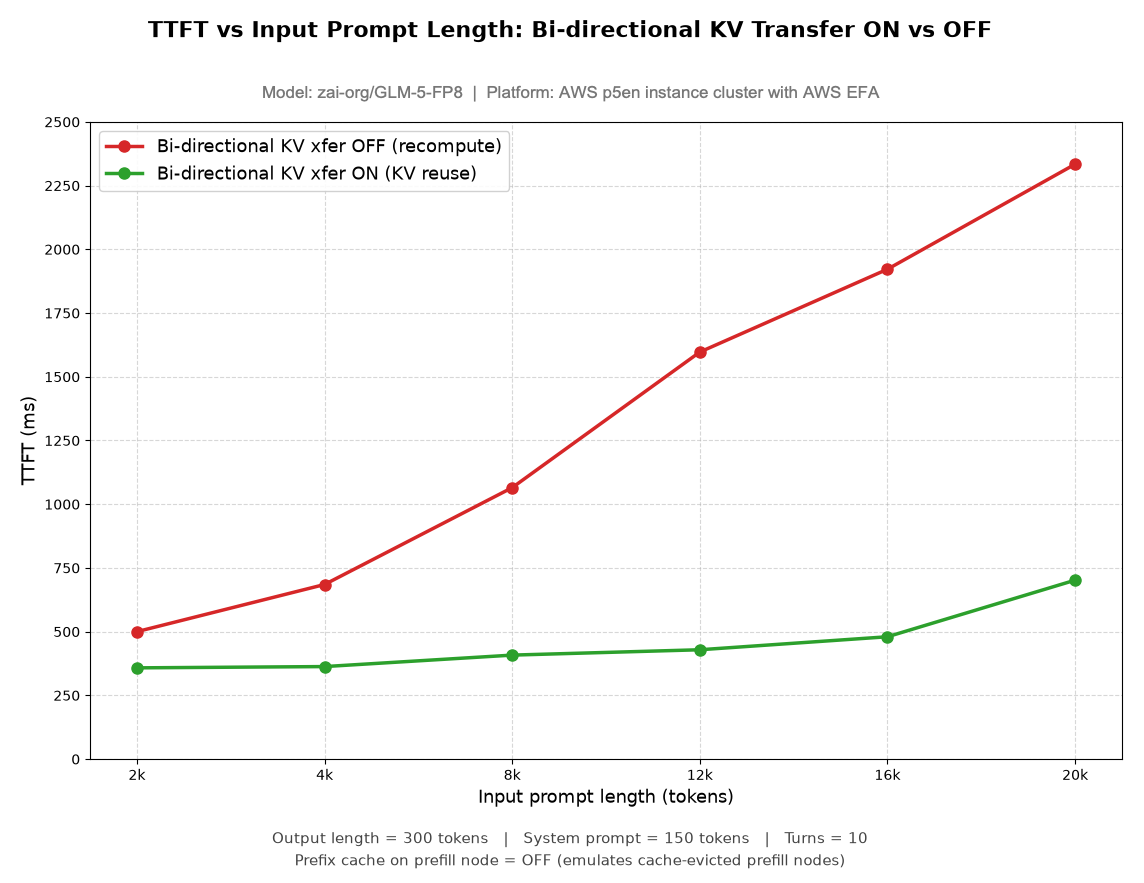
图 5:zai-org/GLM-5-FP8 在 KV 复用开启与关闭时的 TTFT
第二张图将预填充时长拆分为重算和 KV 传输两个组成部分。
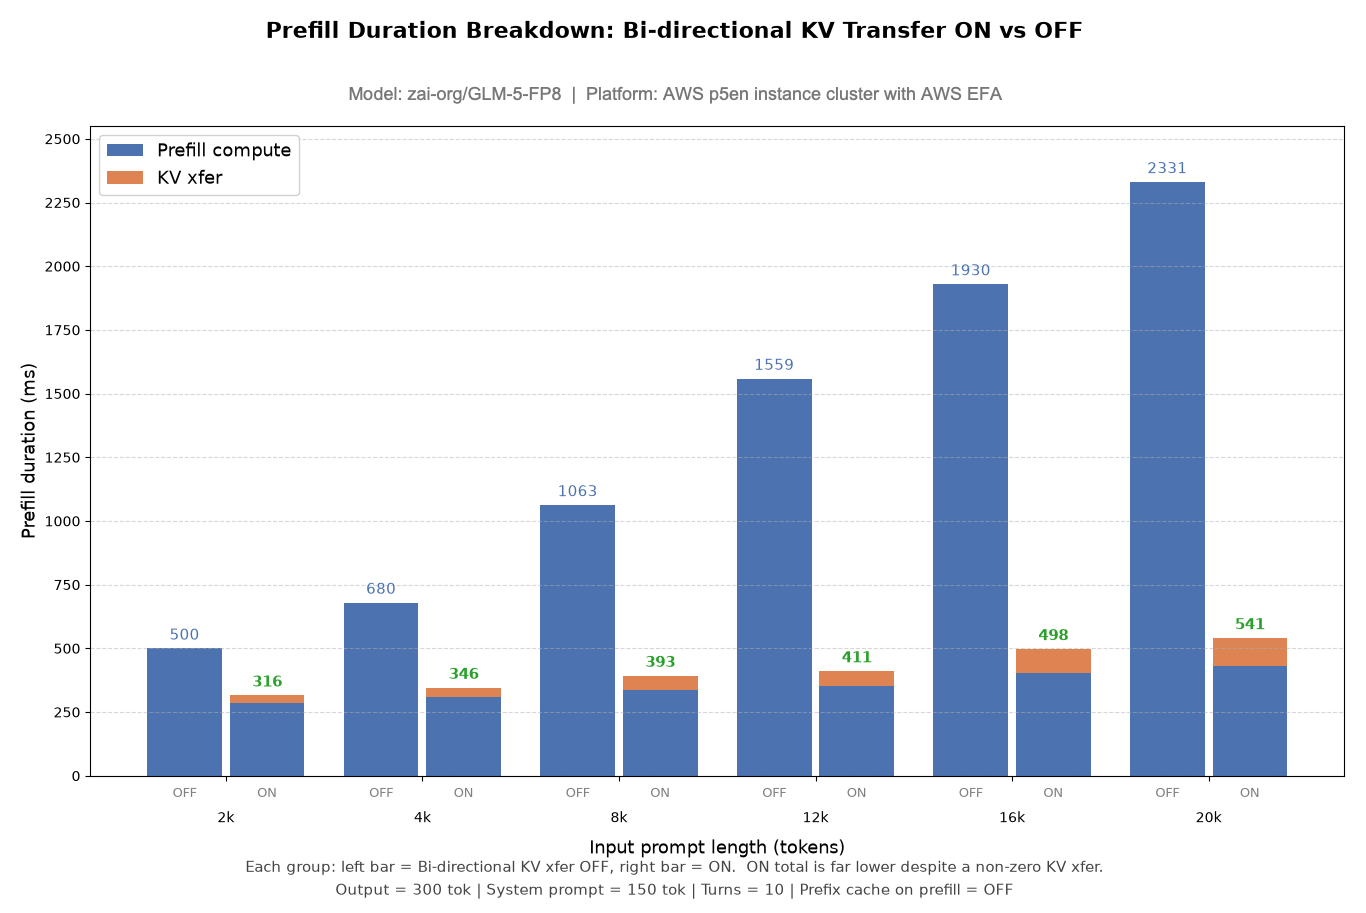
图 6:zai-org/GLM-5-FP8 预填充时长分解
GLM-5-FP8 表现出的差距远大于 Qwen3-32B,在长提示下 TTFT 最多降低约 3.3 倍,因为其更高的单 token 重算时间使得 KV 复用随着上下文长度增长而收益更大。
如何运行基准测试
要复现我们的 1P1D 基准测试配置(一个预填充节点和一个解码节点,使用带 EFA 的 Amazon EC2 P5en 实例),请按照 复现我们的结果指南中的分步说明操作。该指南涵盖环境搭建、启动 vLLM 预填充和解码服务器、运行基准测试以及收集结果。该功能也可在其他受支持的配置上运行,但性能结果会因硬件、模型、工作负载和网络配置而异。
结论
在本文中,我们展示了双向 KV 缓存传输如何在智能体的对话历史增长时降低 TTFT。在 P-D 分离部署中,该功能让预填充节点能够跨轮次复用解码节点保留的 KV 块,从而减少重复计算。可配置的块保留阈值和重算阈值决定了何时进行复用。在使用通过 EFA 连接的 Amazon EC2 P5en 实例的 1P1D 部署上,在所测试的最长提示长度下,我们观察到 Qwen3-32B 的 TTFT 降低 1.6 倍,zai-org/GLM-5-FP8 降低 3.3 倍。结果取决于工作负载和部署配置。要在您的环境中实现这一点,请使用 vLLM v0.21.0 或更高版本配合 NixlConnector,在预填充和解码服务器上均启用 bidirectional_kv_xfer ,使用具备 KV 缓存感知能力的路由器,并遵循 GitHub 复现指南.
相关资源
致谢
我们感谢 vLLM 社区对维护此功能的支持。