人工智能
用 Amazon Bedrock 和 LiteLLM 构建自助式 LLM 网关开发者希望 AI 编码助手能够以最少的配置即可使用。借助大语言模型(LLM)网关和 LiteLLM,他们可以快速访问 Amazon Bedrock 上提供的基础模型(FM),同时你也能获得可见性和使用控制。平台团队需要监控延迟和错误,财务团队需要将推理成本归属到团队和项目,安全团队需要一致的访问控制。LLM 网关可以通过提供一个集中管理的访问点来帮助满足这些需求,该访问点用于访问为编码助手提供支持的模型。
在本文中,我们将展示如何使用 Amazon Bedrock Application Inference Profiles 配合运行在 AWS Fargate 上的 LiteLLM 构建自助式 LLM 网关,从而将 Amazon Bedrock 抽象在 OpenAI 兼容 API 之后。采用这种模式,开发者可以通过单一 API 和专属密钥访问基础模型,同时你也能获得按用户的成本控制和模型性能可观测性。读完后,你将充分理解这一模式,能够根据文中的示例代码片段和 AWS Cloud Development Kit(AWS CDK)构造构建自己的版本。本文以 Claude Sonnet 和 Claude Haiku 模型为例。有关模型列表及各 AWS 区域的可用性,请参阅 Amazon Bedrock 中各 AWS 区域支持的模型.
这一 LLM 网关模式遵循一条直接的请求流程:从开发者出发,经过 LiteLLM 层,到达 Amazon Bedrock 及底层 FM。下图展示了该流程背后的生产拓扑。为简化起见,我们未涵盖 Amazon Bedrock Guardrails(如内容过滤和接地)的添加,但在部署到生产环境之前,你通常会纳入适当的负责任 AI 控制措施。
开发者的 OpenAI 兼容客户端通过 Amazon Route 53、Amazon CloudFront 和 Application Load Balancer(ALB)到达 LLM 网关。它使用按用户的 API 密钥向 Fargate 上的 LiteLLM 进行身份验证。在此之后,请求会使用 Amazon Relational Database Service(Amazon RDS)(PostgreSQL)来存储虚拟密钥和支出状态。它还会与作为缓存的 Amazon ElastiCache for Valkey 以及用于存储密钥的 AWS Secrets Manager 交互。随后,LiteLLM 最终使用具有限定范围的 AWS Identity and Access Management(IAM)任务角色调用 Amazon Bedrock Application Inference Profiles。Amazon CloudWatch 捕获每分钟请求数(RPM)和每分钟令牌数(TPM)指标以及配额告警。
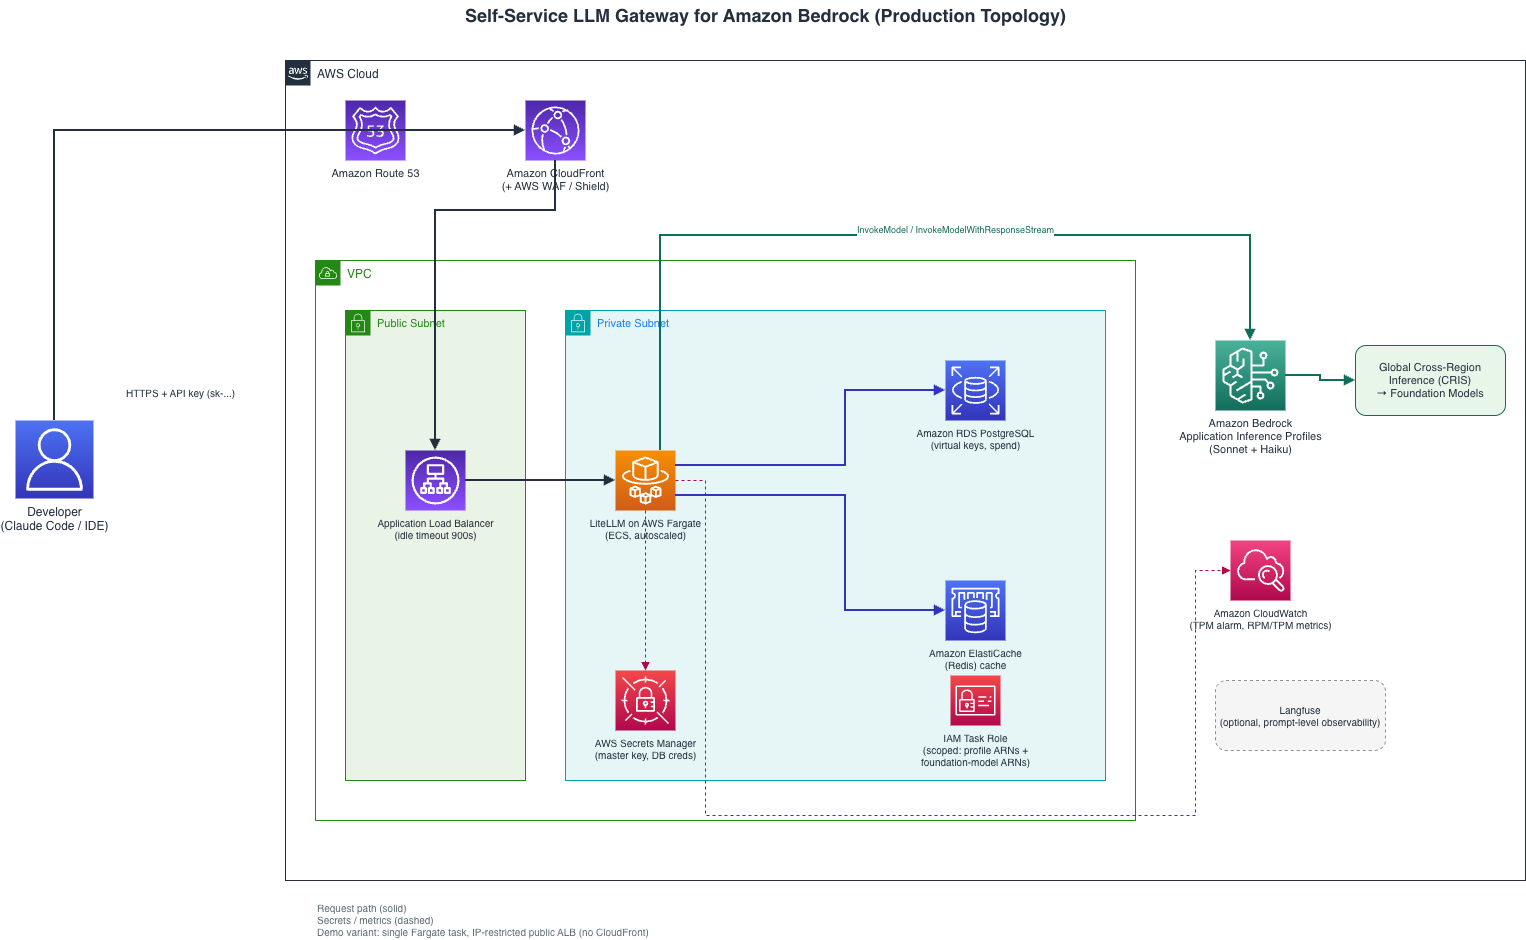
图 1:LLM 网关架构(生产拓扑)
该架构由以下核心组件组成:
- AWS Fargate 上的 LiteLLM: LiteLLM 提供一个暴露 OpenAI 兼容 API 的代理。我们将其运行在 AWS Fargate 任务上,并基于 CPU 利用率进行目标跟踪式 Auto Scaling。开发者将其工具指向此端点,而不直接与 Amazon Bedrock 交互。
- 自助服务门户: LiteLLM 包含一个轻量级门户,供管理员和开发者自助使用。该 Web 应用可与你的企业单点登录(SSO)集成。通过该门户,运维工程师设置支出策略,而开发者则在这些参数范围内自行配置 API 密钥。
- 持久化与缓存存储: LiteLLM 使用 Amazon ElastiCache for Valkey 进行非持久化响应缓存。它还会在多个 AWS Fargate 任务之间协调限流。一个单独的 Amazon RDS(PostgreSQL)数据库是持久化状态的记录数据库,例如 API 密钥元数据和支出跟踪。
- Amazon Bedrock Application Inference Profiles: 每个模型(如 Claude Sonnet 和 Claude Haiku)都有自己的推理配置文件,你可以使用 AWS Cloud Development Kit(AWS CDK)进行管理。借此,你可以获得按模型的配额隔离,以及 LiteLLM 配置与 Amazon Bedrock 模型版本管理之间的清晰抽象层。
- Langfuse: 开源 LLM 可观测性工具,用于提示级遥测、延迟跟踪和调试。它以应用级洞察补充 Amazon CloudWatch 的基础设施级指标。
通过使用 OpenAI 兼容协议,开发者可以用单一的 base URL 和 API 密钥配置其工具,例如 Claude Code、Continue 和 Cursor。这样,开发者就在 Amazon Bedrock 后端之上进行操作,并且可以更换模型、添加回退或迁移模型提供商,而无需改动开发者配置。
先决条件
你需要一个 AWS 账户、Amazon Bedrock 模型访问权限以及适当的 IAM 权限来部署此项目。你还需要 LiteLLM。LiteLLM AI Gateway 组件是开源的,适合有一定限制的小规模试点。 LiteLLM 文档 说明 AI Gateway 最多可供五个用户免费使用,超过则需许可证。LiteLLM Enterprise 是可扩展、面向生产的许可版本,包含开源网关以及单点登录、审计日志、委派管理员角色和支持。虽然免费层支持虚拟密钥,但本文所述的自助密钥发放需要 Enterprise 版本。
端到端配置:从左到右
我们将逐一介绍从开发者机器到基础模型的每个配置层。
步骤 1:开发者 IDE 配置(例如 Claude Code)
开发者配置其编码助手指向 LLM 网关。这是开发者对其工具唯一需要进行的配置:
{
  "apiProvider": "openai-compatible",
  "apiBaseUrl": "https://llm-gateway.internal.example.com/v1",
  "apiKey": "sk-user-abc123",
  "model": "claude-sonnet-4-20250514"
}
通过该配置,每位开发者从自助服务门户获取自己的 API 密钥,并将其填入工具配置中。
步骤 2:LiteLLM 网关配置
按照 LiteLLM 文档. 将 LiteLLM 部署到容器服务。在本示例中,我们使用 AWS Fargate。这将包含门户,你可以在本地测试时于 http://localhost:4000/ui 打开它。
LiteLLM 网关是你将模型名称映射并强制到 Amazon Bedrock 推理配置文件 ARN 并设置按密钥支出限制的地方:
model_list:
  - model_name: claude-sonnet-4-20250514
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/sonnet-profile-id
      aws_region_name: us-east-1
      max_retries: 3
      timeout: 900  # 15 min for extended thinking
    # REQUIRED for spend tracking: when `model` is a raw inference-profile ARN,
    # LiteLLM can't find it in its built-in cost map and defaults the cost to $0
    # which means per-key `spend` stays 0 and budgets NEVER enforce. Set the
    # per-token costs explicitly.
    model_info:
      input_cost_per_token: 0.000003        # example cost
      output_cost_per_token: 0.000015    # example cost

  - model_name: claude-haiku-4-5
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/haiku-profile-id
      aws_region_name: us-east-1
      timeout: 120
    model_info:
      input_cost_per_token: 0.000001       # example cost
      output_cost_per_token: 0.000005    # example cost

litellm_settings:
  max_budget: 250            # example per key cost
  budget_duration: 7d      # Rolling 7-day window
  max_parallel_requests: 10
  set_verbose: false
  cache: true
  cache_params:
    type: redis    # Valkey is protocol-compatible, so this stays "redis"
    host: elasticache-endpoint
    port: 6379
master_key: os.environ/LITELLM_MASTER_KEY
database_url: os.environ/DATABASE_URL
在 Fargate 任务上从 AWS Secrets Manager 设置:
LITELLM_MASTER_KEY=sk-platform-admin-... DATABASE_URL=postgresql://user:password@rds-endpoint:5432/litellm注意: 不要在 master_key 中硬编码 config.yaml或数据库凭据。LiteLLM 在加载时解析 os.environ/VAR_NAME 引用在加载时解析,因此请在 Fargate 任务上将 LITELLM_MASTER_KEY 和 DATABASE_URL 设置为环境变量,并从 AWS Secrets Manager 获取。在第 5 步中以相同方式设置 Langfuse 凭据。
当开发者调用 claude-sonnet-4-20250514时,例如,LiteLLM 会将其解析为推理配置文件 ARN。然后它使用 AWS Fargate 任务的 IAM 角色向 Amazon Bedrock 进行身份验证,并以 OpenAI 格式流式返回响应。
第 3 步:Bedrock 推理配置文件(CDK)
借助 Amazon Bedrock 应用程序推理配置文件 ,你可以为特定模型创建命名端点,从而获得配额隔离和精细的 IAM 控制。
选择跨区域推理(CRIS):地理范围或全球范围
Amazon Bedrock CRIS 避免了自行实现跨区域请求路由的开销。其他优势包括:
- 可访问更广泛的区域容量池。
- 自动将请求路由到具有可用容量的受支持区域。
- 更广泛的模型选择,因为某些模型只能通过推理配置文件使用。
对于此代理模式,当所选模型支持且组织策略允许在受支持的 AWS 商业区域范围内进行推理处理时,我们建议使用全球跨区域推理。地理跨区域推理将处理限制在定义的地理范围内。例如,美国推理配置文件仅将请求路由到受支持的美国区域。与地理跨区域推理相比,全球跨区域推理可访问更广泛的区域容量池,并可能带来定价优势。你可以通过当前的 AWS 文档和 AWS 定价页面验证模型可用性、适用的服务配额以及特定模型的定价。
CDK 构造
import * as cdk from 'aws-cdk-lib';
import * as bedrock from 'aws-cdk-lib/aws-bedrock';
import * as iam from 'aws-cdk-lib/aws-iam';

// Create an Application Inference Profile pointing to the Global CRIS
// system-defined inference profile (note the `global.` prefix in the ARN).
const sonnetProfile = new bedrock.CfnApplicationInferenceProfile(this, 'SonnetProfile', {
  inferenceProfileName: 'claude-sonnet-gateway',
  modelSource: {
    copyFrom: `arn:aws:bedrock:us-east-1:${this.account}:inference-profile/global.anthropic.claude-sonnet-4-20250514-v1:0`,
  },
  description: 'Claude Sonnet for developer coding assistants (Global CRIS)',
});

// Grant LiteLLM's task role access to invoke the profile.
// For Global CRIS, include the inference profile, the regional FM, and the global FM resources.
litellmTaskRole.addToPolicy(new iam.PolicyStatement({
  effect: iam.Effect.ALLOW,
  actions: ['bedrock:InvokeModel', 'bedrock:InvokeModelWithResponseStream'],
  resources: [
    sonnetProfile.attrInferenceProfileArn,
    'arn:aws:bedrock:us-east-1::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
    'arn:aws:bedrock:*::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
  ],
}));
重要提示: 对于全球 CRIS, copyFrom ARN 必须引用以 为前缀的 global.系统定义的推理配置文件,而不是直接引用基础模型 ARN。使用基础模型 ARN 会创建没有跨区域路由的单区域配置文件。此外,IAM 策略必须包含调用实际触及的资源 ARN:应用程序推理配置文件 和 它可能路由到的任何区域中的底层基础模型(区域通配符)。仅限定到应用程序推理配置文件 ARN 会在调用时返回 not authorized to perform: bedrock:InvokeModel on resource: arn:aws:bedrock:us-east-1::foundation-model/... 。这是按最小权限范围限定的:它指定了正在使用的确切模型,而不是 bedrock:* 或 *.
第 4 步:Bedrock 调用基础模型
推理配置文件无需额外配置即可透明地处理模型解析和跨区域路由。当 LiteLLM 调用推理配置文件 ARN 时,Amazon Bedrock 会路由到已配置 AWS 区域中的可用容量并返回响应。
第 5 步:Langfuse 可观测性
LiteLLM 通过日志回调与 Langfuse 集成,无需更改开发者工具配置即可提供对模型调用的可见性。要启用该集成,请将以下条目合并到第 2 步配置中现有的 litellm_settings 块中,同时保留现有的回调条目:
litellm_settings:
  success_callback: ["langfuse"]
  failure_callback: ["langfuse"]  # also log failed requests
在 Fargate 任务上将 Langfuse 公钥、密钥和部署端点配置为环境变量。将凭据存储在 AWS Secrets Manager 中:
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://us.cloud.langfuse.com  # or your self-hosted URL
端点必须与所选的 Langfuse Cloud 区域或自托管部署匹配。根据数据治理和运营要求选择托管选项。在启用提示和响应日志记录之前,请审查集成捕获的内容,并配置适当的脱敏、保留和访问控制。
根据集成和日志记录配置,Langfuse 跟踪可以包含提示、响应、模型参数、令牌使用量和延迟。此信息有助于调查意外的模型响应,并补充 Amazon CloudWatch 中收集的运营指标。
实施成本控制
成本控制是成功 AI 战略的重要维度。如果没有成本控制,大量使用扩展思考功能可能会导致意外的高额费用,我们在早期试点中观察到了这一点。
第 2 步中配置的支出限制(max_budget: 250, budget_duration: 7d)为每个 API 密钥强制执行滚动 7 天窗口,前提是设置了每个模型的 model_info 成本(请参阅第 2 步注释)。当用户达到其限制时,LiteLLM 会返回 HTTP 429 代码,并附有明确消息说明其预算已超出。不会有静默降级或意外账单。开发人员和工程团队可以通过以下任一方式检查当前支出和重置时间:
- 每日支出: 使用 和 范围查询
start_dateGET /user/daily/activityend_date,以获取按天指标:支出、提示令牌、补全令牌和 API 请求,并按模型、提供商和 API 密钥细分。 - 每用户支出: 查询 GET /user/info?user_id=… ,以获取用户总支出及其每个关联 API 密钥支出的摘要。
- 门户仪表板: Admin UI (位于
https://<proxy-host>/ui)包含一个 Usage 选项卡,开发人员和管理员可以在其中按模型、用户和标签浏览支出,而无需直接访问 API。
这些相同的端点正是你的财务团队获取按用户归因的方式,而无需你构建自定义计量基础设施。一个定时任务调用 /user/daily/activity 或 /global/spend/report 就足以向成本仪表板或计费报告提供数据。
开发者自助服务门户
自助服务门户还处理密钥生命周期流程。开发人员使用你的企业 SSO 进行身份验证,以生成绑定其身份的密钥,之后如果密钥泄露或为了符合轮换策略,他们可以重新生成该密钥。平台工程师为单个开发人员一次性配置预算策略,使其能够在约束范围内自主操作。开发人员直接使用门户进行的两件事:
- 密钥生成: 在 Admin UI 的 Virtual Keys 页面 (
https://<proxy-host>/ui上),通过 SSO 身份验证的开发人员选择 Generate Key 来创建自己的密钥,并绑定其身份。 - 速率限制可见性: 每个
/chat/completions响应都包含x-litellm-key-remaining-requests-{model}和x-litellm-key-remaining-tokens-{model}标头,因此开发人员可以直接在其工具的响应中看到该模型剩余的 RPM 和 TPM 余量。这与本文前面基于美元的支出跟踪不同。
监控与可观测性
对于 LLM 网关而言,延迟百分位数等传统指标可能会产生误导,尤其是在扩展思考模型下,单个请求可能耗时数分钟。因此,我们重点关注 每分钟请求数(RPM) 和 每分钟令牌数(TPM) 作为主要信号。在这方面,Amazon CloudWatch 可以通过以下配置帮助你监控这些信号并设置告警。
用于配额管理的 Amazon CloudWatch 告警
new cloudwatch.Alarm(this, 'BedrockTPMAlarm', {
  metric: new cloudwatch.Metric({
    namespace: 'LiteLLM/Gateway',
    metricName: 'TokensPerMinute',
    statistic: 'Sum',
    period: cdk.Duration.minutes(1),
  }),
  // Alert at ~60% of your account's TPM quota (check Service Quotas for your
  // actual limit, defaults vary by model and account).
  threshold: 600000,
  evaluationPeriods: 3,
  comparisonOperator: cloudwatch.ComparisonOperator.GREATER_THAN_THRESHOLD,
  alarmDescription: 'TPM approaching Bedrock quota - request increase proactively',
});
请注意,该告警配置在配额利用率达到 60–70% 时就会发出提醒,而不是等到发生限流才告警。这为在用户体验下降之前扩展 Amazon Bedrock 配额提供了提前量。
发出指标: LiteLLM 没有内置回调可以将名为 TokensPerMinute 的指标发布到 LiteLLM/Gateway 命名空间,因此告警需要一个数据来源。一个小的自定义日志记录器回调,在每次请求时调用 CloudWatch PutMetricData 即可完成这项工作。请通过 litellm_settings.success_callback (它是 additive,即累加式)注册它,而不是通过 callbacks。 callbacks 列表会 替换 LiteLLM 的内部日志记录器列表,该列表包含内置的支出跟踪日志记录器,并且会静默禁用预算强制执行。
以下是该回调的最小版本,使用 LiteLLM 的 CustomLogger 类:
import boto3
from litellm.integrations.custom_logger import CustomLogger

cloudwatch = boto3.client("cloudwatch")

class TPMEmitter(CustomLogger):
    async def async_log_success_event(self, kwargs, response_obj, start_time, end_time):
        total_tokens = kwargs.get("standard_logging_object", {}).get("total_tokens", 0)
        cloudwatch.put_metric_data(
            Namespace="LiteLLM/Gateway",
            MetricData=[{
                "MetricName": "TokensPerMinute",
                "Value": total_tokens,
                "Unit": "Count",
            }],
        )

# Register alongside success_callback, not in place of it:
import litellm
litellm.callbacks = [TPMEmitter()]
对于提示级别的调试,我们在 CloudWatch 之外还运行 Langfuse。当开发者报告“模型给出了糟糕的响应”时,你可以使用 Langfuse 检查确切的提示、令牌计数和模型参数。对于合规敏感的环境,Amazon Bedrock 原生的到 Amazon Simple Storage Service(Amazon S3)的调用日志记录提供了不可变的审计跟踪。
大规模运行的经验教训
我们在一个全新的 AWS 账户上端到端部署了此模式,以确认示例代码片段可以正常工作。在我们自己的部署中,我们将此 LLM 网关扩展到了数百名开发者,并吸取了一些经验教训。
运维经验教训
大规模运行的主要发现:
- 扩展思考彻底改变了延迟特性。 使用 Claude 扩展思考的请求可能耗时数分钟甚至更长,具体取决于思考预算。如果你的负载均衡器空闲超时为 60 秒,这些请求将静默失败。为解决此问题,你可以将负载均衡器空闲超时设置为至少 900 秒,并相应地配置 LiteLLM 的请求超时(
timeout: 900在本文前面第 2 步的配置中)。 - 当被限流时,先在同一模型上退避重试,然后再启动回退。 我们最初的本能是在被限流时从 Sonnet 回退到 Haiku。但这对于编码助手来说并非最优,因为切换模型会破坏开发者所依赖的一致行为。相反,应在代理层面使用指数退避重试同一模型(
max_retries: 3在第 2 步中)。当请求在重试后仍无法得到服务时,应清楚地暴露错误,而不是返回替代模型的补全结果。 - 将自动化工具调用与开发者流量分开。 持续集成和持续交付(CI/CD)流水线以及自动化代码审查工具应使用它们自己的推理配置文件和配额直接调用 Amazon Bedrock。将自动化流量与交互式开发者流量混合会导致不可预测的延迟,并妨碍有意义的成本归因。
- 如果可行,从第一天起就使用 Global CRIS。 我们最初使用 Geographic(US)CRIS,但在达到区域配额限制后最终迁移了我们的推理配置文件。对于我们的用例,我们没有数据驻留限制,因此可以使用 Global CRIS。Global CRIS 跨区域路由请求,以利用更广泛的容量池,从而简化大规模管理。
部署注意事项
有两个配置错误很常见,而且在支出或连接性出问题之前很难察觉:
配置每模型成本是强制执行预算的必备条件。 如果你想跟踪每用户成本控制,每个模型上的 model_info 块不是可选的。当 model 指向 Amazon Bedrock 推理配置文件 ARN 时,LiteLLM 无法在其内置定价表中查找该 ARN。它会改为记录每令牌 $0,因此 max_budget 和 429 限流强制执行会静默地不触发。无论有多少令牌流过,支出都保持为 $0。通过设置 input_cost_per_token 和 output_cost_per_token (或 input_cost_per_million_tokens).
数据库与缓存对比: 该 database_url 必须是 PostgreSQL。LiteLLM 的虚拟密钥(/key/generate), store_model_in_db, 和支出跟踪都由 Postgres 支持。
一些较小的部署细节完善了我们的检查清单:
- Global CRIS IAM 需要基础模型资源, 而不仅仅是应用推理配置文件 ARN。否则,调用会在运行时被拒绝。
- 为 Fargate 任务分配足够的内存。 LiteLLM 的网关镜像在 512 MB 时会内存耗尽并被杀死(退出码 137),甚至无法通过健康检查。约 2 GB 是安全的下限。
- 覆盖容器
entryPoint. 官方镜像的入口点是litellm。如果你在启动时用 shell 脚本渲染配置,请设置entryPoint: ['/bin/sh','-c'],否则你的脚本会作为参数传递给litellm. - IAM 角色和安全组描述必须是 ASCII。 IAM 和 Amazon EC2 会拒绝长破折号和
->箭头。 - 确认你的账户和区域中的模型可用性。 模型 ID 和 CRIS 配置文件会变化。使用
aws bedrock list-inference-profiles进行验证(例如,我们使用了claude-haiku-4-5,因为claude-haiku-3-5不可用)。
清理
本文通过说明性代码片段而非单一可部署堆栈来介绍该模式,因此没有一键拆除的方法。但该架构依赖多个在运行时持续计费的资源。这些资源包括 AWS Fargate 服务、Amazon RDS(PostgreSQL)、Amazon ElastiCache for Valkey 和 Application Load Balancer,以及配套的 Secrets Manager 密钥、CloudWatch 告警和 Amazon Bedrock 应用推理配置文件。完成测试后,请移除它们以避免持续产生费用。
如果你使用《AWS 上的多提供商生成式 AI 网关指南》部署了完整解决方案,请按照该解决方案的清理说明移除它创建的所有内容。对于 AWS CDK,运行 cdk destroy。对于 AWS CloudFormation,删除堆栈。
如果你根据本文中的代码片段自行构建了该模式,请移除每个资源:
- AWS Fargate 服务和集群:删除 Amazon Elastic Container Service(Amazon ECS)服务以停止并排空任务,然后删除集群。
- Application Load Balancer:删除 ALB 及其监听器和目标组。
- Amazon RDS(PostgreSQL):删除数据库实例。仅当你需要保留 API 密钥和支出数据时,才先创建最终快照。
- Amazon ElastiCache for Valkey:删除复制组或集群。它仅保存缓存数据,因此无需快照。
- Amazon Bedrock 应用程序推理配置文件:删除第 3 步中创建的配置文件,可以通过移除 AWS CDK 构造或运行
aws bedrock delete-inference-profile. - AWS Secrets Manager 密钥:安排删除代理的密钥,例如主密钥和数据库凭证。
- Amazon CloudWatch 告警和日志组:删除 TPM 告警以及任何 LiteLLM 日志组。
在删除其依赖的 Amazon RDS 和 ElastiCache 端点之前,先删除 AWS Fargate 服务和 ALB,以免在拆除过程中运行中的任务因后端已被移除而报错。
结论
在本文中,我们详细介绍了一种 LLM 网关模式,它抽象了 Amazon Bedrock 的多模型架构,为你的团队提供可扩展、可观测的自助式访问。由于 Amazon Bedrock 通过单一接口在多个模型之间路由,且无需更改基础设施,你的开发者可以通过熟悉的 API 即时访问基础模型。成本治理、可观测性和单一控制平面交由你的工程和安全团队负责,而财务部门则能获得按用户归因,无需你自行构建定制的计量基础设施。
首先,请通读本文中的模式和代码片段,以了解各部分如何协同工作。AWS CDK 代码片段涵盖 Amazon Bedrock 应用程序推理配置文件、其 IAM 策略以及 CloudWatch 告警。周边的 AWS Fargate 服务、Amazon RDS、Amazon ElastiCache、ALB 和 AWS Secrets Manager 资源遵循标准 AWS CDK 模式,未在文中展示。
当你准备好完整的、可部署的实现时, AWS 上的多提供商生成式 AI 网关指南 与该模式高度契合。你可以在 AWS Solutions Library 中找到该指南以及配套的 博客文章 以及 GitHub 项目。虽然本文逐步介绍了相同的核心模式,但它侧重于面向开发者编码助手的 Amazon Bedrock。更大的解决方案架构增加了多提供商支持、Amazon ECS 或 Amazon Elastic Kubernetes Service(Amazon EKS)、Amazon CloudFront 和 AWS WAF 选项,以及一个管理界面。
通过以下附加文档探索此架构的各个组件: Amazon Bedrock 推理配置文件, LiteLLM 网关, AWS Fargate,以及 Langfuse.
在你的组织中尝试这一模式。先从一个试点团队开始,验证成本控制措施,然后再逐步扩展。