
- Facebook 特征框架(F3) 是 Meta 用于编写、编译和提供广告排序模型所依赖的机器学习特征的框架,其中单次请求可能需要超过 20,000 个特征。我们首次在 AI @ Scale 2020.
- F3 通过将所有特征编译成单一合并图,降低了执行计算成本,但该图同时也是发布单元,因此单个失败或无效定义就会阻塞整个发布流水线。
- 本文介绍 F3 Lightning,这是一个构建在 F3 之上的基础设施层,通过将特征发布与共享执行解耦来解决这一挑战,使每个特征都能独立编译、验证、部署和回滚。
- 最难解决的部分是保留 F3 的效率提升。早期的按特征发布原型增加了 CPU 使用率,因为独立特征不再共享计算。我们旨在通过四项优化来弥合这一差距:稳定的计算标识符、单一共享执行计划、跨所有特征共享的单一内存缓冲区,以及用于直接数组访问的稠密索引映射。
- 借助 F3 Lightning,同类提取特征现在投入生产的速度 约快 3.6 倍 比之前的 F3 更快,且基础设施计算成本没有增加。更短的发布周期也使得在同一时期内能够进行更多的模型迭代。
F3 共享执行架构入门
生产环境的机器学习系统很少直接使用原始数据。在模型能够做出预测之前,其特征服务系统可能需要读取已存储的信号、将事件过滤到某个时间窗口、对值进行计数或求和、对其进行归一化,并合并中间结果。
完成这项工作的最简单设计是将每个特征视为一个独立的函数。这很容易理解,但在规模化时会变得浪费,因为特征在计算上并非相互独立。一个七天点击计数和一个七天曝光计数可能读取相同的事件源并应用相同的时间窗口过滤器。一个点击率特征随后可能复用这两个结果。单独运行每个特征会在每个请求上重复该过滤器以及所有其他共享步骤。
F3 采用了不同的方法,将特征提取表示为有向无环图(DAG)。每个节点执行一个工作单元,例如读取输入、应用过滤器或计算聚合。一条边意味着一个计算依赖于另一个计算的结果。图的输出是模型所消费的特征值。
工程师使用高级语言独立编写每个特征。F3 编译器将每个定义转换为一个小图,然后将服务所使用的每个特征的图合并为一个合并图(图 1)。当特征共享某个操作时,例如上面的七天过滤器,编译器会将重复项折叠为单个节点。这样,共享的工作随后在每个请求中只运行一次,而不是为每个需要它的特征各运行一次。在运行时,特征提取就是对这个合并图的遍历。
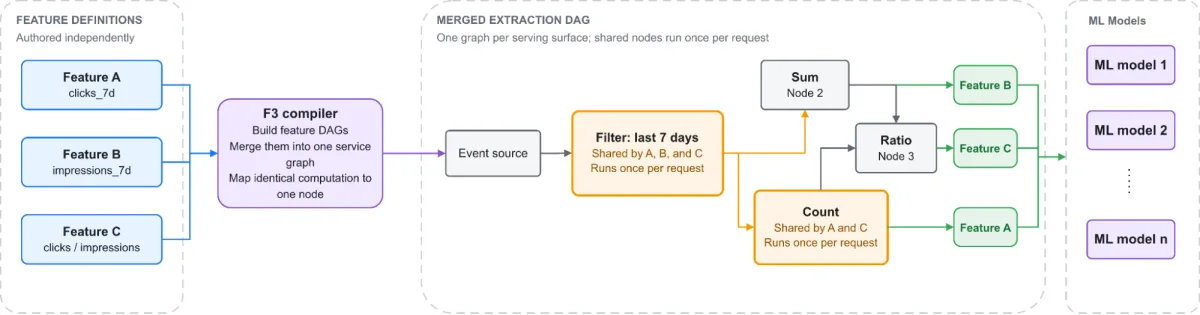
共享图让每次发布都变成全有或全无
F3 的合并图高效地共享了计算,但它也带来了一个重大隐患:这张图同时也是发布单元,一个格式错误的定义就可能拖住合并图中所有其他特性的发布。
图 2 展示了这一挑战。图中显示了七个独立编写的特性 A 到 G,其中五个定义有效,但 D 和 G 包含互不相关的错误。“尝试 1”的构建在 D 上失败,因此这七个特性一个都无法发布。在 D 被修正后,“尝试 2”的构建进行到 G 并再次失败。只有在“尝试 3”中两个定义都被修复后,完整的合并图才成功进入生产环境。
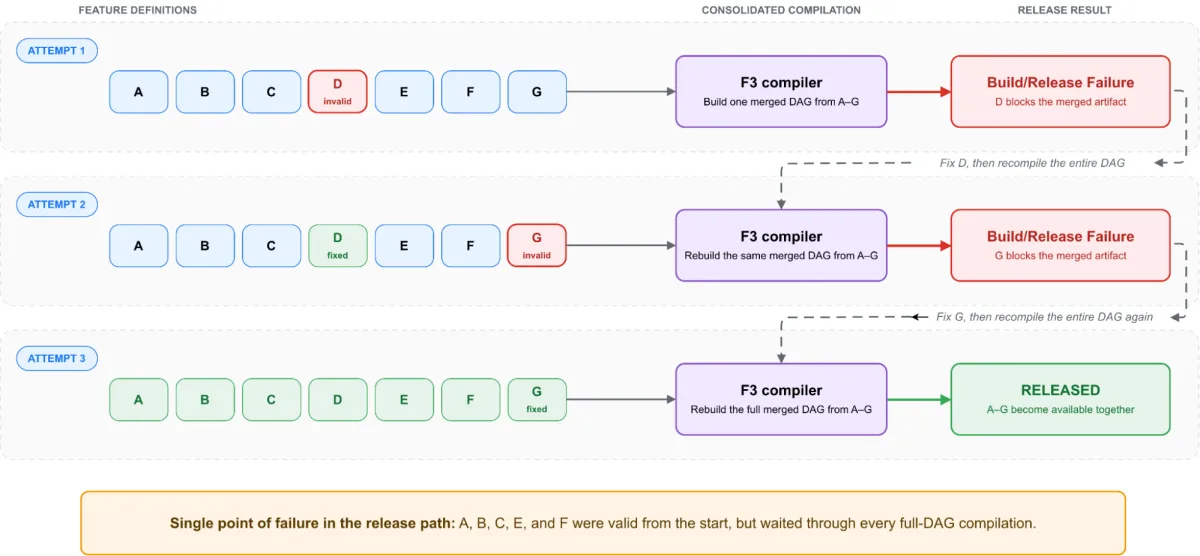
随着 F3 规模扩大,失败变得更加频繁。F3 最初只服务几百个特性,在那个规模下合并能够成功,发布也基本顺利。如今这个数字已超过 20,000,而且不同类型的特性需要根据其计算方式进行各自的检查,因此新特性和修改过的特性要满足不同的测试标准。一个已被模型使用的特性在发布前需要经过与模型相关的测试。这些测试的计算成本足够高,因此只在较晚的发布阶段运行,而且由于合并图作为一个整体发布,其中的其他所有特性也都要等待它们。
F3 Lightning:让每个特性独立发布并共享计算
F3 上线后,我们对合并图进行了多轮改进。每一轮都暂时恢复了发布速度,但随着更多特性落地,这些收益逐渐被侵蚀,因为所有特性仍然在合并图中一起发布。因此,我们构建了 F3 Lightning,让每个特性都能独立发布,同时保留 F3 的效率。
如图 3 所示,F3 Lightning 引入了两项变更来帮助实现这一目标:
- 部署粒度: 每个特性都是一个可独立发布的配置。它经过验证、发布和回滚,都不会影响任何其他特性。
- 效率持平: F3 的效率来自合并图,因此让每个特性各自发布就消除了这一效率来源。要在保持按特性发布的同时达到同样的效率,需要在 F3 Lightning 的执行方式上做几项关键优化。
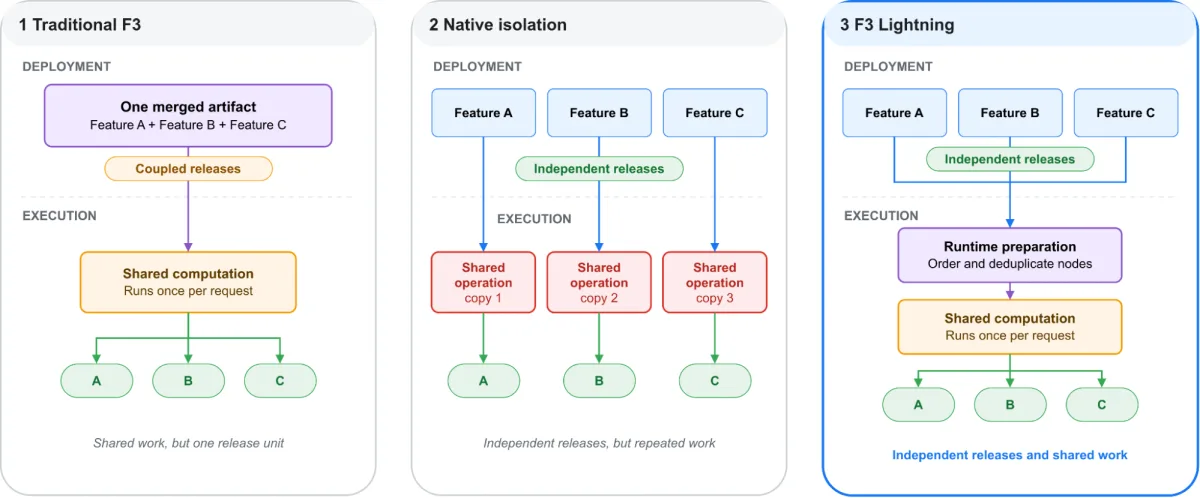
部署粒度:F3 Lightning 如何隔离特性发布
隔离从编译器开始,每个特性都被单独编译成一个配置。该特性配置携带提取该特性所需的一切——它需要的每个节点,按顺序排列,不向相邻特性借用任何东西。如果特性 C 出了问题,特性 A 仍然可以发布,因为这两个配置彼此没有任何关系。
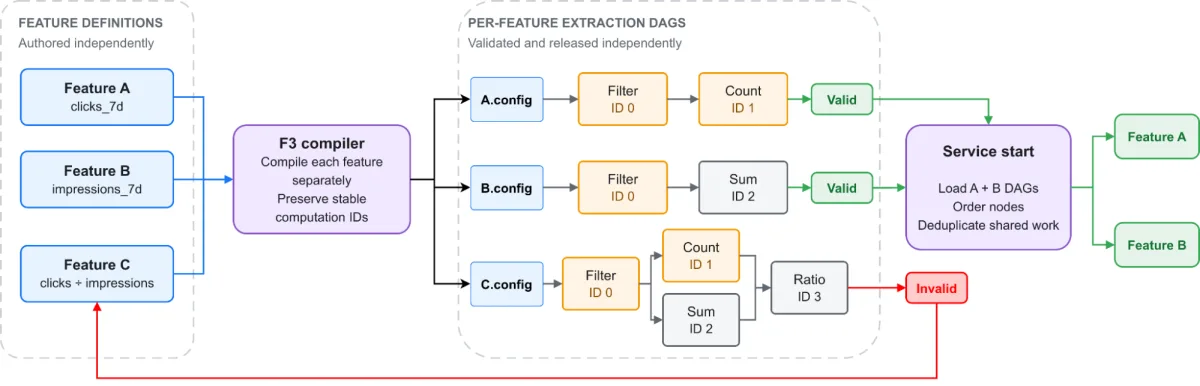
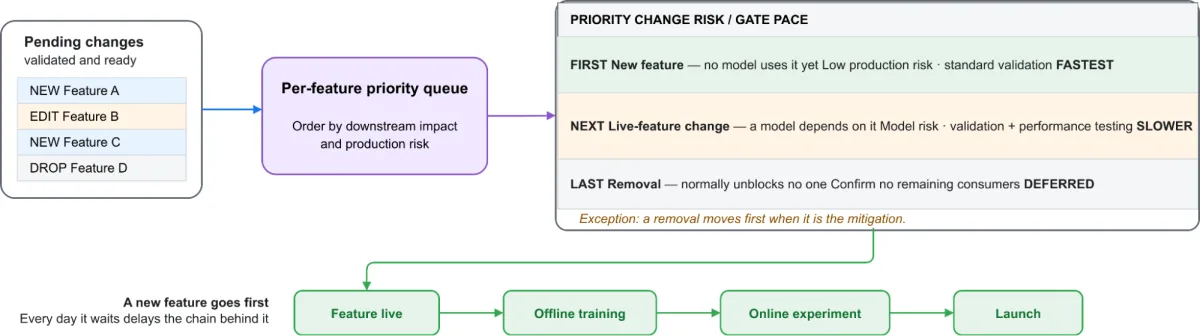
由于特性在发布时不再合并,每个特性都可以按自己的时间表被选中并发布。发布路径变成了一条有序队列,而不是一次性全部发布或全部不发布的批次。变更按它们能解除的阻塞来排定优先级。一个尚无模型使用的新特性可以通过标准验证快速发布,而对一个已有线上模型读取的特性的变更则会先接受额外测试。
效率持平:F3 Lightning 如何保持 F3 的服务效率
我们最初的几个原型只分离了部署。特性独立发布,但执行不再共享,因此这些原型使用的 CPU 明显多于传统 F3。每个独立发布的配置都以各自的图到达服务进程并单独执行,重复了 F3 合并图已经消除的每一次读取、过滤和聚合。
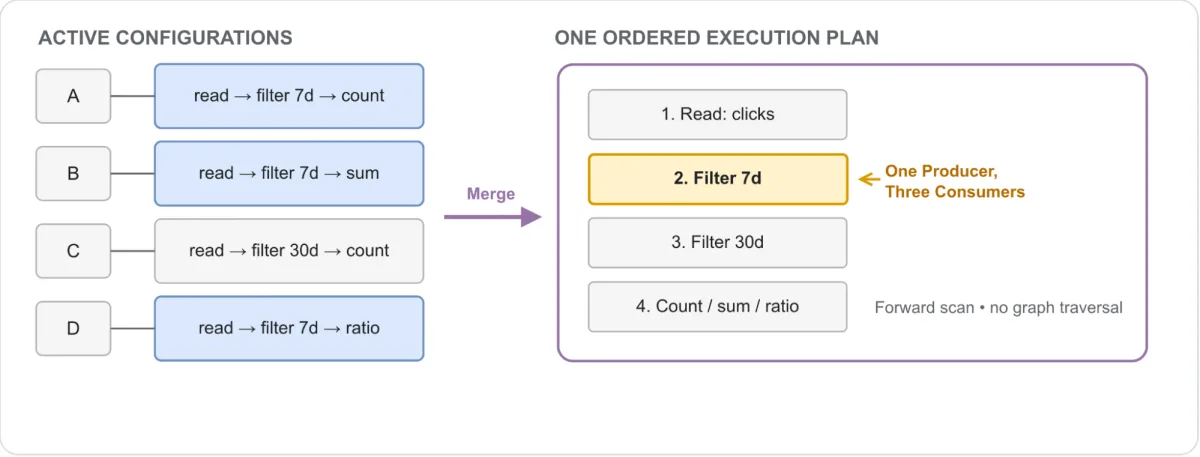
解决办法是在不恢复合并的前提下恢复共享执行。启动时,F3 Lightning 不会重建合并图。它获取活跃的特性配置,合并它们共享的工作,并将其编排为单一执行顺序。恢复到持平水平用了四步:一个编译器前置条件,随后是三项启动优化。
第1步:稳定标识符让共享工作可被识别
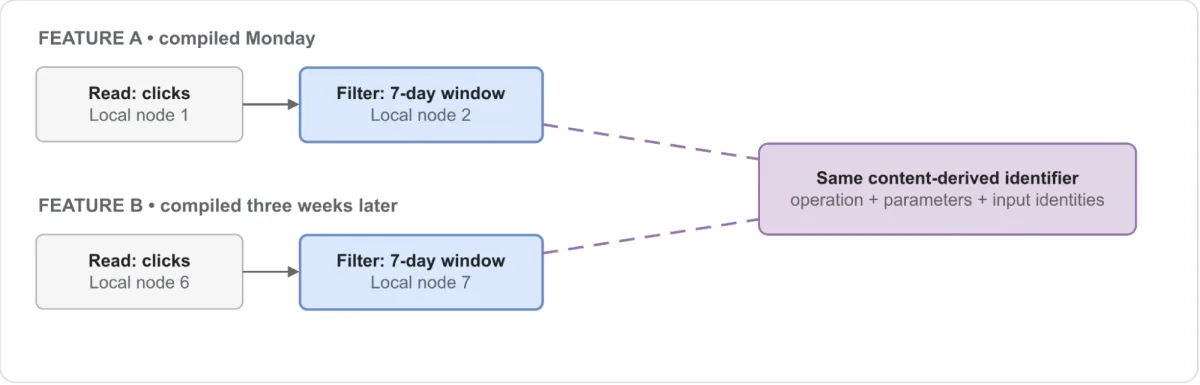
要消除重复执行,运行时必须识别出两个独立编译的配置何时包含相同的计算。节点编号无法做到这一点,因为编号是每个特性图内部的局部编号。同一个七天过滤器在一个配置中可能是节点2,在另一个配置中可能是节点7,而插入一个节点就会重新编号其后的所有节点。传统 F3 从未遇到这个问题,因为一次编译器运行能看到所有特性,并可以全局分配标识符。
F3 Lightning 则让编译器根据工作做什么、而不是它位于何处来推导每个标识符:操作、其参数,以及其输入的标识符(见图6)。由于每个输入的标识符已经反映了它上游的一切,该标识符捕获了产生该结果的整条工作链。在输入顺序不影响结果的地方,输入会被置于标准顺序。聚合还会包含定义其行为的属性,例如时间窗口和分组键。因此,两个在相同输入上定义相同操作的特性会获得相同的标识符,即使它们是在相隔数周的情况下编译和发布的。如果某个计算的含义发生变化,其标识符也会随之改变。
第2步:为所有特性构建单一执行计划
在服务启动时,F3 Lightning 会为所有活跃特性构建一个单一执行计划,使用拓扑排序将每个节点排在其所依赖的节点之后。当多个特性包含具有相同标识符的节点时,该计划只保留一份副本,并将所有使用方连接到它,因此无论有多少特性使用该计算,它都只运行一次。
合并保证了每个计算只运行一次,但该计划仍然是一个图,执行器在每次请求时都要沿着指针逐节点遍历。因此,同一次启动过程会将其展平为一个有序列表,这样每次请求只需沿着列表进行一次前向遍历,而无需遍历图。
共享一个计划会带来风险:单个计算失败可能影响所有特性。为防止这种情况,如果某个计算失败或其输入不可用,F3 Lightning 会将其下游的所有内容标记为未就绪,执行器会跳过这些工作。失败只影响依赖它的节点,独立分支会继续运行。
第3步:共享内存缓冲区,因为去重还不够
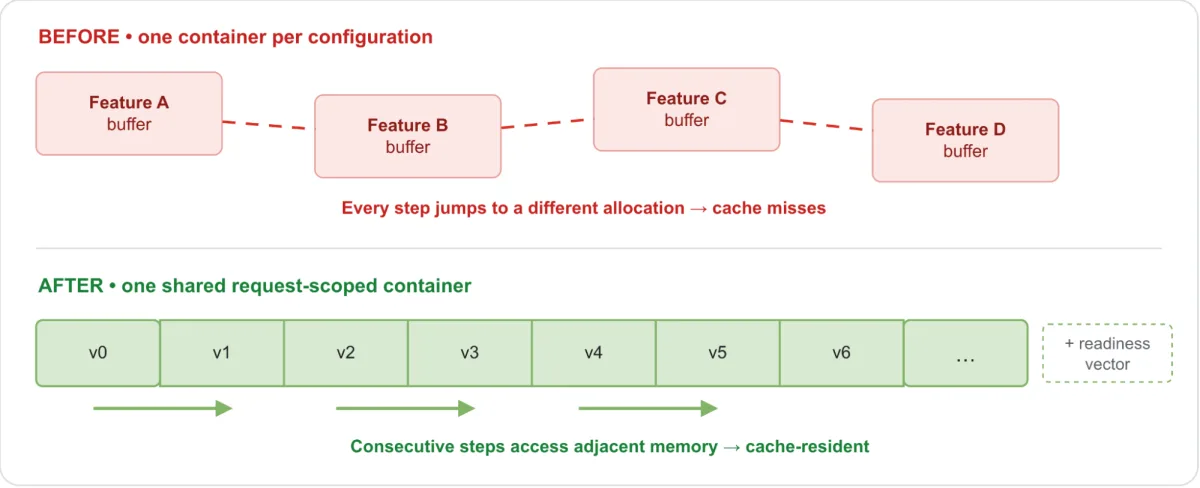
在第1步和第2步完成后,没有任何计算运行两次,但 CPU 使用率仍高于传统 F3。剩余的计算成本来自内存布局。每个配置都带有自己的请求时数据容器,因此中间结果分散在各自独立的内存分配中。按顺序遍历计划意味着要在它们之间跳转,而每次跳转都会造成一次缓存未命中。
F3 Lightning 用每次请求一个缓冲区取代了这些按特性划分的容器。在启动时,每个特性的引用都会被重新绑定到该缓冲区中的槽位。
单一缓冲区带来了三项改进:
局部性: 连续的计划步骤现在会访问相邻内存,因此某一步读取的值通常已经在缓存中。这恢复了合并图一直具有的顺序访问模式。它还消除了每次请求时按特性进行的分配。
单一就绪向量: 一个与值分开存储的单一向量取代了按特性跟踪,因此执行器无需读取值本身即可检查某个值是否就绪。该标记必须单独存在,因为空列表是有效结果,所以“空”不能同时表示“尚未计算”。
无重复副本: 大多数特性值是列表和映射,使用方不再获得自己的副本。共享槽位持有对生产者结果的引用,因此被20个特性使用的计算只计算一次、只存储一次。单值(标量)仍会被复制,因为复制一个小值比跟随指针更便宜。这是安全的,因为每个缓冲区只在一个请求期间存在,且执行顺序保证每个结果的生命周期长于其最后一个读取者。
第4步:稠密索引映射消除最后一项按访问产生的成本
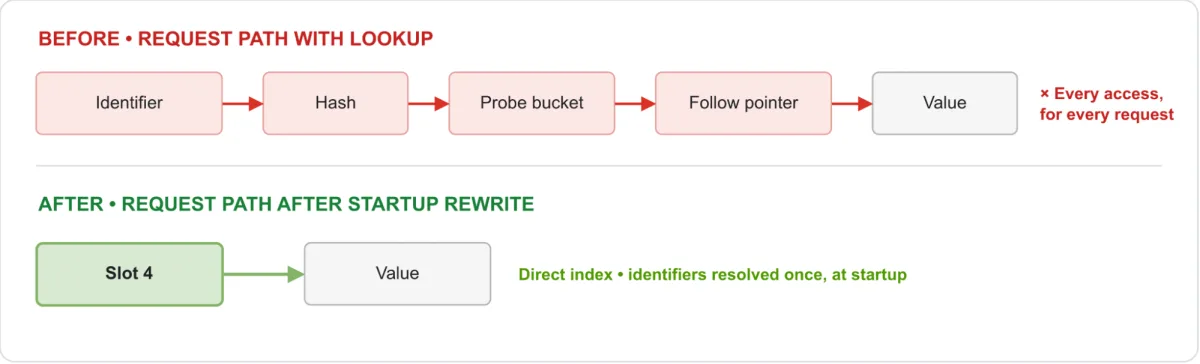
现在这些值被放在一起,但找到某个值在计算上仍然代价高昂。每次访问都必须解析一个标识符,这意味着要对键做哈希、探查桶并跟随指针。在 Meta 的服务规模下,查找在计算上并不高效。
最终的修复方案应用了与第 2 步和第 3 步相同的原则:在启动时一次性完成这些工作。F3 Lightning 为每个唯一标识符分配一个连续的整数槽位,并重写每个配置中的每一处引用,使其指向这些槽位,因此标识符只在初始化期间使用。读取结果就变成了对共享缓冲区的直接数组索引,请求路径上不再有哈希,也不再有查找表。
借助 F3 Lightning,同类抽取特征现在进入生产环境的速度比传统 F3 快约 3.6 倍,且基础设施计算成本没有增加。更短的发布周期意味着模型可以在同一时期内更频繁地改进和重新训练。构建 F3 Lightning 还让我们学到了三条经验:
部署与执行应当有各自的边界: 如果同一个产物既决定组件如何运行,又决定它们何时发布,那么其中任何一个环节出故障都会阻塞所有其他环节。将这两项工作拆分后,效率与发布速度之间的取舍就被消除了。
在请求之间永不改变的工作应当放在启动阶段,而不是请求路径上: 有三项任务对每个请求都是相同的:找出共享工作、决定运行它的顺序,以及找到每个结果的存储位置。F3 Lightning 现在在服务启动时一次性完成这些工作,因此独立发布不会给单个请求增加计算成本。
两种设计可以按相同顺序执行相同的操作,但在 CPU 计算成本上仍可能差异很大: 在 F3 Lightning 中,我们移除了所有重复计算,但 CPU 使用率仍高于传统 F3。每个特征仍然保留着自己的一份共享结果副本,分散在内存各处。将每个结果合并为单一副本后,这一差距得以消除。这是该项目中最不显而易见的结果,也是最具普适性的一个。在现代 CPU 上,结果存放在哪里以及存在多少份副本,可能与运行多少次计算同样重要。
致谢
我们要感谢 Sourabh Bansal、Ping Chen、Weitao Chen、Benjamin Dummitt、Junhua Gu、Henry Hu、Jing Huo、Joffrey Liu、Rocky Liu、Weixi Ma、Shuby Mao、Sandeep Pandey、Mihir Rastogi、Tim Sombuntham、Matt Steiner、Vivienne Sung、Ritwik Tewari、Vivek Trehan、Arnaud Venet、Daniel Wang、Ziheng Wang、Gautam Wilkins、Fan Yang、Qiao Yang、Jie Zheng,以及整个团队,他们参与了 F3(Meta 的广告机器学习特征计算与服务平台)和 F3 Lightning(构建于其上的能力)的开发与生产化。