人工智能
在 Amazon Bedrock 上为 Kimi K3 推出印度境内推理Kimi K3 是一款多模态开放权重基础模型(FM),提供商 Moonshot AI 称其在发布时已达到前沿水平的编码与通用智能体能力。
除全球推理和 US-based 推理之外, Amazon Bedrock 现为 Kimi K3 支持印度境内推理:为具有严格数据驻留要求的本地工作负载解除限制。像 Ultrahuman 这样的客户已在生产环境中看到收益:
“Ultrahuman 应用中的 AI 健康与养生助手 Jade 使用每个人自己的 Ring 和血糖数据,以通俗语言回答问题,每天处理超过 14,000 次对话。Amazon Bedrock 上的 Kimi K3 让我们通过已在使用的 API 添加了一个领先的开放权重模型,健康数据保留在 AWS 内部,并以孟买作为回退区域。借助提示缓存,我们将 LLM 成本降低了 80%,并使多轮聊天速度提升了 85%。”
— Aditya Patawari,Ultrahuman 工程副总裁
在本文中,我们介绍可用的不同全球和地理推理选项,并分享一个示例用例的代码:对印度语言文档进行光学字符识别(OCR)和理解,并以代码混合的 Hinglish 进行后续问答。
选择推理运行的位置
Amazon Bedrock 上的 Kimi K3 通过 跨区域推理配置文件提供。你可以从众多 AWS 区域(“源”)中的任意一个调用该模型。随后,Amazon Bedrock 会在多个可能的“目标”区域之一安全地处理你的请求。
跨区域推理完全由 AWS 托管:数据在区域之间传输时加密,并始终留在 AWS 网络上,绝不会经过公共互联网,也无需你设置任何多区域虚拟私有云(VPC)基础设施。
你调用的推理配置文件 ID 决定了哪些目标区域符合条件:
| 配置文件 | 模型 ID | 何时选择它 |
| 全球 | global.moonshotai.kimi-k3 |
推荐用于大多数用例:成本最低且可用范围最广 |
| 印度地理 | in.moonshotai.kimi-k3 |
推理处理必须留在孟买和海得拉巴区域 |
请参阅 Amazon Bedrock 的 Kimi K3 模型卡 以获取有关可用推理配置文件、可从哪些 AWS 区域调用它们以及它们可使用哪些目标区域进行推理的最新信息。
示例演练:印度语言文档理解
让我们考虑一个示例用例:读取一份扫描的印地语文档,提取结构化数据,并以印地语和英语混合(Hinglish)的方式回答后续问题。
这一需求在印度金融服务和公共部门工作流中很常见,这些场景往往需要将了解你的客户(KYC)表格、水电费账单及类似文件数字化。Amazon Bedrock 上的 Kimi K3 可以直接读取并推理图像,包括包含多语言文本的图像。它提供了一种无需单独的 OCR 或翻译服务的潜在解决方案。
前提条件
本示例的完整源代码可在 GitHub 上获取。 在 GitHub 上.
要跟着操作,你需要:
- 一个 AWS 账户.
- Python 3.11 或更高版本,并具备互联网访问权限以安装所需的 所需的 PyPI 包。.
- 以下 IAM 策略授予足够的访问权限。请将占位符替换为你的 AWS 账户 ID:有关权限的更多信息,请参阅在 Amazon B 中运行模型推理的前提条件。 AWS 命令行界面(AWS CLI) 已安装,并具备 凭证 配置了足够的 AWS Identity and Access Management (IAM) 权限 通过印度推理配置文件调用 Kimi K3 模型。
例如,要通过印度地理推理在孟买区域使用 Kimi K3,以下 IAM 策略授予足够的访问权限。请将占位符替换为你的 AWS 账户 ID: ap-south-1 孟买区域进行印度地理推理,以下 IAM 策略授予足够的访问权限。请将 {ACCOUNT_ID} 请将占位符替换为你的 AWS 账户 ID:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "BedrockCallWithBearerToken",
      "Effect": "Allow",
      "Action": ["bedrock:CallWithBearerToken"],
      "Resource": ["*"]
    },
    {
      "Sid": "BedrockKimiK3India",
      "Effect": "Allow",
      "Action": [
        "bedrock:InvokeModel",
        "bedrock:InvokeModelWithResponseStream"
      ],
      "Resource": [
        "arn:aws:bedrock:ap-south-1::foundation-model/moonshotai.kimi-k3",
        "arn:aws:bedrock:ap-south-2::foundation-model/moonshotai.kimi-k3",
        "arn:aws:bedrock:ap-south-1:{ACCOUNT_ID}:inference-profile/in.moonshotai.kimi-k3",
        "arn:aws:bedrock:ap-south-1:{ACCOUNT_ID}:project/default"
      ]
    }
  ]
}
有关权限的更多信息,请参阅 运行模型推理的前提条件 在《Amazon Bedrock 用户指南》中。如果你的组织限制 AWS 区域,请让你的管理员查看 地理跨区域推理的 IAM 与 SCP 指南保留允许的源区域,并允许路由到两个印度目的地,在适当情况下使用配置文件范围的例外。 Responses API 指南 还说明了所需的默认项目访问权限。
开始使用推理 API
如 模型卡,Amazon Bedrock 支持多种调用 Kimi K3 的 API,全部通过 Bedrock Runtime 端点提供:
| API | 请求与响应格式 |
| Chat Completions | OpenAI 兼容的消息输入与助手消息输出。 |
| Responses | OpenAI 兼容的输入与结构化输出项。 |
| Converse | 跨受支持模型的标准化消息、内容块和推理参数。 |
| InvokeModel | 模型专属的 JSON 请求与响应体。 |
由于此模型推荐使用 OpenAI 兼容 API,因此在本示例中我们使用这些 API,并通过 openai Python 库.
Amazon Bedrock 支持 生成 API 密钥 对于需要它们的集成。不过,AWS 建议尽可能改用 短期凭证 在可能的情况下。 AWS 令牌生成器 Python 库 会从标准 AWS CLI 凭证链中派生出一个类似短期 API 密钥的令牌。
如果你使用一个 命名配置文件 ,你可能需要先设置 AWS_PROFILE 环境变量。设置好 CLI 凭证后,你可以使用以下代码调用该模型:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

region = "ap-south-1"
model_id = "in.moonshotai.kimi-k3"

client = OpenAI(
    base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1",
    api_key=provide_token(region=region),
)

response = client.chat.completions.create(
    model=model_id,
    messages=[{
        "role": "user",
        "content": "Classify this ticket as billing, technical, or account: I was charged twice."
    }],
    max_completion_tokens=2048,
)

print(response.choices[0].message.content)
这里, region (ap-south-1 (孟买)指定了发起请求的源区域。推理配置文件 in.moonshotai.kimi-k3 确保推理仅在印度区域进行处理。
Chat Completions 和 Responses API 均支持流式传输、工具调用和结构化输出等多种功能。请参阅 OpenAI Python API 参考 以获取更多示例。
分析图像
Amazon Bedrock 上的 Kimi K3 支持图像以及 PDF 和其他多种文件类型。你可以通过 base64 编码直接将输入文件发送给模型。对于 OCR 或其他细节很重要的用例,可以考虑将图像 detail 参数设置为 high这提高了准确性,代价是每张图像消耗更多输入 token。
在某些情况下,我们发现当提供图像时,Kimi K3 的输出质量更高。 文本输入。我们建议尝试不同的请求顺序。请参考以下示例代码:为进行演示,我们生成了一张合成的印地语电费账单图片。图 1:示例中的合成印地语电费账单(所有示例文档均为虚构)给定此图像输入,模型可以直接从文档中提取数据来回答问题,无需单独的数字化步骤。例如:问:账单多少钱,最后期限是什么时候?如果逾期,需要付多少 文本输入。我们建议尝试不同的请求顺序。请参考以下示例代码:
from base64 import b64encode

image_path = "sample_data/electricity_bill_hi.png"
with open(image_path, "rb") as f:
    image_base64 = b64encode(f.read()).decode("ascii")

response = client.chat.completions.create(
    model=model_id,
    messages=[
        {
            "role": "user",
            "content": [
                # The model card recommends placing images before text:
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{image_base64}",
                        "detail": "high"
                    }
                },
                {"type": "text", "text": QUESTION_PROMPT},
            ]
        },
    ],
    max_completion_tokens=16384,
)

print(response.choices[0].message.content)
为进行演示,我们生成了一张合成的印地语电费账单图片。
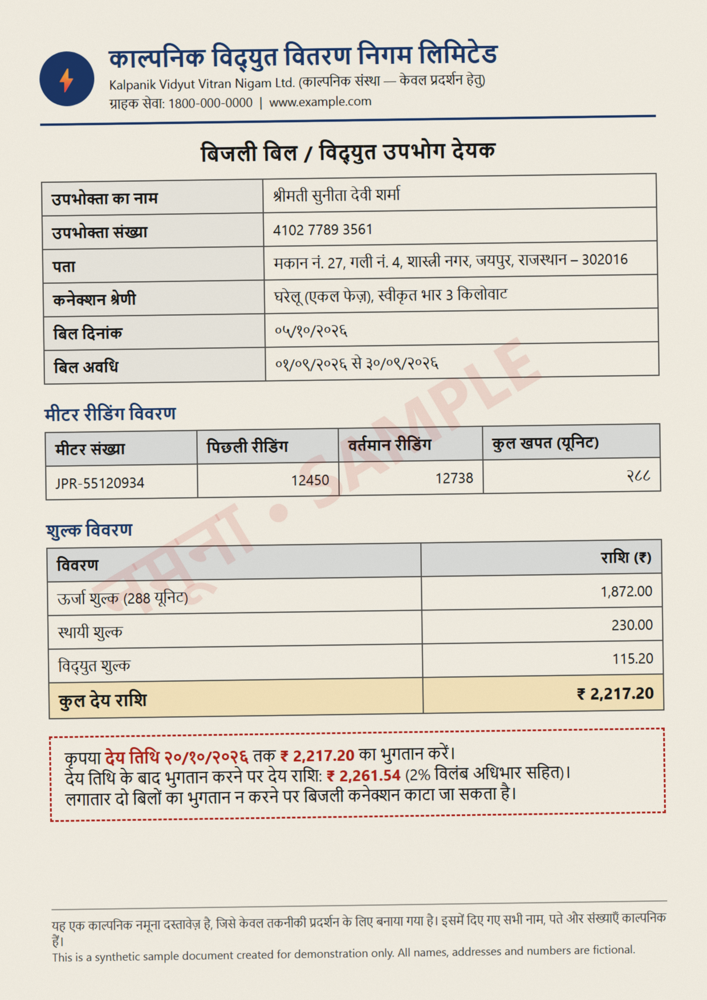
图 1:示例中的合成印地语电费账单(所有示例文档均为虚构)
给定此图像输入,模型可以直接从文档中提取数据来回答问题,无需单独的数字化步骤。例如:
问:账单多少钱,最后期限是什么时候?如果逾期,需要付多少?
答:账单总额是 ₹2,217.20,最后期限是 20/10/2026。如果逾期,则需支付 ₹2,261.54。
构建结构化提取流水线
除了通用问答之外,你还可以使用静态提示词创建结构化文档处理工作流,从大量文档中提取一组一致的预期字段。
为了对输出结构施加严格约束(而非尽力而为的提示词引导生成),Kimi K3 在 Amazon Bedrock 上支持结构化输出,既可通过函数调用实现,也可通过提供 JSON Schema 输出格式实现。这些选项在以下文档中有更详细的说明: OpenAI 文档 (适用于 OpenAI 兼容 API)以及 Amazon Bedrock 用户指南 (适用于原生 Converse/InvokeModel API)。
在完整的示例代码中 仓库,我们提供了一条端到端流水线,它可以:
- 以原始文字(OCR)转写文档。
- 使用可配置的 schema 将关键字段提取为 JSON,并将日期规范化为 ISO 8601(
YYYY-MM-DD),将天城文数字(例如 २८८)转换为西方数字(288),并将姓名音译为英文。 - 撰写一段简短的英文摘要。
- 针对同一文档,用 Hinglish(以拉丁字母书写的印地语,混有英语)回答多轮追问。
对于上一张图中的同一张合成印地语电费账单,该流水线会返回如下所示的结构化字段(已缩写):
{
  "consumer_name": "श्रीमती सुनीता देवी शर्मा",
  "consumer_name_english": "Smt. Sunita Devi Sharma",
  "consumer_number": "410277893561",
  "billing_period": "2026-09-01 to 2026-09-30",
  "due_date": "2026-10-20",
  "units_consumed_kwh": 288,
  "amount_due_inr": 2217.20,
  "amount_after_due_date_inr": 2261.54
}
我们还提供了一个 KYC 表单示例和一个开放式 模式,在该模式下,模型会自行选择最有用的字段,以适用于任何其他文档类型。所有提供的示例文档均为合成文档,其中的姓名和地址均为虚构,身份号码已做掩码处理。请从 GitHub 下载示例代码,以进一步探索并在你自己的图像上试用。与任何自动化提取一样,在依赖输出结果做出重要决策之前,你应验证这些输出对你的特定用例是否可靠。考虑添加后验证逻辑或人工审核步骤 模式,在该模式下,模型会自行选择最有用的字段,以适用于任何其他文档类型。所有提供的示例文档均为合成文档,其中的姓名和地址均为虚构,身份号码已做掩码处理。
从 GitHub 下载 示例代码,以进一步探索并在你自己的图像上试用。 以进一步探索并在你自己的图像上试用。
与任何自动化提取一样,在依赖输出结果做出重要决策之前,你应验证这些输出对你的特定用例是否可靠。考虑为关键工作流添加后验证逻辑或人工审核步骤。
优化性价比、服务层级和缓存
针对示例文档调整你的系统提示词和 schema,以实现可靠的提取。 Amazon Bedrock 高级提示词优化 (AdvPO)提供了一种完全托管的选项,可基于参考示例优化提示词模板。
Amazon Bedrock 服务层级 让你能够按每个请求控制性价比。对于延迟不太敏感的用例,你可以选择 层级,以享受默认标准定价 50% 的折扣。 层级 享受默认标准定价 50% 的折扣。对于延迟敏感型场景,你可以选择“priority”层级,以更高价格请求更高的队列优先级。详情请参阅 定价页面 。
输入提示词中包含较长且很少变化内容的用例,也可以从 提示词缓存 在 Amazon Bedrock 上。请确保静态内容(系统提示词、工具描述等)出现在输入的开头, 对于延迟不太敏感的用例,你可以选择 flex 层级,以享受默认标准定价 50% 的折扣。对于延迟敏感型场景,你可以选择“priority”层级,以更高价格请求更高的队列优先级。详情请参阅定价页面。输入提示词中包含较长且很少变化内容的用例,也可以从 Amazon Bedrock 上的提示词缓存中受益。请确保静态内容(系统提示词、工具描述等)出现在输入的开头, 动态部分,例如当前图像和问题。
Amazon Bedrock 上的 Kimi K3 既支持缓存命中的折扣定价,也支持显式缓存模式。在默认的 隐式缓存模式下,服务会尝试自动缓存并复用请求之间重复的提示词前缀,无需用户执行任何操作。不过,你可以通过选择显式模式并在输入中为可缓存内容指定“断点”来提升性能,从而提高缓存命中率、加快响应速度并节省成本。
以下示例展示了使用 Responses API 进行显式提示词缓存的方法。更多信息请参阅 提示词缓存 《Amazon Bedrock 用户指南》:
for call in (1, 2):
    response = client.responses.create(
        model=model_id, max_output_tokens=2048, store=False,
        input=[
            {"type": "message", "role": "system", "content": [{
                "type": "input_text", "text": static_prefix,
                "prompt_cache_breakpoint": {"mode": "explicit"},
            }]},
            {"type": "message", "role": "user", "content": [{
                "type": "input_text", "text": dynamic_prompt,
            }]},
        ],
        extra_body={"prompt_cache_options": {"mode": "explicit"}},
    )
    print(call, response.usage.input_tokens_details.cached_tokens)
监控使用情况
Amazon CloudWatch 指标 在“ AWS/Bedrock 命名空间下自动生成,可查看调用速率、token 数量、缓存使用情况、延迟、错误和限流情况。
模型调用日志记录 该功能为可选启用,启用后可选择包含提示词和输出。启用前请检查访问权限、保留策略和存储位置设置。
无论跨区域推理可能由哪个目标区域处理,日志和指标都存储在您提交请求的源区域。您可以选择性地 启用 AWS CloudTrail 数据事件日志记录 以在 CloudTrail 中记录模型调用,CloudTrail 会将请求的目标区域记录为一个 additionalEventData.inferenceRegion 字段。
清理
Kimi K3 按 token 计费,因此这些代码示例不会预置任何需要清理的持久性 AWS 资源。如果你为探索创建了新的 IAM 角色或用户,或者为现有用户/角色添加了额外权限,请记得在完成后将其删除。
结论与后续步骤
在本文中,我们探讨了 Amazon Bedrock 上的 Kimi K3 如何按需提供能够理解混合印度语言和英语的智能能力。它现在通过以下方式支持在印度(AWS 孟买和海得拉巴区域)进行完全境内数据处理: in.moonshotai.kimi-k3 推理配置文件.
立即在 Amazon Bedrock 控制台或通过推理 API 试用。 Amazon Bedrock 控制台 或通过推理 API 试用。查看 模型卡 了解更多信息,并访问 AWS re:Post 寻找答案或向社区咨询有关 Amazon Bedrock 的问题。