了解我们共享的 pgvector 表如何让我们最小的客户变得最慢,为什么 HNSW 索引让情况更糟,以及迁移到 turbopuffer 如何让搜索变得更快、更便宜。
和许多其他 AI 产品一样,Modem 使用嵌入向量。当新的客户消息进来时,我们想知道是否有任何客户之前在任何渠道、以任何措辞说过类似的话。嵌入向量是我们回答这个问题的方式之一。
刚开始时,我们希望管理的组件越少越好。因此,这些嵌入向量就存放在 Postgres 中,配合 pgvector 扩展使用。在很长一段时间里,这都没问题。
后来,我们的搜索开始以一种莫名其妙的方式变慢。一些最小的客户要等上十秒才能拿到结果,而我们最大的客户(要扫描的数据最多)却能立刻得到答案。与此同时,我们的数据库计算成本一路飙升。
在这篇文章中,我将解释是什么拖慢了我们的速度,为什么标准的解决方案对我们这样的产品不起作用,以及我们最终如何认输并切换到 turbopuffer——它把我们的 p90 搜索时间缩短了 76%,并卸下了我们数据库上的大部分负载。
为什么我们从 Postgres 起步
Modem 会读取你的团队和用户交流的场所(支持工单、问题跟踪器、通话记录、Slack),并将发现的内容归类为话题。每当它从对话中提取出一个新的客户关注点,就会向数据库提问:最近是否有任何客户说过类似的话?
为了回答这个问题,我们使用嵌入向量。嵌入向量是一长串数字,称为向量,由模型根据一段输入文本生成。含义相似的字符串会得到指向相似方向的向量。
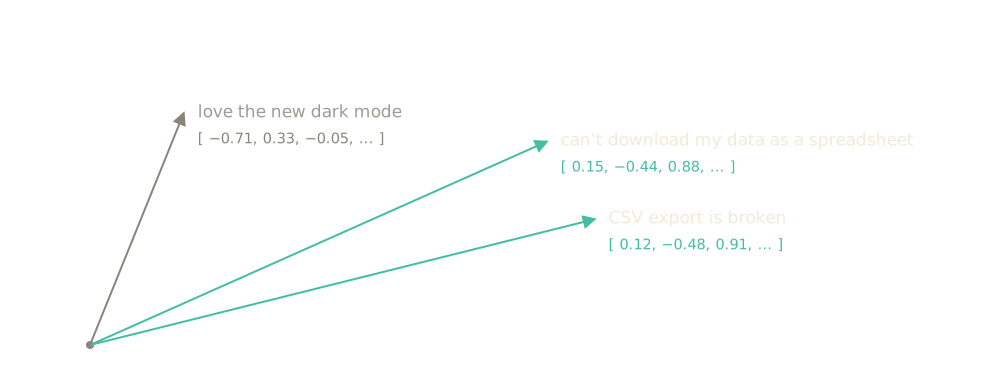
刚开始时,我们的数据非常少,也没有费心为嵌入向量建立索引。因此,为了执行这个查询,Postgres 会查看该客户的近期行,并将每一行与新嵌入向量逐一比较。
这种暴力方法奏效的时间远超预期。我们的数据库提供商 Neon 慷慨地赠送了免费计算额度,这让我们得以超额配置而不是优化,于是我们就这么做了。而且,由于这些向量搜索作为数据摄取的一部分在多个后台任务中运行,慢查询对用户来说大多难以察觉。
但随着我们增加更多客户并摄取更多数据,嵌入向量的数量开始迅速增长。到 2026 年 8 月,搜索耗时中位数约为 0.8 秒 ,而最慢的 1% 耗时长达 28 秒。我们的 Neon 计算资源不断扩容以跟上节奏,而其中相当大一部分竟然就来自这一个查询。最终,我们的免费额度用完了,数据库账单到期了,我们很快意识到自己正坐在一个什么样的问题上。
数据库里慢查询的标准修复方法是加索引。但在测试中,这个索引不仅没有提升性能,反而让性能显著变差。
HNSW 索引如何工作
标准的向量索引在 pgvector 中是 HNSW,它代表 分层可导航小世界。许多向量数据库都支持它,向量搜索正是靠它才变快。
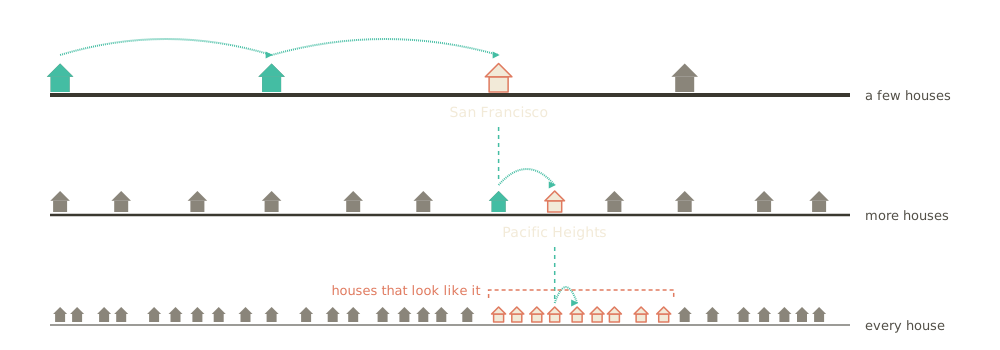
HNSW 不会将你的查询与每一行逐一比较,而是构建一个图,其中每个向量都链接到其最近的邻居,并按从稀疏到完整的层次堆叠。搜索从顶层开始,朝最接近的方向跳转,下降一层,然后重复。你只需查看几百行而不是整张表,答案是近似的,但通常非常好。
让我举个例子。假设给你一张房子的图片,并要求你找出一组看起来像它的房子。你会先从世界各地散布的几栋房子开始,然后走向那栋看起来最像你图片的房子。
假设第一个命中的是旧金山的一栋房子。接着,你会查看旧金山周边更多、彼此更靠近的房子,并走向其中最像的那一栋,这可能会把你带到像太平洋高地这样的街区。最后,你会在那里的街道上走一走,直到周围都是看起来像你图片的房子。HNSW 寻找相似向量的方式大致就是如此。
意外:HNSW 反而可能让性能变差
如果 HNSW 能自行回答你的查询,那它很棒。但我们的查询还有两个额外的过滤条件:
- 该
organization_id数据属于 - 一个时间范围(用于保证时效性)
通常,Postgres 会为你合并索引。你有一个用于 organization_id,一个用于 timestamp,然后规划器从每个索引中取出匹配的行,保留同时属于两者的行,然后继续处理。这一切都会自动发生,你无需操心。
SELECT ... FROM semantic_groups
WHERE organization_id = $org_id        -- Organization filter
  AND timestamp > now() - $time_window -- Time range
ORDER BY embedding <=> $candidate
LIMIT $count;
但 HNSW 并不是这样工作的。普通索引回答的是“哪些行匹配?”HNSW 回答的是“哪些行最接近?”而“最接近”适用于向量空间中的所有内容,忽略任何其他过滤条件。换句话说,Postgres 会先在整个表上遍历图,然后再应用你的普通列过滤条件。 匹配?"HNSW 回答的是"哪些行最 最接近而“最接近”适用于向量空间中的所有内容,忽略任何其他过滤条件。换句话说,Postgres 会先在整个表上遍历图,然后再应用你的普通列过滤条件。 之后.
在众多客户共享的多租户表上,这简直是一场灾难。向量查询会从整张表中返回固定数量的候选匹配项,然后由 organization_id 而时间过滤器会剔除所有不属于目标组织或时间范围的内容。这通常意味着,一开始看起来很有希望的候选结果最终会被缩减为空集。
回到找房子的例子。假设你仍然想找出看起来像输入图片的房子,但你现在有了一个新条件:你只想考虑在售的房子。你像之前一样进行搜索:旧金山、太平洋高地、一条满是看起来像你图片的房子所在的街道。只有到那时,你才去查看标识。那些房子没有一栋在售,所以你空手而归,尽管沿街往下几栋就有在售的。
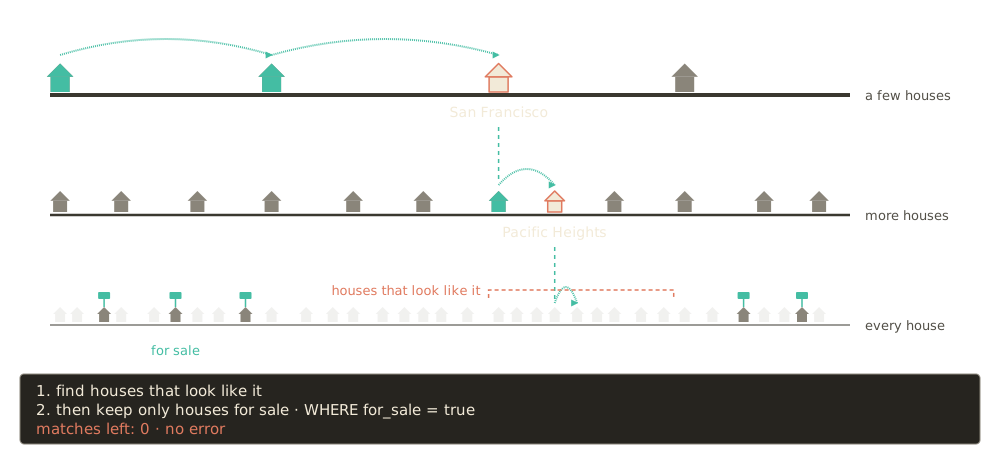
这是一个已知问题, pgvector以至于它还有一个设置, hnsw.iterative_scan,这会不断拓宽遍历范围,直到有足够多的行通过过滤条件。
我们在几千次真实生产搜索中,将其与暴力扫描进行了对比测试。
- 对于群组数少于 500 的客户,中位耗时慢了 89 倍,为 9.1 秒,而此前为 103 毫秒。
- 约7%的结果发生了变化,其中包括数十条此前已被用户确认存在关联的匹配记录。
- 最慢的一次搜索耗时178秒。
- 索引几乎 翻倍 了表的存储占用。
客户规模越小,遍历图时需要走过的范围就越大,才能找到属于它的那些行。而由于我们是提供免费套餐的自助式产品,大多数客户规模都很小。
于是我们撤掉了索引,重新回到暴力扫描。但最初的问题依然存在:它一开始为什么会这么慢?
为什么向量会让缓存变得困难
随着我们不断深入挖掘,我们有了一个奇怪的发现。
一个整天给我们发反馈的大客户,其中位检索时间约为1秒。而一个定期向我们发送数据的小得多的客户,其中位时间却超过10秒。这感觉完全反了,因为在数据库领域,更常见的情况是大账户(需要扫描的数据更多)对应更慢的查询。
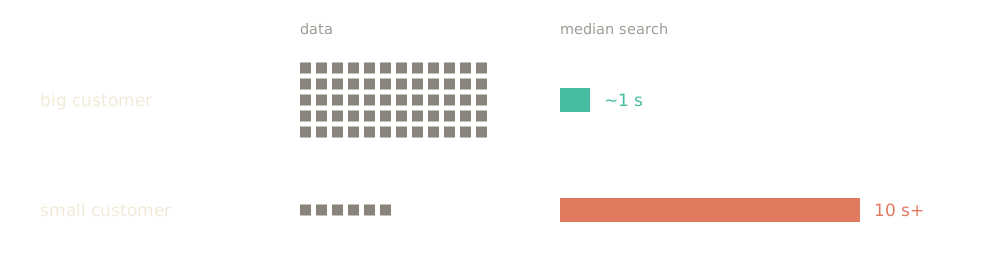
那么,到底是怎么回事?
忙碌的客户和安静的客户运行的是完全相同的查询。区别只在于查询运行时,他们的数据恰好位于何处。
Postgres 会将最近使用的数据保留在内存中,而所有客户共享这份内存。我们的嵌入向量足够大,以至于一次只有一小部分能放进内存。忙碌的客户搜索得足够频繁,因此其数据行能一直留在内存中。安静的客户回来时,发现自己的数据行已被其他人挤了出去,于是每次搜索都要访问磁盘。
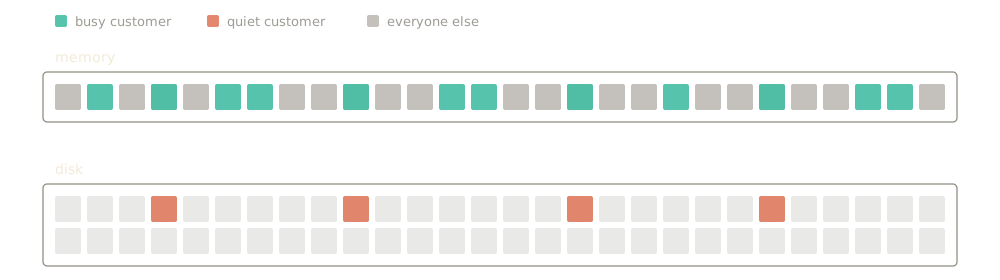
扫描本身没有问题。它总是给出正确的答案。问题在于每一行数据的读取成本都很高,而且现在大多数行都来自磁盘。
最后一次尝试让 pgvector 奏效
到这时,我们已经开始怀疑 pgvector 能跟上 Modem 的增长。我们只是想争取一些时间,然后再需要更换基础设施。
如果 HNSW 行不通,而问题又在于我们的嵌入向量太大、无法常驻内存,那我们能不能换一种思路,用小得多的量化嵌入向量来构建一个替代索引?
我们的论点是:一个足够小的向量索引可以完全驻留在内存中,磁盘上什么都不留。于是我们尽可能把它做到最小: 二值量化.
pgvector 有一个函数可以做到这一点, binary_quantize()它通过只保留其 1,536 个数字各自的正负号来缩小嵌入向量。这用一个比特(1 或 0)来表示。
embedding  [ 0.021, -0.013,  0.008, -0.044,  0.017,  0.030, -0.002, ... ] // N = 1,536
quantized  [     1,      0,      1,      0,      1,      1,      0, ... ] // N = 1,536
这将 3 KB 缩减为 192 字节,而比较其中两个只需一次快速的位计数,而不是 1,536 次乘法。这显然会损失大量精度。但是,由于嵌入向量占用的空间小得多,而且比较速度如此之快,你可以多取一些数据,并比较规模大得多的候选集。
最后再回到房子的例子。这就像快速翻过一叠微小而模糊的照片, 每一 房子,先挑出一批看起来大致合适的,然后开车过去看看这些匹配是否真的合适。
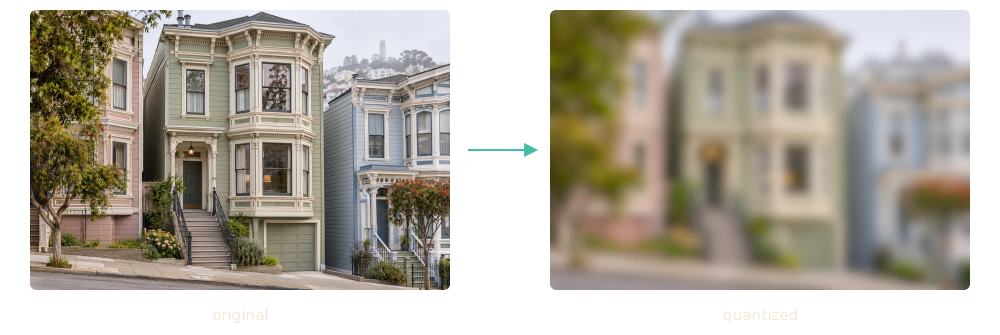
我们把这些量化嵌入向量保存在它们自己的小表中,它完全能放进内存,而且还有富余空间。而且因为这只是普通的 Postgres 表,我们可以为诸如 organization_id 以及 timestamp 因此,查询规划器会像你预期的那样生成高效的查询。
因此每次搜索都长这样:
- 将查询与客户最近的每一个量化嵌入向量进行比较,并保留最接近的 N 个候选,其中 N 大约是你最终想要得到的实际目标数量的 50 倍。
- 在完整精度嵌入向量上运行我们最初的精确查询,但只针对那份候选名单。
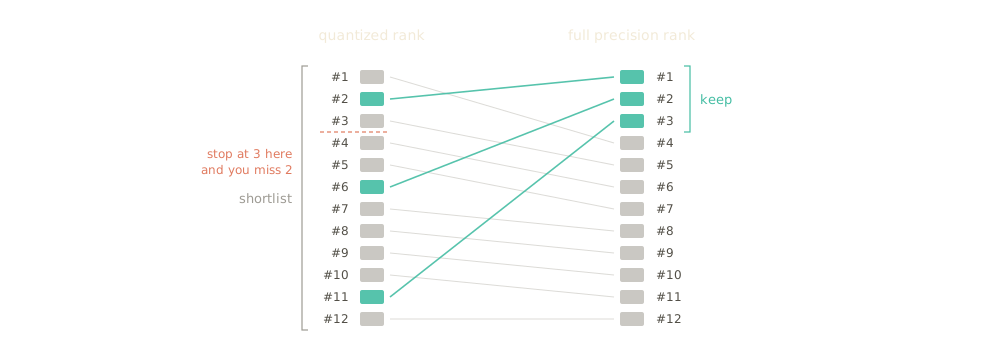
成功了。一个回放测试框架用两种方式运行了数千次真实生产搜索,量化索引返回的结果与暴力扫描相同。它还削减了尾部延迟。在一周的生产流量中,p90 从 7.6 秒降至 3.5 秒,p99 从 28.1 秒降至 6.3 秒。中位数则朝相反方向变化,从 0.81 秒升至 1.16 秒,但造成麻烦的正是那些慢速搜索。
这是一次真正的胜利。搜索变快了,结果却没有变化。但更大的 halfvec 嵌入向量仍然存放在 Postgres 中,每次搜索仍然必须访问它们。为了让那张表保持足够快的速度,我们不得不持续支付远超应用其余部分所需的计算和内存费用。换句话说:查询时间降下来了,但我们的 Neon 账单没有。
迁移到 turbopuffer
这时我们不再试图让 pgvector 它发生。
是时候去做我们内心一直知道必须做的事了:切换到专用的向量数据库解决方案。我们选择了 turbopuffer.
turbopuffer 是一款专有的搜索数据库,由两位前 Shopify 工程师于 2023 年创建,以付费 SaaS 服务的形式提供。它同时支持向量搜索和全文搜索,并将所有数据保存在 S3 之类的对象存储上,同时在前端用内存和 SSD 缓存当前正在被搜索的数据。这样一来,长期保留大量向量成本很低,而搜索正在使用的向量又很快。
turbopuffer 同时解决了我们问题的两个方面。它在数据该在的地方处理过滤条件——在搜索内部,而不是在搜索之后。它还把嵌入向量从 Postgres 中移出,放进一个围绕“大多数向量在大多数时候都是冷数据”这一理念构建的系统里。
每个客户都有自己的命名空间,因此他们的向量存放在各自的索引中。所以从一开始,我们只查看该客户的搜索空间。这还带来了额外的好处:账户之间的数据隔离更好。
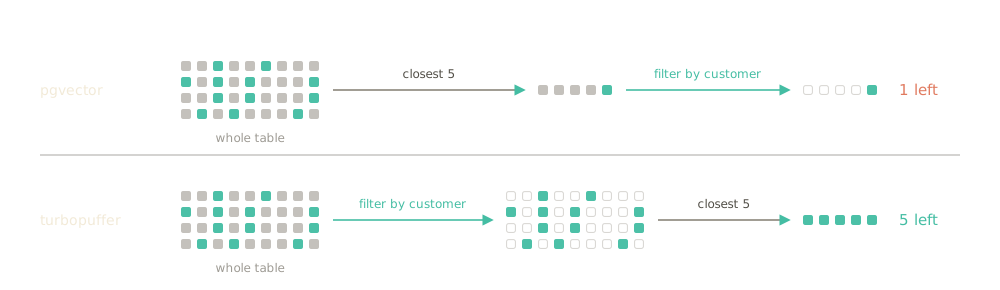
我们为每个向量存储一个时间戳,因此 turbopuffer 只搜索时间窗口内的那些向量。 pgvector的 HNSW 索引做不到这一点。它会先找到最近的若干行,然后再检查它们的日期,而迭代扫描会持续查找,直到有足够多的行通过筛选。我们的量化表把日期处理对了,但为了做到这一点,它不得不与窗口内的每一行进行比较。
这次切换本身并不大,因为我们已经花了一个月时间研究量化索引。我们的搜索本来就分两步进行:先构建候选列表,再对它进行精确排序。而且我们有回放测试工具来判断候选列表是否可靠。我们唯一改变的是候选列表的来源。
我们把每个向量都写入了两个系统,并以影子模式运行了每一个客户。Postgres 仍然负责真实响应,turbopuffer 则同时运行相同的搜索,以便我们对比每一个结果。88% 的结果完全一致。另有 11% 存在细微差异,例如两个几乎相等的匹配以不同的顺序返回。
最后 1% 主要来自拥有单一超大主题的客户。关于同一件事的数百条消息会占满搜索结果,把其他内容都挤出去。向 turbopuffer 请求每个主题只返回一个结果后,这个问题就解决了,剩下的 0.43% 是同样好的匹配之间的并列。
在确认可靠之后,我们把所有人都切换了过去。以下是三种方案下每条新反馈的搜索耗时,每种方案都基于约一周的生产流量进行测量。
| 百分位 | 每条新反馈的搜索耗时,每种方案均基于约一周的生产流量测量 |
|---|---|
| 暴力搜索█░░░░░░░░░░░░░░░░░░░░░░░░░░░0.81 秒量化█░░░░░░░░░░░░░░░░░░░░░░░░░░░1.16 秒turbopuffer█░░░░░░░░░░░░░░░░░░░░░░░░░░░0.86 秒p90暴力搜索████████░░░░░░░░░░░░░░░░░░░░7.6 秒量化███░░░░░░░░░░░░░░░░░░░░░░░░░3.5 秒turbopuffer██░░░░░░░░░░░░░░░░░░░░░░░░░░1.8 秒p99暴力搜索████████████████████████████28.1 秒量化██████░░░░░░░░░░░░░░░░░░░░░░6.3 秒turbopuffer████░░░░░░░░░░░░░░░░░░░░░░░░4.1 秒中位数几乎没有变化,因为大多数搜索从来就不是问题所在。变化发生在尾部。 | 暴力搜索█░░░░░░░░░░░░░░░░░░░░░░░░░░░0.81 秒量化█░░░░░░░░░░░░░░░░░░░░░░░░░░░1.16 秒turbopuffer█░░░░░░░░░░░░░░░░░░░░░░░░░░░0.86 秒 |
| 与暴力扫描相比,p90 下降了 76%,p99 下降了 85%:最慢的 10% 搜索大约快了四倍,而最慢的 1% | 暴力搜索████████░░░░░░░░░░░░░░░░░░░░7.6 秒量化███░░░░░░░░░░░░░░░░░░░░░░░░░3.5 秒turbopuffer██░░░░░░░░░░░░░░░░░░░░░░░░░░1.8 秒 |
| 暴力搜索████████████████████████████28.1 秒量化██████░░░░░░░░░░░░░░░░░░░░░░6.3 秒turbopuffer████░░░░░░░░░░░░░░░░░░░░░░░░4.1 秒中位数几乎没有变化,因为大多数搜索从来就不是问题所在。变化发生在尾部。与暴力扫描相比,p90 下降了 76%,p99 下降了 85%:最慢的 10% 搜索大约快了四倍,而最慢的 1% 几乎快了七倍。关于这些数字的说明:它们是我们流水线所看到的完整往返时间,包含网络在内,而不是 t | 暴力搜索████████████████████████████28.1 秒量化██████░░░░░░░░░░░░░░░░░░░░░░6.3 秒turbopuffer████░░░░░░░░░░░░░░░░░░░░░░░░4.1 秒 |
中位数几乎没有变化,因为大多数搜索从来就不是问题所在。变化发生在尾部。与暴力扫描相比,p90 下降了 76%,p99 下降了 85%:最慢的 10% 搜索大约快了四倍,而最慢的 1% 几乎快了七倍。
关于这些数字的说明:它们是我们流水线所看到的完整往返时间,包含网络在内,而不是数据库在查询上花费的时间。而且我们有些搜索会要求 turbopuffer 返回精确结果,这意味着要与该客户最近的每一行进行比对,因此客户的数据越多,这些搜索耗时就越长。对于后台任务,我们宁愿准确,也不追求速度。
以下是切换当周逐小时的情况。
━━Postgres,量化索引━━turbopuffer▒▒影子模式:两套系统执行每一次搜索4秒8秒12秒正式上线10月17日10月18日10月19日10月20日10月21日10月22日10月23日需要注意的是,此时 Postgres 已经比我们最初测量量化索引时更慢了。表已经变大,而且我们为一个新功能又增加了第二次搜索,这次搜索仍以暴力扫描方式运行,并争用同一份内存。这说明了为什么我们需要一个更好的长期方案;围绕一种查询模式写一个临时修补方案,并不能顾及我们后续会引入的新查询。
除了查询速度更快之外,Postgres 还找回了它的内存。在最初的 24 小时内,我们生产数据库的 CPU 下降了 62%,缓存未命中下降了 82%,该表上的慢查询下降了 95%。Postgres 中的其他一切也都变快了,因为这个开销高昂的向量查询不再占用全部内存。我们得以缩减 Neon DB 实例的规格,并降低了数据库账单。
尽管我们现在也要为 turbopuffer 付费,但切换到这套双系统后,我们整体的存储账单——涵盖所有 Modem 数据,而不只是嵌入向量——下降了大约 10%。
100%90%turbopufferPostgres切换前切换后我们会给另一个团队关于 pgvector 的建议
这一切都不在计划之中。我们最初想要一个数据库,并尽可能减少需要维护的组件,结果却变成了两个。
我们仍然会从 Postgres 开始。一个数据库要运维的东西更少,而且在小表上做暴力扫描,能撑的时间比你想象的要长。但回过头看,有三件事本可以让我们更早走到这一步。
要查清是谁慢,而不只是慢多少。 我们的中位数看起来没问题。只有当我们按客户拆分搜索时间时,才发现那些小而安静的客户等待时间是别人的十倍。如果你最慢的搜索属于你最小的客户,先检查内存,再检查查询。
在信任一个索引之前,先用真实搜索对它进行测试。 带过滤条件的 HNSW 可能返回不同的结果,或者返回更少的结果,而且不会报任何错误。我们之所以能发现这个问题,只是因为我们拿它跑了真实的生产搜索并对比了答案。先为此搭一个测试框架。我们搭的那个框架比本文提到的所有方案都更经久耐用。
算一算这些向量让数据库其余部分付出了多少代价。 量化索引确实让我们的搜索变得足够快。但它无法阻止嵌入向量把其他所有东西挤出内存,而我们正为此在计算上付出代价。
真正解决问题的是把嵌入向量移到不会与其余数据争抢内存的地方。
结果发现,多一个数据库反而比多一个过滤器更简单。