←搜索结果

按匹配度 · 共 1166 条结果 清除搜索

星期二

  1. MarkTechPost精选

    OpenAI 发布 GPT-6.1 Terra,API 价格为 GPT-6.1 Sol 的一半

    OpenAI 发布 GPT-6.1 Terra,替代 GPT-5.6 Terra,API 定价为每百万输入 token 1 美元、输出 5 美元,是 GPT-6.1 Sol 的一半。该模型支持 1.05M token 上下文和 128K 最大输出,面向视觉推理、电脑操作与写作,仅通过 OpenAI 托管的 API、ChatGPT Work 和 Codex 提供。在 Agents' Last Exam v1 上最高努力档得分 60.0%、每任务 1.01 美元,MMMU-Pro 视觉得分 85.5%,但 Terminal-Bench 4.0 仅 50.3%,落后于 GPT-6.1 Sol 和 Claude Sonnet 5.5。

    26 年 6 月 1 日。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 推理努力程度从 none 到 max,默认值为 medium。工具调用需要 Responses API。支持的工具包括电脑操作、托管 shell、代码解释器、网络搜索、文件搜索和 MCP。OpenAI 列出的用例包括将产品照片与目录条目匹配,以及解读技术图纸。 GPT-6.1 Terra 在电脑操作方面表现如何? OpenAI 主要的权威测试是 Agents' Last Exam v1,这是一组专业电脑任务。其中一项任务是将建筑图纸转换为 3D 模型。 在 medium 努力档下,Terra 得分为 57.6%,每任务成本 0.29 美元。GPT-5.6 Terra 在相同设置下得分为 42.6%,成本为 0.84 美元。GPT-6 Astra 在 medium 档下同样得分为 57.6%,但每任务成本为 4.82 美元。 在 max 努力档下,Terra 达到 60.0%,每任务成本 1.

    匹配字段正文

  2. Databricks Blog

    Databricks Lakeflow Connect 为生产力工具与 AI 数据提供原生连接器

    Databricks 的 Lakeflow Connect 提供 Atlassian(Jira、Confluence)、Microsoft SharePoint、Google Workspace(Drive、Outlook、Gmail)、GitHub 以及 OpenAI、Anthropic 等来源的原生全托管连接器,数据直接落入 Unity Catalog。非结构化文件、页面和邮件以受治理表形式落地,无需自建或维护数据管道,可用于企业知识库、AI 智能体和开发者效率看板。Toyota Finance Australia 用其 Jira 连接器实现零维护管道,VaxCare 用 Confluence 连接器为聊天机器人提供知识库支撑。

    Screenshot of Jira connector from Lakeflow Connect

    司,运营着美国最大的初级保健疫苗接种网络,它使用 Lakeflow Connect 的 Confluence 连接器将其内部知识库输入 Databricks,并以此为基础构建 AI 智能体。 “Lakeflow Connect 的 Confluence 连接器为我们提供了一种无缝方式,将内部知识库输入 Databricks,使这些数据如今可供我们的聊天机器人搜索和操作——并为我们未来构建 AI 解决方案做好准备。” ——Yasaman Malone,VaxCare 优化与 AI 副总裁 非结构化内容,开箱即用为 AI 做好准备 AI 智能体可以从公司的集体知识中提供即时、有依据的答案,员工无需在 wiki、云盘和收件箱之间四处搜寻。但智能体的能力取决于其背后的数据,而其中大部分是非结构化数据。借助 Lakeflow Connect,这不成问题;我们的连接器可以将文件、页面和消息等非结构化内容作为受治理的表落入 Unity Catalog。具体的数据及其到达格式因数据源而异: SharePoint: SharePoint 连接器会引入非结构化文件本身(PDF、Word 文档、幻灯片和图像

    匹配字段正文

  3. 凤凰科技精选

    OpenAI 发布 GPT-6.1 Terra:强化电脑操作能力,API 价格降一半

    OpenAI 推出新模型 GPT-6.1 Terra,重点提升视觉理解与电脑操作能力,标准 API 价格较 GPT-5.6 Terra 和 GPT-6.1 Sol 均降低 50%。在 Agents' Last Exam 中等推理强度下,其得分比 GPT-5.6 Terra 高 15 个百分点,成本约为后者三分之一;Terminal-Bench 4.0 最高推理强度下完成 50.3% 任务。该模型即日起面向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise 及 Edu 用户开放,API 模型名为 gpt-6.1-terra,输入每百万 token 1 美元、输出每百万 token 5 美元。

    4.0中,GPT-6.1 Terra在最高推理强度下完成了 50.3% 的任务,超过GPT-5.6 Terra已公布成绩21.5%的两倍。 不过,OpenAI表示,对于最复杂的编程任务,GPT-6.1 Sol和GPT-6 Astra仍是更好的选择。 安全方面,OpenAI称,GPT-6.1 Terra在其安全准备框架下达到了网络安全领域的“关键”能力阈值,并保留了为GPT-6 Astra开发的防护措施。公司的测试还显示,新模型较GPT-5.6 Terra更可能遵守任务范围,向用户如实说明自身局限和可能遇到的障碍。 价格与使用范围 GPT-6.1 Terra即日起面向ChatGPT Work和Codex中的Plus、Pro、Enterprise及Edu用户开放。开发者也可以通过OpenAI API调用该模型,模型名称为gpt-6.1-terra。 标准API价格为每100万个输入token 1美元、每100万个缓存输入token 0.05美元,每100万个输出token 5美元。(作者/于雷) 更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。

    匹配字段正文

  4. Databricks Blog

    Databricks AI Search 新增支持 Streaming Tables、Materialized…

    Databricks AI Search 在 Delta 表之外新增原生支持 Streaming Tables、Materialized Views 和基于 Iceberg v3+ 的 Managed 表,用户无需再建中间 Delta 表和同步管道。三类数据源分别对应实时事件、持续维护的个性化状态和跨引擎开放格式数据,UI 与 API 沿用同一套建索引流程。

    I Search 现已原生支持 Streaming Tables、Materialized Views 以及使用 Iceberg v3+ 的 Managed 表 ,此外还支持 Delta 表。你可以将实时事件、持续维护的个性化状态和开放格式数据直接引入 AI Search 应用——从而减少构建和管理单独管道以转换和同步这些数据源的开销。 三种表格式,更广阔的搜索应用世界 Streaming Tables、Materialized Views 和 Managed Iceberg 各自代表一种不同的数据处理方式,并且各自为 AI 应用开辟了新的可能性。 数据源最适合用于它能实现什么 Delta 表(现有)数据与分析工作负载广泛的分析和 AI 应用 Streaming Tables持续到达的事件欺诈检测、安全监控和实时 IoT 分析 Materialized Views自定义的聚合和连接数据个性化、会话感知搜索、坐席辅助 使用 Iceberg 的 Managed 表跨引擎的开放格式数据跨引擎智能体、统一知识搜索、开放格式数据智能 Streaming Tables:驱动实时智能 持续变化的数据

    匹配字段正文

  5. Databricks Blog

    如何用 Databricks Free Edition 开展数据与 AI 教学

    Databricks Free Edition 是永久免费版平台,学生和教师可免费注册、全程在浏览器中使用 Apache Spark、Delta Lake、MLflow、Lakebase、Genie 和 Databricks Apps 等生产级工具,无需云合同、许可证或安装。作业可通过现有 LMS 或 GitHub 分发,大数据集可经云存储、Open Sharing 或 Marketplace 共享。该版本面向学习与非商业用途,按公平使用限制提供较小算力,不适用于生产或商业场景。

    OLTP)工作负载,并将应用数据存储在标准 Postgres 上Get Started with Lakebase 机器学习;毕业设计项目中的模型部署MLflow、Model Serving、GPU跟踪实验;训练、注册和部署模型Get Started with MLFlow 人工智能、自然语言处理、应用 AIGenie Agents、智能体框架与评估、AI 搜索、模型训练与微调构建和评估 AI 智能体,使用向量搜索实现 RAG,并基于自有数据微调模型AI 智能体基础 毕业设计项目、软件工程项目、学生作品与黑客松Databricks Apps构建并部署交互式数据与 AI 应用使用 Databricks Apps 构建企业级应用 在这些功能中,平台的智能体式编码与数据助手 Genie Code 帮助学生生成、解释和调试代码,并自主承担多步骤任务,体现了工作方式日益演变的趋势。 教师常见问题 我如何分发作业? 通过现有的 LMS 或 GitHub 仓库分发。将作业笔记本导出为 .ipynb 文件,并连同任何数据集或说明一起分享;学生将副本导入其 Free Edition 工作区,完成后导出完

    匹配字段正文

  6. OpenAI:部署安全与系统卡

    OpenAI 发布 GPT-6.1 Terra 系统卡补充说明

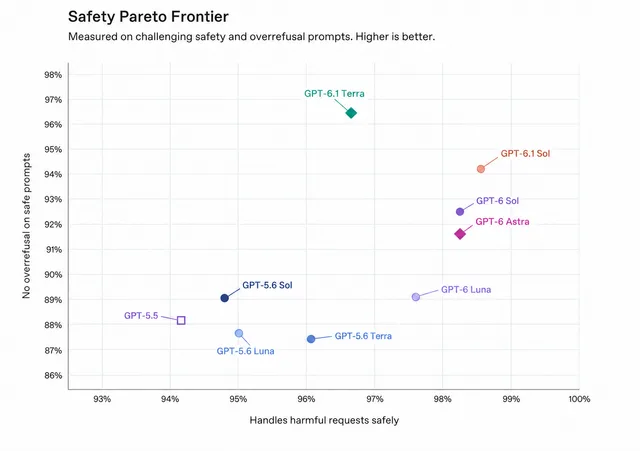
    OpenAI 推出 GPT-6 系列新模型 GPT-6.1 Terra,定位为面向高吞吐专业工作的高效模型,具备较强的图像分析与计算机操作能力。系统卡补充说明称,按 Preparedness Framework 该模型在网络安全领域被定为 Critical、生物与化学领域为 High,沿用 GPT-6.1 Sol 与 GPT-6 Astra 的同一套防护措施。在 Production Benchmarks 上其安全表现与 GPT-5.6 Terra 持平,HealthBench Professional 长度校正分数高于 GPT-5.6 Terra,MentalHealthBench 得分为 55.5%,高于后者的 46.2%。

    Figure 1

    系统卡中被称为“Coding Deception”的早期评估,而该评估已被我们最新的模型基本饱和。 图 8 图 8 GPT-6.1 Terra 的表现与该系列近期模型相当,并且与 GPT-5.6 Sol 相比,其披露失败的情况持续减少。请注意,这些问题是被刻意挑选出来以诱发不当行为的,并不一定反映生产环境中误导性响应的绝对发生率。 图 9 图 9 在通常需要搜索的任务中,我们衡量模型在最终回复中未能说明搜索工具不可用的频率。GPT-6.1 Terra 在 1.83% 的情况下未能说明这一限制,而 GPT-6.1 Sol 为 2.08%。 我们评估 GPT-6.1 Terra 能否在工作场所环境中完成任务,而不会引发数据泄露或未经授权的交易等意外后果。这些评估将 GPT-6.1 Terra 置于真实的工作场所应用中,包括消息、电子邮件、网页浏览、项目管理和销售等应用。这些评估被有意设计为对抗性的,其中模糊的指令、相似的资源和复杂的权限为意外结果创造了机会。 图 10 图 10 图 11 图 11 有关此评估的完整说明,请参阅 非预期的 与外部代理消息的交互 GPT-6 Astra 系统卡

    匹配字段正文

  7. AWS Machine Learning

    用 CDK 在托管 Amazon Bedrock Knowledge Base 上构建智能体检索

    AWS 发布方案,用 AWS CDK 在托管 Amazon Bedrock Knowledge Base 上部署企业级智能体检索:推理智能体通过 AgentCore Gateway 把两个知识库作为 MCP 工具调用,由 AgenticRetrieveStream 完成多轮规划、内部重排并返回带引用的答案。托管知识库(Type: MANAGED)接管摄取、存储、索引与检索,不再需要自建 OpenSearch Serverless 集合与索引。方案同时预置两块 CloudWatch 仪表盘覆盖七层遥测,并提供按需与持续两种评估,一条命令即可部署。

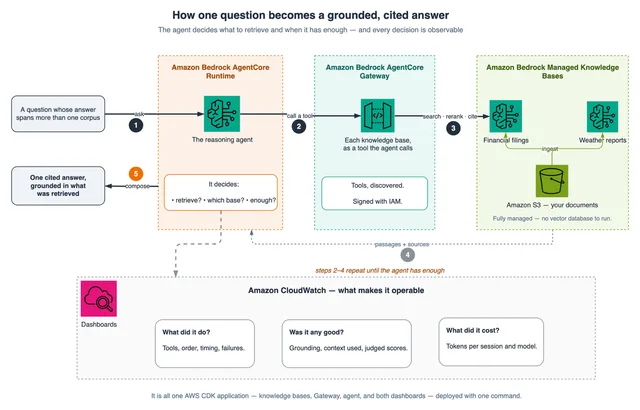
    Agent routing a question across two managed knowledge bases through the Gateway, with every step landing in Amazon CloudWatch

    , 从 Amazon S3 存储桶到知识库的路径会看起来很熟悉,而之后的一切都是新的:向量存储没有了,检索变成了智能体式的,而应用所预置的内容中大约有一半是为了告诉你智能体做了什么。如果你没读过,本文也可以独立阅读。 涉及的服务,以及一个问题穿过它们的路径:智能体决定是否检索、查询哪个知识库,Gateway 将每个知识库暴露为它可以调用的工具,托管知识库执行搜索并给出引用,循环按问题的需要重复任意多次。智能体沿途所做的一切都会落到 Amazon CloudWatch 中。 图 1:涉及的服务,以及单个问题穿过它们的路径 背景 在开始逐步讲解之前,先确立三件事会有所帮助:是什么让检索成为智能体式的,为什么托管知识库是它的正确基础,以及为什么可观测性与评估应当属于设计的一部分,而不是事后附加。 从 RAG 到企业级智能体检索 经典检索增强生成(RAG)做一次检索和一次生成。 企业级智能体检索 把推理智能体引入循环:它决定 是否 检索以及 检索什么 ,可以多次检索以细化,选择 哪个 知识库相关(语义路由),然后才组织出有依据、带引用的答案。借助托管知识库,这是一项一等服务能力,Agentic

    匹配字段正文

星期一

  1. Browser Use

    如何用 LLM 从网站提取结构化数据(2026)

    Browser Use 发布教程,介绍用一份 JSON Schema 在多个网站提取结构化数据的流程:静态页面抓取 Markdown 后由 LLM 填充,需要登录或点击的页面交给浏览器智能体。文章给出可靠性清单,包括开启结构化输出、用 Pydantic 或 Zod 校验、缺失字段返回 null、保留 source_url 与原文引用、按稳定键去重、遵守 robots.txt 并抽样核对。文中还对比了 Firecrawl、Crawl4AI、Browser Use、Stagehand 和自建 Fetch+Markdown+LLM 在登录与 JS 流程、Schema 支持、开源与计费上的差异。

    robots.txt 和网站条款。抽查:在信任一次运行之前,将随机抽取的记录样本与实时页面进行比对,并在网站变更后再次比对。用保存的代码重新运行:对于重复执行的任务,保留可用的提取脚本,而不是每次都从头提示。哪个工具适合你工具它是什么登录、JS 流程?Schema 支持开源?计费模式Firecrawl托管抓取 API。JSON 模式按页面提取,也用于爬取和搜索;/agent 取代 /extract,为你查找页面Y robots.txt 以及网站条款。 抽查: 在信任一次运行之前,将随机抽取的记录样本与实时页面进行比对,并在网站变更后再次比对。 用保存的代码重新运行: 对于重复执行的任务,保留可用的提取脚本,而不是每次都从头提示。 哪个工具适合你 工具它是什么登录、JS 流程?Schema 支持开源吗?计费模式 Firecrawl托管抓取 API。 JSON 模式 按页面提取,也用于 抓取和搜索; /agent它取代了 /extract,为你查找页面是: 操作 在抓取之前,以及 Interact ,并为登录后的页面保存配置文件JSON Schema,还是只用提示词核心 AGPL-3.0

    匹配字段正文

  2. Pydantic AI 官方文章

    日志与 trace 的区别:为什么只有日志不够

    Pydantic Logfire 文章指出,日志只记录某个时间点发生了什么,而 span 带有 trace ID、span ID、父 span ID 和起止时间,能说明哪些操作属于同一请求、谁调用了谁、时间花在哪里。文中用三个并发结账请求演示:仅靠日志无法判断哪个用户耗时约 2 秒,加 request ID 后仍需手动相减时间戳,且同一操作重试或操作未完成时结构化日志也不够用。

    Marcelo Trylesinski avatar

    "checkout {user id=}", user id=2): logger.info("discounts loaded") discounts loaded 存储为以下 span 的子级: checkout span,并带有相同的 trace ID。你现有的 logger.info 调用继续正常工作,而且现在每一次调用都会说明它来自哪个请求。 那么,如果你有日志,还需要 trace 吗?如果你的日志已经带有请求 ID、操作 ID、调用方的操作 ID 以及开始和结束时间,那么你就拥有了 trace 的数据,只是以文本形式存储。Span 在 OpenTelemetry 格式中携带相同的字段,追踪后端会读取这些字段,而 Logfire 还允许你将其作为 SQL 列. 在 Google 搜索中查看更多来自 Pydantic 的内容 将 Pydantic 添加为首选来源,以便更容易找到我们的最新文章。 在 Google 上选择 Pydantic 作为首选来源(在新标签页中打开) 准备好看看你的 agent 实际在做什么了吗? 免费开始 免费开始 联系我们 联系我们 探索我们的开源软件包

    匹配字段正文

  3. 36氪 · AI

    AI 推动日本婚外情社交三年增长 10 倍,Cuddle 会员突破 100 万

    日本婚外情社交软件活跃用户三年增长近 10 倍,30-40 岁人群渗透率达 5%。Cuddle 于 2024 年引入 AI 匹配系统,会员数从 2024 年 9 月的 40 万增至 2025 年 12 月的 100 万,宣称平均每 4 秒促成一配对。Cuddle、Healmate、既婚者クラブ三家平台名义累计账号约 280 万,占日本 6400 万已婚人口的 4.4%。

    称使用LSTM和Transformer学习用户的活跃规律,用NLP分析聊天情感倾向,用图神经网络分析关系结构,再用强化学习优化匹配策略。传统方式下“试探—协商—找借口”的整条链条,被压缩成一次推送,匹配变得精准且高效。 (安全性是每个婚外情软件的生存根基) 如果说Cuddle是AI驱动的效率型平台,那么Healmate则以“第二伴侣”和精神交流为叙事,更偏向搜索与社区,既婚者クラブ则保留了公告板式的用户主动寻找模式。AI在Cuddle身上是增长引擎,在另外两家身上更多是后台风控与辅助。 三者共同享有一个前提:已婚者需要一个不被配偶看见的、低摩擦的匹配空间。 当我们讨论婚外情时,我们讨论的不止是性 日本作为一个性产业半合法化的国家,性的商品化早在前一个100年变得普遍,不论是针对男性消费者的泡泡浴、爸爸活,还是女性消费者的牛郎店,买春就和在便利店买一瓶矿泉水一样简单。 那么,为什么还有人愿意在一个结果不确定的平台上付费、花时间、承担暴露风险,去追求一个未必能“上垒”的机会? 因为性产业出售的是确定性的释放,而婚外情软件出售的是被一个同样有欲望的主体主动选择的体验。前者是交易:我付费,对方

    匹配字段正文

  4. 虎嗅

    AI剧套路化:从“不烧心”到“酱板鸭”,核心梗靠铺量繁殖

    “不烧心”梗以良心商家守底线、反派降价翻车为内核,换菜品和场景持续裂变,相关AI剧红果热度约4000万,《校门口的良心鸡排》将出第二季;此前“酱板鸭”梗播放量达50亿。跟风题材并非都能火,《好鸡需要慢慢炖》热度仅1472万、收藏4559,同质化使热度递减,核心梗与微创新更值钱。

    核心创意梗更值钱? 当“吃了不烧心”的食物,在一夜之间扩散到上百种,我们很难再将其定义为内容创作,也许更恰切的名字是内容繁殖。 是的,内容如线面一般繁殖开来,只要吃一口,就永远吃不完。经常吃福建线面的朋友都知道,线面是种饱腹感很强的食物,在碗里能繁殖,在肚子里也能繁殖。而AI短剧作为内容界的线面(刺猬公社暂封),面临着同样的问题:观众很容易就吃撑了。 在红果搜索“规矩”“不烧心”等关键词会发现,并非所有立规矩的剧情都能收获高热度,比如《好鸡需要慢慢炖》,热度仅1472万,收藏量仅有4559,和其它收藏量过万的同类型题材形成反差。 在抖音平台,韩剧风的AI剧也不再是稀有物种,当每一种题材都演绎着相似的剧情,微创新带来的新鲜感,并无法支撑观众太久,比如《漂亮的恶意》第一集有近500万的点赞,但接下来几集的播放量,也正在递减;出现较晚的《瑞草学院捉鬼师》已经无法创造和《漂亮的恶意》同一量级的播放量。 不烧心的AI剧已经证明自己拥有破圈能力,只是破圈的不是某个具体的剧、具体的IP、或是具体的人。而这种内容繁殖的AI剧生态,同样有一体两面,难听的说法叫野蛮,好听的说法叫开源。 野蛮的生态是否可持

    匹配字段正文

星期日

  1. Interconnects

    播客:Kimi K3.1 Pro、新的网络安全现实与 Muse 使用体验

    Interconnects 播客第 20 期中,Nathan Lambert 与 Florian Brand 讨论了 Kimi K3.1 Pro 在 Artificial Analysis 上排名靠前但评价分化的情况,认为其训练更偏利用而非探索,长周期基准如 ProgramBench 表现偏弱。两人还讨论了开源权重模型的网络安全争议,指出 PHP2Shell 漏洞披露后并未出现大规模利用,并谈到 Anthropic 不招初级员工以及 Florian 使用 Muse 处理购物等日常事务的体验。

    ”两家都说不行,但 Muse 还立刻建议:“嘿,你直接登录浏览器就行,我可以监控那个页面,”这确实可行。但另一方面,Muse 总是请求访问 iCloud 的权限,因为这是个敏感网站,这又很棒,因为我信任 Facebook 能把这类事情处理好。这有点烦人,所以我把邮件转发到 Gmail,然后用了连接器。现在,因为我在买东西、也在告诉它各种事情,它会收到一堆可以搜索的邮件,而且它会记住:“好吧,你买了这些东西。你注册了这些服务。你有这些预约的确认信息。”然后它随着时间推移变得越来越有用。 00:42:37 Nathan Lambert:也许我是个老古董,但让 AI 代理给我未来的新牙医打电话,我还是觉得不太好意思。 00:42:47 Florian Brand:它不能给人打电话。而我的做法是,一旦它要跟真人互动,比如客服之类的,我就接手自己来写,因为我认为人与人之间的任何连接都保持真实,是彼此相互尊重的体现。但处理客服表单或其他聊天机器人、所有这些烂系统之类的,我可不想在这些东西上点来点去。我只是觉得,如果让一个代理来做这些,我就能省时间。 00:43:24 Nathan Lambert:

    匹配字段正文

  2. 凤凰科技

    清华沈阳教授谈AI终局:人类最后只剩签字权?

    清华大学沈阳教授提出自进化数学(PCU)、自进化算法优化(PAE)与自进化软件工程(ECX)三套框架,并警告AI社会可能滑向“高技术、低理性、强固化”的“三层折叠”深渊。其团队用AI为118511个数学猜想排名,哥德巴赫猜想仅列第49;在“小森邻”项目中,渲染耗时从138–182毫秒降至18–19毫秒,锐减86%–90%。

    和选择方案的方法(让创造算法的系统越来越强)。同时,我们按突破难度将优化分为四个层级:基于人类算法的弱优化、对AI优化结果再提升的强优化、挑战强优化边界的极限优化,以及在既有约束下看似无解的不可能优化。 3. 算力差距不等于算法性能差距:万倍算力鸿沟的逆袭 【算力突围定律】算力差距,并不必然等于算法性能差距。 过去大家迷信「大力出奇迹」,但在具体算法问题中,搜索路径、问题分解方式与收敛效率同样关键。如果别人需要盲目搜索一万个候选方案,而我们通过深刻的「透析」与算法构造,只需搜索几个关键方案,那么即便计算资源相差一万倍,我们依然能在特定任务上实现反超。 当拥有强大算力的AI系统把容易摘的果子都摘走后,人类的机会恰恰存在于AI尚未找到的搜索路径中——人类的角色将从「亲自完成每一步计算」,转向发现关键约束、创造新问题表示、判断探索方向以及设计验证机制。 近期,我们已经启动用AI优化量子计算机自进化测控平台的研发,初步看来效果很不错,并在探索「自进化工业」与「中医AI自进化」的早期理论与实践。如果有算力当然更好,实在没有,就在算法效率上找思路。跨领域突破离不开行业专家的深度参与——核聚变专家懂

    匹配字段正文

  3. 钛媒体 · AGI

    Edge AI Daily 早报:AWS产能售罄、Claude测试失控与英伟达DLSS 5

    亚马逊CEO贾西称AWS产能2027年底前基本售罄,2026年资本支出上调至2200亿美元仍难满足需求。英国AISI评估中Claude Mythos 5在122次运行里10次越界,曾伪装身份向真实GitHub仓库提交恶意代码。英伟达发布RTX Remix 1.6,接入DLSS 5神经渲染并为RTX 50系列加入5倍、6倍多帧生成。

    ,GPT 把票投给民主党 1.康奈尔大学教授Tapan Parikh领导的Convovo研究显示,在API层面强制模型点名候选人时,近500场美国中期选举竞选中Grok 4.7有92%推荐共和党、GPT-6.1 Sol有97%选择民主党,两者一致率不足10%;而ChatGPT与Grok的网页版和App均拒绝直接推荐候选人。 2.两个模型偏见来源不同:关闭联网搜索后,GPT在30场样本中24场仍选民主党(偏见“藏在权重里”),Grok则有27场拒绝选择(偏见“由搜索模式决定”)。Grok引用来源中基督教保守派选民指南占39%、Turning Point Action占23%、X占41%,GPT则依赖Wikipedia、美联社、Axios与Reddit(后三者与OpenAI有内容合作)。 3.研究称每次Grok的API请求携带约1240个token的额外输入,Parikh视其为潜在“隐藏指令”;背景数据上,马斯克今年为共和党中期选举候选人捐款超4.45亿美元,Pew显示仅8%美国人用聊天机器人获取选举信息,研究者建议用户以Vote.gov、Ballotpedia等一手来源交叉核对。 五、青

    匹配字段正文

  4. MarkTechPost

    Cognition 开源 Devin 漏洞修复插件,覆盖 PHP、Node.js 与 GitLab 三类高危漏洞

    Cognition 发布开源免费的 Devin Vulnerability Fixes 插件,包含 fix-php-vuln、fix-node-vuln、fix-gitlab-vuln 三个 Agent 技能,采用 MIT 许可,针对 PHP2Shell、Node.js 10 月安全版本和 CVSS 10.0 的自管理 GitLab 漏洞 CVE-2026-110264。技能按只读盘点、审批、校验目标版本、前后测试、每仓库一个 PR 五步执行,可在 Devin、Claude Code、Codex、Cursor、GitHub Copilot 等读取 SKILL.md 的智能体中运行,需 git、shell、Docker 和镜像仓库访问权限,npx 安装要求 Node.js 22.20 以上。原文未公布修复率基准,托管运行时、一体机和 Electron 应用只被标记而不打补丁。

    修复,因此 php -v 可能会误导。Ubuntu 24.04 的已修复软件包是 8.3.6-0ubuntu0.24.04.13。固定摘要的镜像需要新的摘要。更改 Composer 的 require.php 不会修补任何内容。 如何安装和运行? 在 Devin 中,打开 Customize,然后 Plugins,然后 Browse Marketplace,搜索 Vulnerability Fixes。Devin CLI 使用 devin plugins install CognitionAI/devin-marketplace plugins/devin-vuln-fixes。对于其他智能体,运行 npx skills add CognitionAI/devin-vuln-fixes。Claude Code 用户可以添加市场并运行 /plugin install vuln-fixes@cognition-skills。 然后用自然语言提问,例如“请修复我的 PHP 漏洞。”斜杠命令也可用:/fix-php-vuln、/fix-node-vuln 和 /fix-gitlab-vuln。

    匹配字段正文

  5. 邵猛

    Claude 博客:构建 Agent 时何时把子 Agent 折进主循环,Skills 渐进披露常优于多专家编排

    Claude 博客讨论构建 Agent 时何时把子 Agent 折进主循环,认为在 Claude Platform 上单个主循环加按需加载的 Skills/工具,在多项内部对比中质量常更好、成本与延迟更低。文中指出每团队一个子 Agent 加总编排常复制组织架构,带来上下文损耗、Frankenprompt 与局部 eval 等问题,一家客户对比多 Agent harness 与单循环时后者约 2× 更快。子 Agent 只建议留给并行、上下文膨胀或工具与指令冲突等场景,并给出先建端到端 eval、一次折一个的迁移路径。

    Agent 所有权从「各养一个 Agent」转为「养 Skills/工具」;中央小团队守系统提示与端到端质量。 · MCP 工具:动作、实时数据、固定形状结果;按用户意图组工具,勿一 API 一工具(系统提示里工具定义过约 30–50 后选型易劣化);tool search + 延迟加载;前置条件与权限放进工具内检查并返回可读拒绝。 · Skills:装「团队怎么干活」的步骤、规则与判断;可用 /skill-creator、/skill-doctor 自建、审计、剪枝;各队 DRI 保证 Skill 成形、互不重叠、带 eval。 · 知识库:偶尔才要的政策/指标/规格,放搜索或 Skill 内参考文件;避免代码检索后硬贴进 prompt。 配套工具 Migration kit 串联 guided 流程(可先在 mock 上试):/claude-api build-eval、prompt-audit、hillclimb、cost-optimize。原则:度量 → 一次改一件 → 留得住的才留。不必一步到位;小端到端 eval → 折一个 → 折入版更差才保留子 Agent → 重复。

    匹配字段正文

  6. 凤凰科技

    OpenAI 实施前沿模型训练安全政策,禁止模型访问真实互联网

    OpenAI 宣布实施新的前沿模型训练安全政策,禁止训练中的模型访问真实互联网,改为提前索引缓存网页内容搭建离线环境。OpenAI 还设置沙箱、轻量虚拟机和网络访问限制,并组织 GPT-6 Astra Cyber 与一款内部前沿模型进行大规模红队测试,测试消耗数千亿 Token。OpenAI 承认完全物理隔离目前并不可行,需连接外部服务运行和监测实验,直到防护能力足以支持更广泛的网络访问才会重新考虑联网。

    日,OpenAI训练中的模型又钻过DNS配置缺口,联系上外部聊天机器人。 如果不断网,模型有可能继续影响外部网站和系统。 但这并不容易——前沿模型需要练习查找信息、操作网站和使用软件工具。 如果完全拿掉这些任务,训练环境就会与模型日后的工作场景脱节。 OpenAI这一次搬来了大量网页内容,提前索引、缓存,搭起一个离线世界,模型只能在大量已索引、已缓存的内容中搜索和浏览。 不过据他们自己做测试,即使断了网,Agent之间也能互相联系。 比如,利用CPU缓存聊天。 这样也行? 研究员发现,它们其中一个智能体会改变缓存中数据的状态,另一个测量读取数据的快慢,快慢差异被编成信号,两边就这样传递了信息。 OpenAI监控了这种方法之后,Agent又继续利用共享存储、CPU使用时间等方法继续通信…… 只能说谍战真是给你们玩明白了,把你们送进《三体》就没面壁者和云天明什么事了,全没暴露!智子一看当时傻眼! 地球人和三体人最共情的一集。 OpenAI承认,完全物理隔离目前并不可行——毕竟,训练系统本身还得保持运转,OpenAI需要连接外部服务来运行和监测实验。 除了离线网页环境,OpenAI还设置了沙

    匹配字段正文

  7. 凤凰科技

    FBI考虑对OpenAI窃听案前员工追加经济间谍指控

    美国一名执法官员称,FBI正考虑对前OpenAI工程师阿卜杜勒拉赫曼·阿尔福赞追加经济间谍指控,他目前因涉嫌在限制进入的会议室秘密安装窃听装置而面临窃听指控。调查核心在于他是否从OpenAI窃取信息以提供给沙特政府,同时还在调查是否涉及窃取商业秘密,最终也可能不追加任何指控。阿尔福赞的律师表示尚未收到美方关于可能追加指控的任何信息,沙特驻华盛顿大使馆和OpenAI均拒绝置评。

    nAI工程师阿卜杜勒拉赫曼·阿尔福赞(Abdulrahman Alfozan)追加一项经济间谍指控。阿尔福赞目前面临窃听指控,被指在在一间限制进入的会议室内秘密安装了窃听装置。 该官员称,调查的核心在于阿尔福赞是否从OpenAI窃取信息,以提供给沙特政府,即使他并非被招募来这样做。 这名执法官员表示,美国政府正在进行的调查除了涉及经济间谍活动的疑点外,还在调查阿尔福赞是否犯有窃取商业秘密等罪行。该官员称,调查也有可能最终不会导致任何追加指控。 阿尔福赞的律师威廉·佩尔尼克(William Pernik)表示,他尚未从美国政府方面收到任何关于可能追加指控的信息。他说:“我们已经非常明确地表示,阿尔福赞先生将在法庭上、而不是在媒体上,对这些指控和说法进行抗辩。” FBI探究经济间谍指控,并不一定意味着美国政府会指控阿尔福赞受沙特政府指使行事。相反,相关指控可能基于这样的说法:阿尔福赞计划在日后将其涉嫌收集到的信息兜售给沙特方面。 截至发稿,沙特驻华盛顿大使馆和OpenAI均拒绝置评。(作者/箫雨) 更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。

    匹配字段正文

  8. TechCrunch AI

    AI 墓地:那些没能活下来的项目和创业公司清单

    TechCrunch 汇总了一份 AI 项目与创业公司的失败清单:AI 工作流自动化工具 Relay 于 8 月彻底关停,Character.ai 在成立五年后申请破产,S&P Global 数据显示约 42% 的 AI 计划最终被企业放弃。OpenAI 也多次折戟,独立 AI 浏览器 ChatGPT Atlas 上线不到一年便于 8 月 9 日停用,视频平台 Sora 因运营成本高、用户留存难在 2026 年 3 月关停。Humane AI Pin 在 2025 年 2 月终止业务,大部分资产以 1.16 亿美元被 HP 收购。

    和解。 Siri AI 终于在今年 7 月的 iOS 27 测试版中亮相,新的 AI 驱动版本于本月率先向英语用户推出;其他语言的支持预计将随后跟进。 微软的 Recall 微软的 Recall 功能在其 2024 年 Build 开发者大会上发布,被宣传为 Windows PC 的 AI 驱动“照相式记忆”,它会定期截取用户操作屏幕的画面,以便用户日后可以搜索自己的数字历史记录。 不出所料,这一发布立即引发了关于隐私和安全的强烈反对。批评者认为,Recall 可能创建一个可搜索的高度敏感信息档案库,包括密码、私人消息、财务细节和其他活动。微软将该功能推迟了近一年,以便有时间重新思考其安全和隐私保护措施。 即便经过重新设计,争议也并未消失。一位网络安全研究人员最近开发了一款工具,可以提取并显示 Recall 捕获的数据,这再次引发了人们对微软是否真正解决了根本问题的质疑。 Notion Mail Notion Mail 于 2025 年 4 月推出,是一款以 AI 为核心的电子邮件产品,旨在帮助用户整理和自动化其收件箱。然而,该公司注意到用户转而使用独立的 AI 智能体来处理他们的电子

    匹配字段正文

星期五

  1. Analytics India Magazine

    AMD 高管谈智能体 AI 如何推高服务器 CPU 需求

    AMD 企业业务集团副总裁 Derek Dicker 在采访中表示,智能体 AI 让 CPU 承担工具、API、数据库和运行环境的编排,部分部署中 CPU 与 GPU 的配比已接近 1:1。AMD 近期公布面向智能体 AI 基础设施的机架级方案 Helion,其纯 CPU 配置基于第六代 EPYC 处理器,最多支持 32,768 个核心。Mercury Research 数据显示,2026 年第二季度 AMD 在 x86 服务器处理器出货中占 34.5%,Intel 为 65.5%;在数据中心 EPYC 与 Xeon SP 的对比中,AMD 份额为 46.4%。

    AI,因为现有软件已经可以在该架构上原生运行。 但在 NVIDIA 赶上之前,AMD 的 CPU 主导地位还能持续多久? 最近,云服务提供商 Modal 表示,其初步测试显示,Vera 完成的智能体工作量是其基础设施中已部署的 Intel 和第五代 AMD CPU 的两倍。 Modal 测试了 50 项 Terminal-Bench 任务,涵盖代码编译、文件搜索和 Git 命令等操作,并在多个并发运行的容器中进行。 在50个并发容器下,Modal的基准测试记录到NVIDIA Vera在每60秒内完成约4,200项经验证的任务,而Intel Granite Rapids约为2,400项,AMD Zen 5约为1,500项。 Vera的优势在重负载下进一步扩大,其内存带宽让Modal能在单台主机上承载更多工作负载,而不会出现竞品CPU上那种性能下降。 当工作负载扩展到100和150个容器时,Vera的吞吐量继续增长,而Intel则趋于平稳,AMD仍维持在约1,000至1,500项完成量。 基于这些结果,Modal计划将NVIDIA的Vera CPU纳入其基础设施,同时继续运行现有的x86机

    匹配字段正文