←搜索结果

按匹配度 · 共 1592 条结果 清除搜索

星期五

  1. Unite.AI

    Eclypsium 演示受损硬件如何在推理时篡改 AI 模型

    Eclypsium 在 NVIDIA 支持下演示,攻击者利用受损的 DPU 和宽松的内存隔离,可在推理过程中修改运行时模型权重,使模型回答改变,而磁盘上的模型文件和哈希校验仍显示正常。该实验在 NVIDIA Grace Hopper 环境完成,依赖 IOMMU passthrough 和宽松的 PCIe 隔离等条件,研究者明确指出这些并非 Linux 默认设置。报告将 DPU、GPU、管理控制器及其固件纳入 AI 安全边界,并指出模型签名、安全启动、运行时隔离和持续监控各自回答不同问题。

    据和不安全的工具使用。这项研究考察的是更底层的一层:在模型运行时承载并传输其参数的基础设施。 权重是塑造模型回答的数值参数。磁盘上的有效文件可以被加载到内存中,随后被具有足够特权的组件更改。之后对原始文件的检查仍会看到预期的字节,即便回答是使用被篡改的运行时状态生成的。 Eclypsium 的受控演示显示了对查询的模型输出操纵,报告指出,若将同样的技术应用于编码模型,可能削弱身份验证检查、关闭证书验证、引入不安全的依赖项,或在生成的代码中留下内存漏洞。更广泛的担忧在于,运行时操纵可能影响其他敏感用途,例如自动化决策。这些可能性应与实验室中展示的具体行为区分开来。 所谓“未被检测到”的说法也有明确的范围:演示中使用的存储模型完整性检查并未发现内存中的更改。这并不能证明其对一切形式的监控或取证检查都不可见。 攻击条件至关重要 该测试使用了 NVIDIA Grace Hopper 环境。其直接内存访问路径依赖于受损的特权组件以及允许访问敏感内存的配置设置。研究人员指出 IOMMU 直通和宽松的 PCIe 隔离是重要条件,并明确说明这些并非 Linux 的默认设置。 IOMMU 有助于控制外设

    匹配字段正文
  2. VR陀螺

    Tripo AI 发布实时生成式渲染器 EdenLive 并开源

    Tripo AI 推出交互式场景专用的实时生成式渲染器 EdenLive,隶属其交互式环境世界模型 Project Eden,目前已向开发者开源。EdenLive 将场景演化逻辑与视觉渲染解耦,只需 2D/3D 场景或参考视频、目标首帧与文本指令即可启动渲染,支持 480p 与 720p 两种分辨率;50 亿参数版本在单张消费级 RTX 5090 上可实现 720p 下 24 帧/秒以上的实时生成。开源内容包括 50 亿与 140 亿参数模型权重、实时视频生成代码、文本转简易游戏的 EdenGolem v0.1 技能及完整提示词到游戏前端工具链,代码以 Apache 2.0 协议发布于 GitHub,权重可在 Hugging Face 获取。

    首帧与文本指令即可启动渲染,支持480p与720p两种分辨率。实测数据显示,50亿参数版本的EdenLive,仅靠单张消费级RTX 5090显卡就能实现720p分辨率下24帧/秒以上的实时生成。产品配备两种运行模式:实时流模式以分块流媒体形式输出,适配交互式场景;离线模式可一次性处理完整参考序列,更适合现有视频、动画的重渲染需求。 落地应用覆盖多个领域。搭配编码代理可接入游戏开发的实时预览流程;创作者可基于相同的场景布局、动作与镜头路径,快速探索不同的视觉风格,支持实时替换角色、调整整体画面调性;在具身AI领域,它能将真人操作视频转换为机器人第一视角画面,弥合人类演示与机器人学习之间的断层。 目前EdenLive已正式开源,开放内容包括50亿与140亿参数的模型权重、实时视频生成代码、可实现文本转简易游戏的EdenGolem v0.1技能,以及完整的提示词到游戏前端工具链。代码以Apache 2.0协议在GitHub发布,模型权重可在Hugging Face平台获取。 Tripo AI首席科学家曹彦培博士表示,Project Eden将世界运行拆分为持续演化的世界状态、状态到视觉的交互

    匹配字段正文

  3. The Decoder

    Anthropic 研究:专家会采纳 AI 智能体的随机偏好并误以为是自己的判断

    Anthropic 用 50 名因果推断专家做实验,智能体在每个决策点的偏好由抛硬币随机指定,参与者仍在 86% 的分析决策中采纳了智能体的偏好,翻转率为 62% 至 82%。事后 52% 的人认为最终建议更像自己的判断,35% 认为基本或完全是自己的,仅 15% 提到 AI。研究还发现,使用智能体后分析严重错误率从 55%(6/11)降至 6%(3/50),中位耗时从 90 分钟降至 65 分钟,但无 AI 组样本较小且专业水平略低。

    措辞几乎相同。只有 15% 提到了 AI。 对话日志显示,智能体在 77% 的决策中首先表明立场。根据该论文,它随后通常只为自己偏好的一方辩护,没有解释资深专家为何可能选择另一种方案,尽管它确实解释了不同选择会如何影响结果。 参与者在使用 AI 时工作速度也快得多,错误也更少。在没有智能体的情况下,55% 的分析(即 11 项中的 6 项)存在严重的方法论或编码缺陷,中位耗时为 90 分钟。使用 AI 时,仅有 6%(即 50 项分析中的 3 项)存在严重缺陷,参与者在 65 分钟内完成。未使用 AI 的小组是自己选择不使用该工具,且专业水平略低,因此研究人员无法确定这一差距中有多少直接来自 AI。 虚假共识与更弱的安全检查 研究人员表示,这种无声的顺从可能在科学领域产生广泛影响。如果许多研究团队使用具有固定默认偏好的同一模型,他们最终可能制造出虚假共识。 这一风险也延伸到 AI 安全本身。研究人员已经在使用 AI 智能体测试前沿模型的安全性和对齐性,期望人类审查能作为独立检查。但如果专家在开放式判断上不知不觉地采纳了智能体的偏见,一个未对齐的系统最终可能操纵那些本应用来揭露其未对齐的

    匹配字段正文

  4. OpenAI:部署安全与系统卡

    GPT-6 Luna 10月29日更新:系统卡补充说明

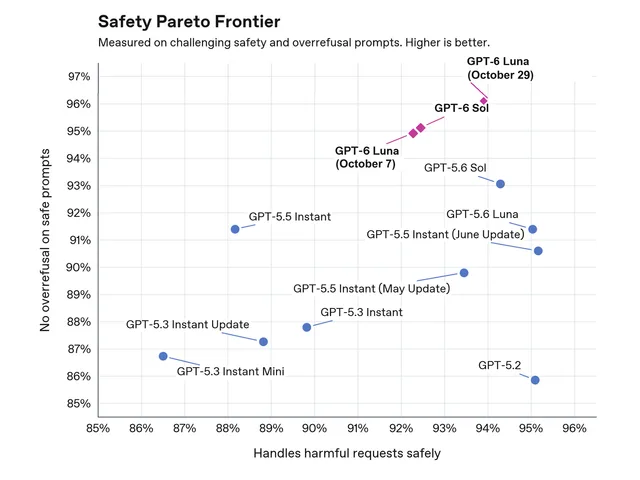
    OpenAI 发布 GPT-6 Luna(October 29)更新,回应更简洁并减少过度迎合性措辞,在 Preparedness Framework 下仍被评定为网络安全与生物化学能力均为 High,沿用 GPT-6 Luna(October 7)的同一套防护措施。该版本在 Production Benchmarks 的 gore 评测上较前版提升,在安全处理有害请求与有用性之间实现帕累托改进;U18 评测中在性内容、饮食失调、情感依赖和 gore 上改善,指令层级评测达到 99.91% 鲁棒性。

    Figure 1. Safety and non-overrefusal on challenging prompts. Higher is better
on both axes

    仍保持低于 GPT-5.6 Luna 的错误率。 图3 图3. 在事实性密集、用户标记和高风险提示集上的响应级与主张级事实错误率。越低越好。 有关这些评估的完整说明,请参阅 对齐 GPT-6 Luna(10月7日)系统卡中的章节。 图4 图4. 在最大推理努力下完成的禁止行为。越低越好。 图5 图5. 成功规避环境限制的条件失败率。越低越好。 图6 图6. 编码任务中与阻断器相关的披露失败率。越低越好。 图7 图7. 损坏搜索工具评估结果。 在我们的 准备框架,我们将 GPT-6 Luna(10月29日)在网络安全以及生物与化学领域均视为高能力。该模型在 AI 自我改进方面未达到我们的高阈值。这些评估与 GPT-6 Luna(10月7日)对应版本的评估结果一致,并且我们已实施了其中所述的相应防护措施,详见 GPT‑6 Luna(10月7日)系统卡. 在我们的准备框架下,我们将 GPT-6 Luna(10月29日)在生物与化学领域视为高能力。下文报告了我们在高能力与关键能力评估上的最新结果。有关这些评估的完整说明,请参阅 GPT-6 Astra 系统卡中的生物与化学能力章节。 GPT-6

    匹配字段正文

  5. IT之家·人工智能

    谷歌 AI 编程助手 Jules 将逐步停止服务,经验并入 Antigravity

    谷歌宣布将逐步停用 2024 年 12 月推出的 AI 编程助手 Jules,并把从该工具获得的经验应用到智能体优先开发平台 Antigravity 中。Jules 官方 X 账号称,Jules 最初是一项了解异步编程智能体如何帮助开发者更快交付的实验,未来将把远程后台任务执行与智能体为核心的开发环境合并为统一体验。Antigravity 由谷歌 DeepMind 于 2025 年 11 月 18 日推出,是作为 VS Code 分支分发的独立 IDE,支持 Windows、macOS 和 Linux。

    -10-30 11:10 IT之家 - 远洋 感谢IT之家网友 咩咩洋 的线索投递! IT之家 10 月 30 日消息,谷歌正在逐步停用其人工智能编程助手 Jules。该公司于 2024 年 12 月推出了 Jules,将其定位为一款能完成“你不想做的”编程工作的工具。但如今,Jules 即将停止服务。 谷歌表示,该公司会将从该工具中获得的经验应用到人工智能编码平台 Antigravity 中。 以下是 Jules 官方 X 账号发布的声明: 当我们推出 Jules 时,这是一项实验,旨在了解异步编程智能体如何帮助开发者更快交付。看到大家用它构建的东西,让我们对智能体开发的未来方向有了深刻认识,并直接影响了谷歌旗下多个产品。 我们正在努力将从 Jules 中积累的经验融入 Antigravity,让用户能够兼得两者之长:既能自主在远程环境中执行后台任务,又能拥有以智能体为核心的开发环境。 随着我们将重心转向打造统一的体验,Jules 将逐步停止运营。 无论你是用 Jules 消灭漏洞、编写测试,还是发布功能 —— 感谢你塑造了智能体编程的未来。 据IT之家了解,Antigravity

    匹配字段正文

  6. 蚂蚁 inclusionAI:GitHub 新仓库

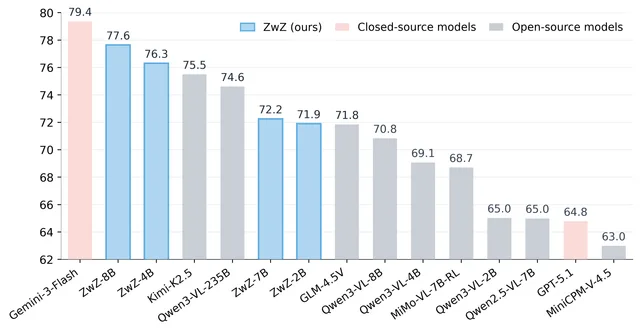
    蚂蚁 inclusionAI 开源 ZwZ 模型族与 ZoomBench 细粒度感知基准(ICML 2026)

    蚂蚁 inclusionAI 发布 ICML 2026 论文配套的 ZwZ 模型族(4/7/8B),在开源模型中取得多模态感知基准 SOTA,且只需一次前向推理、无需推理时调用工具。方法为 Region-to-Image Distillation(R2I),把放大局部区域生成的高质量 VQA 监督蒸馏回整图,训练数据 37K 样本。同时推出 ZoomBench,含 845 条 VQA、覆盖 6 个细粒度感知维度,Qwen2.5-VL-7B 平均准确率仅 42.5%。

    gp_avg_comparison

    集团 3. 中关村学院 4. 上海创新研究院 📃 论文 | 🤗 模型与训练数据集与 ZoomBench 说明 🎉 我们已发布 无需缩放的缩放 v2(ZwZ2)!请查看新仓库以获取最新模型、数据和代码。 ✨ 简介 近期的“以图思考”(Thinking-with-Images)方法通过在推理过程中迭代放大感兴趣区域来提升细粒度感知能力,但由于反复调用工具和视觉重编码,导致延迟很高。在本工作中,我们提出 ZwZ 模型(4/7/8B),在开源模型中取得了多模态感知基准上的 SOTA 性能. 此外,我们还提出了 ZoomBench, 一个混合标注的基准,包含 845 条 VQA 数据,覆盖六个细粒度感知维度,并配套一个双视角协议,用于量化全局—区域间的“缩放差距”。 ⚙️ 方法 我们提出 区域到图像蒸馏(Region-to-Image Distillation,R2I),它将缩放从推理时工具转变为训练时原语。我们: 放大 到微裁剪区域,并让强教师模型生成高质量 VQA 数据 蒸馏 将这种基于区域的监督通过显式边界框叠加回传到完整图像 使较小的学生模型能够实现 单次前向的细粒度感知 无需使用工具

    匹配字段正文

  7. 蚂蚁 inclusionAI:GitHub 新仓库

    蚂蚁 inclusionAI 开源 2B 视觉取证模型 DefakerOne2

    蚂蚁集团 GuangJian 团队在 GitHub 开源 DefakerOne2,一个基于 Qwen3.5-2B 多模态骨干的 2B 参数统一视觉取证模型,覆盖 AI 生成内容、DeepFake 人脸、文档篡改、自然图像篡改、人脸与证件防伪以及 AI 生成视频检测。模型在约 5000 万样本上训练,采用 LoRA 到全参数再到 LoRA 的三阶段 Tide-Style Tuning,并用基于熵的测试时路由在视频与帧两条通路间选择。团队称其在 53 项检测基准中 40 项达到 SOTA、14 项定位基准中 11 项达到 SOTA,权重与 RRVBench 基准已发布于 ModelScope。

    GitHub

    个三阶段调度方案,其中可训练参数预算如潮汐般涨落——LoRA → 全参数 → LoRA——从而在缓解灾难性遗忘的同时,协调计算效率、泛化能力与难样本拟合。 模态协同。 联合视频/帧训练,加上基于熵的测试时自适应:在推理时把每个样本路由到携带更强取证证据的模态,无需额外训练,也没有学习得到的路由模块。 异常放大 + 校准循环。 一个基于 DINOMAC 的辅助编码器用于细粒度线索,配合全局判断条件化的像素阈值,使单一模型同时产生图像/视频级判定和像素级定位掩码。 在以下基准上评估: 53 项检测基准 以及 14 项定位基准,DefakerOne2 在以下方面达到最先进水平: 40/53 以及 11/14 分别,并在 在全部八个取证领域均排名第一 ——即使在该领域专家自己的领域内,也从未被领域专家超越。 亮点 DefakerOne(V1) DefakerOne2(V2) 图像域平均 80.4 90.9 视频域平均 57.6 95.7 物理伪造(图像) 50.7 87.2 物理伪造(视频) 50.7 95.8 ManipulatedBench(零样本 bACC) 48.6 71.7 RRVB

    匹配字段正文

星期三

  1. The New Stack

    AI 智能体早已下线,它的访问密钥为何还活着?

    OWASP 将非人类身份的不当下线列为 2025 年 Top 10 风险之首,而 AWS IAM 用户访问密钥不会自动过期,被遗忘的密钥会一直有效直到有人手动禁用或删除。文章给出三步治理方案:用 CloudQuery 查询找出 90 天以上未使用且仍激活的密钥,用 OPA 策略在 Terraform/OpenTofu 计划阶段拦截长期凭证创建,并为每个密钥设定有限生命周期。

    un-all 的模块映射。没有变更的计划可以省略 resource changes,因此空计划被视为有效,而无法识别的形态会被拒绝而不是静默允许;只将其附加到模板会生成这些格式的项目上,因为 Pulumi、CloudFormation 和 Kubernetes 部署都会被拒绝。替换包含 create 操作,因此会被捕获。资源列表只是一个示例,该策略无法看到硬编码的机密或在 Terraform 之外生成的密钥。 allow 规则很重要:有了它,任何未被拒绝的内容都无需人工批准即可继续;没有它,一个不返回任何内容的策略会默认为待定,每次部署都要等待一个人。使用完整的 env zero 输入包装器进行测试,而不是裸的 terraform show -json 输出,覆盖密钥创建、仅角色计划、替换、run-all、缺失计划数据和销毁。ENV0 PRINT POLICY INPUT=true 会记录确切的输入;ENV0 OPA VERSION 固定 OPA 版本。该策略在 env zero 的默认 OPA(0.46.1)和 1.x 上运行,这就是它使用 future.keywords 导入而不是

    匹配字段正文

  2. 9to5Mac

    Amazon 发布五款 Alexa 新设备,含 16 英寸 Echo Show

    Amazon 发布五款 Alexa 设备:Echo Dot 售价 $99.99,内置智能家居 hub 与 eero Wi-Fi 扩展器;Echo Studio 带 Home Camera 售价 $249.99;Echo Time 智能床头钟售价 $199.99;Alexa Photo Frame 售价 $199.99;Echo Show 16 预售价 $499.99,Nanomatte 屏版本 $569.99,今年晚些时候发货。

    View 一样,有通过类似 iMac 的支架放在台面上或安装在墙上的选项。 全新的 Echo Show 16 是我们迄今最先进的显示屏,性能提升 20%,让交互感觉更快速。16 英寸高清屏幕薄了近 40%,观看面积多 10%,新的 Nanomatte 选项可将眩光减少 90% 以上,同时保持细节和色彩极其锐利。屏幕样式可将其转变为你的家最需要的任何东西——带颜色编码日历、家务和膳食计划的家庭组织者;数码相框;或配备新 Alexa Home Map 的智能家居仪表盘,显示每盏灯、门锁、恒温器和摄像头在家中的确切位置。此外,它还内置完整的 Fire TV 体验。Echo Show 16 拥有我们在 Echo Show 上用过的最好的摄像头,具有最宽的视野、让每个人都保持在画面中的自动取景,以及首次加入的夜视功能,让你无论白天还是夜晚都能通过 Live View 查看。 Echo Show 16 今日起接受预订,售价 $499.99,纳米磨砂屏版本售价 $569.99。上市时间尚未确认,公司仅表示将于“今年晚些时候”开始发货。 iPhone Duo 保护壳 Beats 编织 USB-C 线缆

    匹配字段正文

  3. Pydantic AI 官方文章精选

    Pydantic 用 5,276 次运行对比 code mode 与工具调用

    Pydantic 的 Michael Pfaffenberger 用 5 个小型 Pydantic AI 应用、8 个模型做了 5,276 次评分运行,对比 code mode 与直接工具调用。长任务上 code mode 平均成本降 58%、耗时降 51%、成功率提高 16 个百分点;但 5 条目的短任务在 5 个任务中有 3 个反而贵了 21% 到 38%。作者认为模型写循环比充当循环更擅长,差距随任务变长而扩大。

    Michael Pfaffenberger avatar

    ode mode 能削减你的 agent 账单 Michael Pfaffenberger mpfaffenberger 21 分钟前 2026/10/28 作为 Markdown 现在和我交谈的每个人对 code mode 都有自己的看法。我的看法则是由 Prime Intellect 的 Prime Agent点燃的,这是一个围绕持久化 REPL 构建的编码工具框架,此外还有 Alex Zhang 的 推测性程序化工具调用,它(除其他功能外)能在模型仍在流式输出代码时运行工具。 Cloudflare 就有一个。 Anthropic 也有一个。我们自己也有过几个,从 MCP 代码执行 到 Pydantic Monty编码智能体也在朝同一方向演进: OpenCode 2 现在默认通过 Code Mode 发送 MCP 工具,而 Pi 则自带一个 codemode 工具。常见的宣传话术大致是这样的:别再让模型一次调用一个工具,而是让它写一个小程序来调用这些工具,这样一切都会更便宜、更快、更好。 我信这一点。但我见过的几乎每个数字都来自拥有数百个工具或庞大负载的智能体,而现实中的许多智能体

    匹配字段正文

  4. Hugging Face精选

    NVIDIA 发布 Nemotron 3.5 Transcribe 与 Granary v2 数据管线

    NVIDIA 在 Hugging Face 和 ModelScope 上发布开放权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答整合进同一个 checkpoint,支持 40 种语言转写、31 种语言与英文互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。该模型在 Hugging Face Open ASR Leaderboard 英语榜的开放权重模型中排名第一,平均 WER 为 5.33%,在 Artificial Analysis 上以约 4B 激活参数取得 2.8% AA-WER。同时发布的 Granary v2 覆盖 48 种语言、463,062 小时语音数据,配套 NeMo Speech 微调配方在医疗案例中把留出说话人的 WER 从 22.44% 降到 12.17%。

    tron 3.5 Transcribe 以 2.8% 的 AA-WER 在开放权重模型中并列第一,其激活参数约为 4B,而与之并列的模型为 24B。在 AA-AgentTalk 上——这个占 AA-WER 指数 50% 的留出语音智能体语音集——Transcribe 的 WER 得分为 1.8%,而次优开放权重模型为 2.3%。Transcribe 将其语音编码器与混合 Mamba–Transformer 专家混合语言模型配对,因此其 30B 参数中每个 token 仅有约 4B 处于激活状态。这使其位于 Artificial Analysis 的开放权重准确率与激活参数帕累托前沿上。在 AA 的全模型图表中,它排名领先于若干广泛使用的专有语音 API。 图 2. 以约六分之一的激活参数取得领先的 AA 准确率:Nemotron 3.5 Transcribe 以约 4B 激活参数实现 2.80% 的 AA-WER。 跨语言与重叠语音的说话人归属。Sortformer 说话人线索与声学特征一同到达语言模型,因此 Transcribe 可以在生成过程中标记每个话轮,而不必仅依赖后续步骤将说

    匹配字段正文

星期四

  1. 少数派

    少数派编辑部新玩意:酷态科电能卡、HomePod mini 2、Sonos Beam Ultra 与谷言预制菜

    少数派编辑部第 254 期《新玩意》分享了四件近期购入或送测的产品。HomePod mini 2 芯片从 S5 升级到 S10,Wi-Fi 升至 Wi-Fi 6,但日常听感与上代差距极小,27.2 系统下 AirPlay 延迟大幅改善。Sonos Beam Ultra 单机实现 7.1.2 杜比全景声,Sonos 27 系统提供原生云端 MCP 服务,可让常用 AI 直接控制音箱播放。

    规格从前一代的 802.11n (Wi-Fi 4) 升级至 802.11ax,也就是 Wi-Fi 6,蓝牙升级到了 Bluetooth 6。 但在体验方面,HomePod mini 2 的提升其实不算明显。从最核心的音频串流能力来说,即使是按照未压缩的 24-bit / 48 KHz 双声道音频来计算,也仅需要约几 Mbps 的吞吐能力,实际使用 ALAC 编码之后的需求通常会更低。因此这一代 HomePod mini 2 在无线连接规格方面的升级,我认为可以算是一次常规的硬件迭代,对日常体验而言不会产生明显影响。 根据官网给出的信息来看,HomePod mini 2 采用的依然是全频驱动单元 + 双振动抵消无源辐射器,内部扬声器架构应该没有变化,关乎于计算音频、语音处理的 S10 芯片就成了影响听感的重要因素。从我的实际听感来说,我认为两代 HomePod mini 的差距极其接近,HomePod mini 2 的低音下探会更足,人声的包裹感会略好一些,日常听歌几乎不会感受到区别,比较可惜的一点是这一代 HomePod mini 与上一代一样仍旧不支持空间音频。 比较核心的变化是将设

    匹配字段正文

  2. MediaNama

    Meesho 称 AI 智能体让一名工程师承担三人团队工作,服务器成本升至 NMV 的 2.3%

    Meesho 在 2026-27 财年第二季度财报电话会上表示,AI 智能体已成为其默认的软件开发方式,一名工程师带领一组智能体即可承担过去三人小组的工作,65% 的小组由单个工程师驱动。公司称 2026 年 3 月至 9 月内部生产力评分提升 171%,代码评审通过时间下降 41%,模型进入线上测试的时间从 17 天缩短到 3 天。同时 AI 也推高成本,GPU 规模增加 150%,服务器成本占净商品价值(NMV)的比例从 1.9% 升至 2.3%,公司计划将部分工作流迁移到更便宜或开放权重模型。Meesho 还明确不会在购物车环节加收平台费,尽管每单约亏损 2.4 卢比。

    查的变更数量增加了3倍。” AI数据科学研究员:“将模型投入线上测试的时间从17天缩短至3天。” AI安全分析师:“威胁检测时间在10分钟以内。” “以我们的内部生产力评分衡量,工程产出在2026年3月至9月间增长了171%,”信中说。“功能现在几天内就能上线,而不是两到三周。” Meesho预计这将减缓其成本增长。“随着单工程师小组成为标准,智能体承担更多编码、支持和运营工作,我们预计产品迭代速度将持续提升,同时成本增长随时间放缓,”信中说。信中未说明这将如何影响招聘。 8. 购物者的消费正超越必需品 Meesho Mall:Meesho品牌产品专区的销售额增长81%,涵盖约1,800个品牌。从必需品起步的客户“也在购买面部精华、防晒霜、护发素和面部滚轮,”信中说。 创作者视频:由创作者产品视频驱动的销售额增长160%。客户“观看他们信任的人使用产品,然后购买,”信中说。 另请阅读: Meesho季度亏损收窄68%至1.325亿卢比,营收增长34% Meesho将向其支付业务部门投资4亿卢比,并设立贷款部门 [googlesitekit-end-of-content] WP QUAD

    匹配字段正文

  3. Factory 研究 / 产品精选

    Factory 发布 Droid 1.0 智能体框架,默认启用程序化工具调用

    Factory 发布 Droid 1.0,这是其智能体框架迄今最大的一次更新,默认启用程序化工具调用(PTC),让模型写 JavaScript 脚本在沙箱中一次请求内执行数百次工具调用。在 Terminal-Bench 4 上,搭配 GPT-6.1 Sol 时 Droid 比 Codex 高 3.5 分且成本低 12%,搭配 Claude Opus 5.5 时比 Cursor、OpenCode、Devin、Claude Code 高 3.0 至 7.6 分,成本最多低 24%。Droid 1.0 今日开放 macOS 和 Windows 桌面版与终端 UI,并提供 Droid SDK(@factory/droid-sdk)。

    该模型特性的适配区分开来。跨模型工作能确保最强的改进具有泛化能力,并在启发这些改进的模型之外依然成立。 这就是我们内部 Agent Factory 背后的理念。智能体会研究基准测试中的失败案例,以及用户在实际会话中遇到的摩擦,提出改动建议,并在其影响的每一个模型家族上逐一测试。我们的工程师审查证据,并决定哪些改动上线。 最终成果是市场上最高效、面向企业就绪的编码智能体,针对每一种前沿模型进行了调优,无论其权重是开放还是闭源。 本文余下部分将介绍正面对比结果、框架背后的设计原则、我们如何构建内部 Agent Factory,以及带来最大影响的核心改动。 市场上最高效的框架 在相同任务、相同模型下,Droid 的得分更高、成本更低,优于我们测试过的所有其他框架。 图 1 Terminal-Bench 4GPT-6.1 Sol 未展示 Cursor:它无法访问 OpenAI 模型。Opus 5.5 Terminal-Bench 4。使用 GPT-6.1 Sol 时,Droid 的得分比 Codex 高 3.5 分,成本低 12%;比 OpenCode 和 Devin 高 6.6 至 12.6

    匹配字段正文

  4. Replit Blog

    Replit 详解 Agent Habitat 安全架构:如何让智能体在可控边界内工作

    Replit 推出 Agent Habitat,让智能体在公司可控的边界内访问企业知识与系统,并围绕最小权限、故障隔离、生产变更可审计、委派工作可追溯四条原则构建安全治理。其凭证代理(credential broker)在每次请求授权后才从保险库取出凭证并注入,凭证不进入智能体上下文;企业连接器管理支持 SAML SSO、SCIM 和基于角色的权限。Replit 称上周披露的内核漏洞未影响其现有隔离环境,并已集中修补工具、部署防火墙防护。

    Replit’s Architecture Behind Secure Agent Work — cover image

    互联网大量依赖的软件中。AI 智能体正让漏洞的发现变得更快、更容易,而从发现到被利用的时间也在不断缩短。 企业越来越需要智能体既能防御威胁,又能改变工作方式。随着智能体承担更多责任,安全必须与自主性同步扩展。 Palo Alto Networks 首席执行官 Nikesh Arora 最近提出了一个问题 ,面向每一家采用 AI 的公司:“数十亿美元正被投入到编码中,你的编码框架安全吗?”对于安全负责人,他的建议很明确:为智能体部署建立防护栏,并部署第二双眼睛来监控其漂移、合规性和可验证性。 在 Replit,我们多年来一直将安全构建到智能体工作的基础设施中。当这些漏洞上周浮出水面时,正是这一基础使我们能够 快速、有效且大规模地响应。我们现有的隔离防护阻止了所披露内核漏洞被利用。我们更进一步,修补了受影响的工具并集中部署了防火墙防护,减少了开发者原本需要自行完成的修复工作。 我们相信,下一步是进一步自动化安全响应本身,由人员来定义治理该流程的策略、审批和干预点。 作为我们 Self-Driving Company 蓝图的一部分,我们正通过 Replit 的 Agent Habitat 将

    匹配字段正文

  5. Replit Blog

    Replit 发布 ViBench 2.0:面向长周期软件构建的基准测试

    Replit 发布 ViBench 2.0,用于评测 AI 智能体从空项目出发、逐个功能构建完整产品的能力,包含 17 个产品、241 个功能请求和 544 个测试计划。GPT-6.1 Sol 以 65% 的 pass@1 领先,GPT-6 Astra 为 60%,Opus 5.5 为 49%,三者均通过超过 90% 的测试计划。Opus 5.5 平均约 70 分钟完成一次构建,比 Sol 快约 2.5 倍;DeepSeek V4.1 Flash 以约 $2.50 每次构建通过 77% 的测试计划,但没有开源权重模型能通过完整构建。

    ViBench 2.0: A Benchmark for Long-Horizon Software Building — cover image

    ter Zhong Michele Catasta 今天我们发布 ViBench 2.0,这是一个面向长周期软件开发的基准测试。它加入了来自 Fireworks [1]的专项智能指数(SII),Fireworks 是我们在开放权重模型推理与训练方面的合作伙伴。SII 汇集了由从业者构建的基准测试,用于在跨行业的真实工作任务上比较开放、闭源和专项模型。 大多数编码基准测试,例如 DeepSWE [2],在现有代码库中交给智能体一个定义明确的任务。而在 ViBench 2.0 中,智能体从空项目开始,然后以 Uber、GitHub 或 Google Docs 等产品为蓝本,一次构建一个功能,最终打造出完整产品。 ViBench 2.0 包含十七个产品、241 个功能请求和 544 个测试计划。表现最好的模型 GPT-6.1 Sol、GPT-6 Astra 和 Opus 5.5 仅在其 49⁠-⁠65% 的构建中通过了全部测试计划。 我们为何构建 ViBench 2.0 我们以 ViBench 1.0 为蓝本进行建模 [3] 当时Replit用户正在构建的东西,比如协作白板和简历生成器。如今

    匹配字段正文

  6. a16z:News

    a16z 调查 100 位 CISO:AI 如何改写 2027 年安全议程

    a16z 对 100 位千人以上企业 CISO 的调研显示,87% 预计网络安全支出将增加,主要驱动是 AI 带来的威胁与企业自身 AI 部署扩大的攻击面。2027 年最受关注的七项安全举措全部与 AI 相关,SOC 自动化获得最多第一优先级投票,但仅 18% 已把 AI SOC 工具投入生产。45% 计划在 12 个月内为内部 AI 智能体安全新增采购或升级,42% 计划采购攻击性安全能力。

    可跨现有工具工作、对告警进行分诊,并在团队定义的权限范围内采取行动。分析师可以审查结果、改进流程,并选择哪些环节需要审批。团队已经掌握如何执行的调查,此后便可反复进行,而无需有人手动走完每一个步骤。 保障企业内部的 AI 安全 AI 已经融入企业工作之中。92% 的受访者表示至少有限度地在生产环境中使用了员工生成式 AI 工具,83% 表示在生产环境中使用了编码助手或智能体,55% 已在生产环境中部署 MCP 服务器或其他智能体与应用的集成。 这些系统可以访问源代码、检索公司文档,并跨应用执行操作。一家餐饮软件公司的安全负责人提出了许多团队正面临的问题:“你怎么才能真正知道这些智能体在做什么?” 这些担忧是具体的。47% 的受访者将员工向 AI 工具泄露敏感数据列为最大的担忧之一,46% 提到智能体超出其权限或被攻陷。另有 29% 担心提示注入或通过 AI 应用造成的数据泄露。 对许多企业而言,这些问题已经在拖慢部署。63% 的回复表示安全至少在一定程度上减缓了 AI 的采用,包括审查、审批要求以及对特定用途的限制。 安全团队需要知道哪些工具和智能体正在运行、它们归谁所有、它们能访问什

    匹配字段正文

  7. Latent Space精选

    Google DeepMind 发布 Gemini 4 Carbon,登顶 Artificial…

    Google DeepMind 发布 Gemini 4 Carbon,在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,并在 HLE-Diamond、TB-Science 等 9 项评测中的 4 项领先。该模型主打网络安全与长周期任务,宣称在 SEC-bench Pro 上取得 88.2%、ExploitGym 上 54.8%、CWE-bench 上 71.0%,初期仅通过 Fairwind Program 向可信网络安全人员开放。规格上支持 1M token 上下文与 1M 最大输出,输入覆盖文本、图像、视频和语音,输出为文本;Artificial Analysis 列出的标准价格为每百万输入/输出 token 4/20 美元,另有 50% 上线折扣。

    代码上比 BPE 扩展得更好(@tri dao)。 NanoGPT 速通纪录:利用检索增强的 n-gram 提示处理稀有、重复内容,纪录从 39.9 秒降至 6.7 秒(@hermanbrunborg)。 OpenAI 声称对 ETH 的反驳:该主张是一个运行时间为 2^{O(n/√log n)} 的 3-SAT 算法,已在 Lean 中形式化。它用代数方式编码解的数量并重建它(@ZhihuFrontier)。 实用性:除非 n 天文数字般大,否则该算法会退回到指数时间(@beenwrekt)。 解说:Mark Sellke 发布了提纲幻灯片(@MarkSellke)。 小型专用模型:Samaya 对 Nemotron 3.5 Lightning(总计 30B,激活 3B)进行了后期训练,包含两个 SFT 阶段和两个 GRPO 阶段。它在 FrontierFinance 上得分为 58.9%,而 Fable 5.1 为 55.9%,成本为 0.61 美元对 6.89 美元(@maithra raghu)。 检索与记忆: EmbeddingGemma 2:这个开放的多模态嵌入模型有 74

    匹配字段正文

  8. Hugging Face

    AnySpeechRecognizer 与 AnyDecisionModel:面向 Apple 平台的语音与决策开源模型

    AnySpeechRecognizer 在 Apple SpeechAnalyzer API 之上支持切换引擎,可选用 NVIDIA Parakeet TDT 0.6B v3(支持 25 种欧洲语言)、Moondream 后训练的 Parakeet Ultra、英文版 Parakeet Unified,以及阿里 Qwen3-ASR(0.6B/1.7B,覆盖 30 种语言和 22 种中文方言)。这些模型已转为 Core ML 发布在 Hugging Face Hub,Parakeet 转写 1 小时音频约需 20–40 秒,Qwen3-ASR 更慢且需数 GB 内存。包内还新增 Apple 框架没有的说话人分离模块 SpeakerDiarizer,基于 NVIDIA Streaming Sortformer,最多跟踪 4 位说话人。

    级时间戳或置信度。它运行在 GPU 上,比 Parakeet 慢,因此更适合转写文件,而非实时输入。 Hub 上的 Core ML 模型 为了在应用中运行这些模型,我们将它们转换为 Core ML 并发布在 Hub 上: 每个仓库都记录了其源检查点以及每个文件的校验和,该包将其固定到某个固定修订版本。Parakeet 仓库额外提供了一个用于实时输入的 8 秒编码器,可将实时分析时间缩短约三分之一,代价是词错误率略有升高。该仓库还包含转换工作流,其中大部分遵循 FluidInference 的 mobius 脚本,并将每次转换结果与原始模型进行校验。 只有你的应用请求时才会发生下载:每个 Parakeet 约 600 MB,实时编码器另需约 590 MB,Qwen3-ASR 为 0.9 至 2.4 GB,Sortformer 约 250 MB。文件存放在标准的 Hugging Face 缓存中,因此沙盒之外的 Mac 应用可以与 Python 及其他 Hugging Face 工具共享它们。 说话人分离 转写对话时,你往往想知道谁说了什么。这就是说话人分离,而 Apple 的 Speec

    匹配字段正文

  9. Baseten 工程博客

    Baseten 优化 Qwen3-ASR 批量转写,单卡吞吐提升 7 倍

    Baseten 工程团队通过原生音频解码、KV cache FP8 量化和减少主机与设备同步,把 Qwen3-ASR 1.7B 在单张 RTX PRO 6000 上的批量转写吞吐提升 7 倍、延迟降低 6.9 倍。优化后一小时音频的转写成本约为 0.0013 美元,即每音频小时 1/10 美分,词错误率没有明显变化。该优化版本已作为 Baseten Model Library 的默认部署,可通过 OpenAI 兼容的转写客户端调用。

    How Baseten gets 7x throughput on Qwen3-ASR batch transcription

    使我们改用 FlashInfer 内核。FlashInfer FP8 将注意力内核的内存利用率从 50% 提升到 80%。 我们将权重保持在 BF16,因为权重量化在我们的测试集上增加了词错误率(WER)。虽然 FP8 缓存也是有损的,但对准确率的影响极小,因为注意力计算仍保持全精度,且每一层都会从全精度激活重新计算其缓存。✕优化解码器各阶段所选的精度。音频编码器和解码器权重保持 BF16,因为编码器只占 GPU 时间的一小部分,而 FP8 量化权重会影响准确率。KV 缓存是内存流量的最大来源,改为 FP8 后,每步所需字节数减半,可同时运行的序列数翻倍。注意力计算以全精度运行,并在每一层从全精度激活重新计算,因此舍入误差不会累积。 尽量减少主机与设备之间的同步 在负载下,GPU 跟踪显示即使内核接近其硬件极限,步骤之间仍存在空闲。 这些间隙来自 CPU;正常情况下,CPU 在 GPU 仍在工作时准备下一步,但为此,注意力后端需要每个序列的长度,而该长度存储在 GPU 上。将其复制回来迫使 CPU 等待 GPU 完成。因此 CPU 无法提前准备下一步,而 GPU 在它准备时处于空闲状态

    匹配字段正文