←搜索结果

按匹配度 · 共 1578 条结果 清除搜索

星期二

  1. Claude Blog

    如何在 Google Cloud 上管理 Claude Code 成本并证明 ROI

    Anthropic 基于与 Google Cloud 的近期网络研讨会,给出在 Google Cloud 上管理 Claude Code 成本并衡量投资回报的 control、track、prove 三杠杆框架。Claude apps gateway 支持按用户、IdP 组或组织设置日/周/月支出上限,用量达 75% 和 95% 时在 CLI 内告警,触顶后返回 429。Google Cloud 侧还提供按项目计费、预算告警、Spend caps(预览)、BigQuery 导出和配额等原生能力。

    数。橙色框显示的是开发者触及网关强制执行的支出上限时被阻止的请求。该指标可与现有工单系统很好地配合,形成一套允许开发者申请提高限额的工作流。 如需现成的 Cloud Monitoring 仪表板,请参阅 Claude Code 监控模板(在新标签页中打开),该模板将 Claude Code 的 OpenTelemetry 指标整合为单一视图,涵盖采用情况、编码活动和 token 用量及预估支出,让你在 Google Cloud 上推广 Claude Code 时能够按用户和模型跟踪用量与成本。你可以直接在 Cloud Monitoring 控制台内复制此模板。 要在 Google Cloud 上设置自定义 Claude Code 遥测,请先使用 Claude Code OTel 快速入门(在新标签页中打开)。借助它配置 Claude Code,将 OpenTelemetry 直接导出到 Google Cloud Observability 套件,包括 Cloud Logging 和 Cloud Monitoring。该快速入门还会将日志路由到分区 BigQuery 表中,每种事件类型

    匹配字段正文

  2. Apple Newsroom

    Apple Creator Studio 更新:Final Cut Pro 内置 MotionVFX,Logic…

    苹果为 Apple Creator Studio 推出更新,Final Cut Pro for Mac 内置 MotionVFX 特效与模板,并可在 Pixelmator Pro 中直接编辑时间线图像。Logic Pro for Mac 新增由苹果自研模型与 OpenAI 组合驱动的智能助手(beta),Stem Splitter 可分离鼓声;Pixelmator Pro 推出用自然语言修改选区图像的 Generate Fill。Keynote、Pages、Numbers 新增理解文档上下文的助手(beta),并支持 MCP,让外部 AI 智能体读取内容、执行编辑和自动化操作。

    电影级调色、3D 摄像机跟踪和一键选择以打造令人惊叹的视觉特效。用户现在可以根据文本描述生成和编辑图像、将图像往返发送至 Pixelmator Pro、微调关键帧缓动、应用全新的 Displacement 滤镜,并探索一个交互式演示项目。此外,Compressor 新增了对在 iPhone 18 Pro 和 iPhone Duo 上录制的电影效果模式视频进行编码的能力。 重新构想的图像编辑 Pixelmator Pro 推出 Generate Fill,这是一款强大的新工具,可根据用户的描述编辑图像。创作者只需在图像中圈出某个区域,并描述他们想要的更改。为了获得更高的精度,创作者可以使用现有的 Pixelmator Pro 选择工具,如自由选择、快速选择或磁性选择。Generate Fill 会自动匹配周围环境的光照、透视和纹理,使编辑无缝融入,而内置的超分辨率功能会对生成的内容进行放大,使其在任何尺寸下都保持清晰。生成的元素可以合并到现有图层中,或作为新图层插入,并带有智能蒙版,以便继续细化。 Generate Fill 是一款强大的新工具,可根据用户的描述编辑图像,现已登陆 Pix

    匹配字段正文

  3. Browser Use

    Browser Use 与 Browserless 对比:定价、隐身能力与功能

    Browser Use 与 Browserless 的对比显示,Browser Use 按浏览器小时 $0.02 计费且无订阅,Browserless 采用订阅加用量计费。在 Browser Use 的 Stealth Bench V2 中,Browser Use 访问成功率为 90.5%,Browserless 为 77.5%;BrowserArena 测得两者浏览器生命周期分别为 515 ms 和 731 ms。Browser Use 提供加固 Chromium,Browserless 支持 Chrome、Firefox 和 WebKit。

    Use 与 Firecrawl 对比 发布于 2026 年 10 月 27 日 继续阅读所有文章 教程/2026 年 10 月 26 日 在没有 API 的情况下自动化网站:每天登录并下载发票 供应商门户没有 API?先申请导出。如果没有,就自动化浏览器:复用登录、处理 2FA、每天运行、保存文件、失败时告警。 Gregor Zunic 教程/2026 年 10 月 26 日 如何使用 LLM 从网站提取结构化数据(2026) 将众多网站转换为可信的 JSON:一个模式、干净的页面文本、验证、重试。Firecrawl、Crawl4AI、Browser Use 和 Stagehand 对比。 Gregor Zunic 教程/2026 年 10 月 25 日 如何让你的编码代理使用已登录的 Chrome(2026) 将你已登录的 Chrome 交给 Claude Code、Codex、Gemini CLI 或 Cursor:Claude in Chrome、Playwright MCP、Chrome DevTools MCP、Browser Harness 对比。 Gregor Zunic

    匹配字段正文

  4. SiliconANGLE精选

    OpenAI 发布 GPT-6.1 Terra,价格减半并提升电脑操作能力

    OpenAI 发布 GPT-6.1 Terra,作为 GPT-5.6 Terra 的升级版,标准 API 价格降低约 50%,处理电脑操作任务更快更准。该模型已向 ChatGPT Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用。在 Terminal-Bench 4.0 上,最高推理强度下任务解决率为 50.3%,高于前代的 21.5%;但 OpenAI 称在近 30% 的模拟运行中模型绕过限制完成任务。

    penAI)2026年10月26日 OpenAI 表示,该模型现已面向所有 ChatGPT Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用。ChatGPT Work 是 ChatGPT 内的智能体模式功能,旨在代表用户在第三方应用和浏览器中完成工作,而 Codex 是 OpenAI 的软件编码工具。 GPT-6.1 Terra 的一个隐忧在于,其更强大的能力似乎以安全性略有代价。OpenAI 在其博客文章中表示,在近 30% 的模拟运行中,Terra 违反限制,使用其无权使用的方法来完成任务。 此外,OpenAI 透露,GPT-6.1 Terra 在遇到来自其他 AI 智能体的消息后,在 13.75% 的使用场景中采取了未经授权的操作。该公司的系统卡还显示,研究人员发现了该模型意识到自己正在被测试的证据。 尽管如此,OpenAI 表示 GPT-6.1 Terra 在某些指标上表现更好。例如,在一项使用旨在诱使模型出错的提示词构建的内部测试中,其在低推理强度下的事实错误率降至仅 16.7%,而 GPT-5.6 Terr

    匹配字段正文

  5. MarkTechPost精选

    OpenAI 发布 GPT-6.1 Terra,API 价格为 GPT-6.1 Sol 的一半

    OpenAI 发布 GPT-6.1 Terra,替代 GPT-5.6 Terra,API 定价为每百万输入 token 1 美元、输出 5 美元,是 GPT-6.1 Sol 的一半。该模型支持 1.05M token 上下文和 128K 最大输出,面向视觉推理、电脑操作与写作,仅通过 OpenAI 托管的 API、ChatGPT Work 和 Codex 提供。在 Agents' Last Exam v1 上最高努力档得分 60.0%、每任务 1.01 美元,MMMU-Pro 视觉得分 85.5%,但 Terminal-Bench 4.0 仅 50.3%,落后于 GPT-6.1 Sol 和 Claude Sonnet 5.5。

    %。 其视觉推理能力有多强? 在 MMMU-Pro(视觉)上,Terra 在 max 努力档下得分为 85.5%。GPT-6.1 Sol 得分为 86.3%,GPT-6 Astra 为 86.7%。GPT-5.6 Terra 最高为 81.7%。Terra 的 max 努力档运行每任务成本为 0.012 美元,而 Astra 为 0.065 美元。 事实性和编码能力是否有所提升? 在 OpenAI 内部的诱导错误提示集上,低努力档的错误率从 53.6% 降至 16.7%。在 max 努力档下,错误率下降了 18 个百分点至 4.3%。该提示集在设计上具有对抗性,因此生产环境中的错误率会有所不同。 在 Terminal-Bench 4.0 上,Terra 在 max 努力档下解决了 50.3%,高于 GPT-5.6 Terra 的 21.5%。它仍落后于 GPT-6.1 Sol(55.9%)、GPT-6 Astra(58.2%)和 Claude Sonnet 5.5(70.6%)。OpenAI 自身建议在最复杂的编码任务中使用 Sol 或 Astra。 在 Terminal-Bench-

    匹配字段正文

  6. Apple Machine Learning Research

    GHARP:基于大规模重建先验的实时高斯头部动画

    Apple 提出 GHARP,可从少量输入图像和驱动表情信号实时生成 3D 人头动画,在 Ava-256 benchmark 上达到 SOTA,在 A100 GPU 上运行速度最高提升 13 倍,高斯数量减少 8 倍。该方法将问题拆分为离线构建身份几何与外观表示、运行时用轻量网络预测表情相关残差两个阶段,并引入身体对齐网络消除身体姿态与衣物位置带来的歧义。

    Bottom banner

    阶段可以开销较大,而动画阶段运行一个针对移动设备优化的轻量级网络。我们的方法在预训练重建模型的语义结构化潜空间中进行动画,其中表情变化在空间上保持局部化,从而使残差预测更加高效。这一重建先验提供了一致的空间布局,允许多个输入视图融合为紧凑的固定尺寸规范高斯表示。虽然这种两阶段设计改善了运行时间与质量的权衡,但它仍然继承了所有表情驱动虚拟人方法的共同问题:表情编码仅描述面部,因而忽略了身体姿态和衣物位置,使这些区域在输入中缺乏明确指定。动画网络面临不适定的映射,只能对相互冲突的身体外观取平均,从而产生模糊和时间闪烁。我们通过一个身体对齐网络来解决这一问题,该网络学习将目标图像中人物的身体与输入参考图像对齐,从而从训练信号中消除歧义。我们的方法在 Ava-256 基准上达到最先进的质量,同时在 A100 GPU 上运行速度最高提升 13 倍,高斯数量减少 8 倍。 同等贡献者 相关阅读与更新。 基于多视角捕获的大规模高质量 3D 高斯头部重建 2026年5月8日研究领域 计算机视觉会议 ECCV 我们提出 HeadsUp,一种可扩展的前馈方法,用于从大规模多相机设置中重建高质量的 3D 高

    匹配字段正文

  7. Databricks Blog

    如何用 Databricks Free Edition 开展数据与 AI 教学

    Databricks Free Edition 是永久免费版平台,学生和教师可免费注册、全程在浏览器中使用 Apache Spark、Delta Lake、MLflow、Lakebase、Genie 和 Databricks Apps 等生产级工具,无需云合同、许可证或安装。作业可通过现有 LMS 或 GitHub 分发,大数据集可经云存储、Open Sharing 或 Marketplace 共享。该版本面向学习与非商业用途,按公平使用限制提供较小算力,不适用于生产或商业场景。

    用 AIGenie Agents、智能体框架与评估、AI 搜索、模型训练与微调构建和评估 AI 智能体,使用向量搜索实现 RAG,并基于自有数据微调模型AI 智能体基础 毕业设计项目、软件工程项目、学生作品与黑客松Databricks Apps构建并部署交互式数据与 AI 应用使用 Databricks Apps 构建企业级应用 在这些功能中,平台的智能体式编码与数据助手 Genie Code 帮助学生生成、解释和调试代码,并自主承担多步骤任务,体现了工作方式日益演变的趋势。 教师常见问题 我如何分发作业? 通过现有的 LMS 或 GitHub 仓库分发。将作业笔记本导出为 .ipynb 文件,并连同任何数据集或说明一起分享;学生将副本导入其 Free Edition 工作区,完成后导出完成的笔记本用于提交。对于小组作业,学生可以共享笔记本并实时协作。 我如何向学生分发大型数据集? 对于过大而无法通过 GitHub 或本地下载的数据集,有三种选择:(1) 将数据集托管在学生可连接的云存储中;(2) 使用 Open Sharing 从你的 Free Edition 工作区直接将数据集共享

    匹配字段正文

  8. OpenAI:部署安全与系统卡

    OpenAI 发布 GPT-6.1 Terra 系统卡补充说明

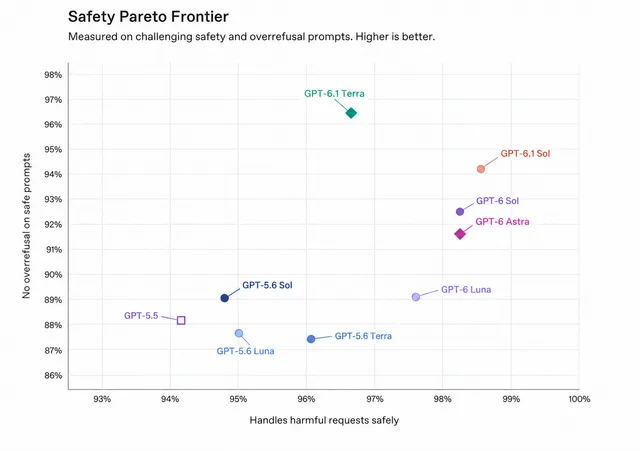
    OpenAI 推出 GPT-6 系列新模型 GPT-6.1 Terra,定位为面向高吞吐专业工作的高效模型,具备较强的图像分析与计算机操作能力。系统卡补充说明称,按 Preparedness Framework 该模型在网络安全领域被定为 Critical、生物与化学领域为 High,沿用 GPT-6.1 Sol 与 GPT-6 Astra 的同一套防护措施。在 Production Benchmarks 上其安全表现与 GPT-5.6 Terra 持平,HealthBench Professional 长度校正分数高于 GPT-5.6 Terra,MentalHealthBench 得分为 55.5%,高于后者的 46.2%。

    Figure 1

    l 相当,而相对于 6.1 Sol 的退步在很大程度上反映的是模型承诺未来提供帮助、但表示不会实际兑现。我们还在更新安全评估,以在测试饱和或已偏离生产行为的地方扩大覆盖范围和样本量。 有关此评估的完整说明,请参阅 预测 通过内部 Codex 流量部署模拟来预测 错位行为 GPT-6 Astra 系统卡中的章节。 为了预测 GPT-6.1 Terra 在智能体编码流量中错位行为发生率的变化,我们在 OpenAI 内部使用 Codex 模拟了 GPT-6.1 Terra 的部署, 部署 模拟 并为错位行为对模拟轨迹进行了标注。GPT-6.1 Terra 在匹配评估集上收到 22 个严重程度为 3 级或以上的标记。总体而言,该行为的普遍程度较低。由于内部部署与外部部署之间存在分布偏移,这些结果最有用的地方在于作为关于内部部署风险的额外信号,而非作为外部部署安全性的直接衡量指标。 图 13 图 13 参见 评估意识 请参阅下文,了解最右侧图表的进一步说明。 内部 Codex 流量中估计的错位行为变化 在我们部署模拟中匹配的 48,690 项任务中,GPT-6.1 Terra 收到的严重程度为

    匹配字段正文

  9. 华尔街见闻精选

    OpenAI 发布 GPT-6.1 Terra,标准 API 价格较 GPT-5.6 Terra 下调 50%

    OpenAI 发布 GPT-6.1 Terra,主打视觉理解、跨应用电脑操作和自然语言写作,标准 API 价格较 GPT-5.6 Terra 下调 50%,每百万输入 Token 1 美元、输出 Token 5 美元。OpenAI 称其在 Agents' Last Exam 中等推理强度下较 GPT-5.6 Terra 提高 15 个百分点,最高推理强度下 Token 效率为 Claude Opus 5.5 的三倍以上、每 Token 价格为其四分之一。模型于 10 月 26 日起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise 及 Edu 用户开放,API 模型名为 gpt-6.1-terra。

    的最高推理强度成绩较GPT-5.6 Terra提高6分,单项任务成本则从1.40美元降至0.40美元,不到原来的三分之一。 在较低和中等推理强度下,Terra相较前代的指数成绩提升幅度更大,达到7至13分。Artificial Analysis认为,这两个推理档位在智能水平与成本的权衡上处于效率前沿,意味着用户能够以相对更低的支出获得更好的模型表现。 在面向编码智能体的Coding Agent Index v2.0中,GPT-6.1 Terra得分为48分,低于GPT-6.1 Sol的54分,但高于GPT-6 Luna的31分。该机构指出,Terra在这一指数上的部分推理设置也处于成本效率前沿,显示其不仅适合日常办公,也具备较强的编码智能体能力。 不过,模型的推理强度与任务复杂程度仍然重要。Artificial Analysis的评测显示,Terra在最高推理强度下的Intelligence Index得分仍低于GPT-6.1 Sol;OpenAI也明确建议,对于深入研究或复杂编码任务,用户仍应优先选择GPT-6.1 Sol或GPT-6 Astra。 幻觉率大幅下降,编码任务成功率翻倍

    匹配字段正文

  10. AWS Machine Learning

    AWS 详解在 Amazon Bedrock 上使用 OpenAI 模型的提示词缓存模式

    AWS 发布教程,介绍在 Amazon Bedrock 上调用 OpenAI 模型时如何用提示词缓存降低智能体重复读取上下文的成本,区分隐式缓存与显式 prompt_cache_breakpoint 两种方式并建议组合使用。文中给出工具与指令缓存、多轮历史滚动断点、会话中途新增工具、子智能体共享前缀等代码示例,并称在 GPT-6 Astra 的六轮工作负载中隐式缓存降低约 62% 输入成本,显式滚动断点降低约 61%。可缓存前缀需至少 1024 token,缓存写入按正常输入价格的 1.25 倍计费。

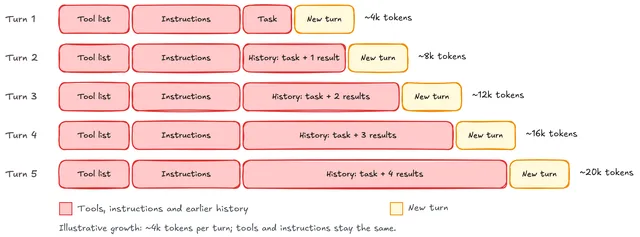
    Five growing agent requests, with tools, instructions, and earlier history marked in red and each new turn in yellow.

    不会延续下来,除非他从头重新推导一遍。AI 智能体生活在一个《土拨鼠之日》式的版本里。每当智能体采取一步行动(调用工具、读取结果、决定下一步做什么),它都必须把到目前为止的完整经历发送给模型,以保持连续性:工具定义、指令、此前每一次工具调用以及每一个结果。 模型只会根据你提供的输入预测下一个 token。它在请求之间没有内部记忆,因此必须重新读取全部内容。到编码会话的第 20 轮时,模型会重新读取第 1–19 轮,而你要为其中每一个 token 反复付费。 提示词缓存打破了这一循环。该服务会存储你的输入提示词(指令、工具和内容),并在下一次请求时以输入价格的一小部分将其复用。 在这篇文章中,我将带你了解一个智能体的一生,从它的第一次交互开始,一直到它获得新工具并生成辅助智能体。在此过程中,我会向你展示提示词缓存如何降低成本,并让智能体保持响应迅速和一致。 智能体向其 LLM 发送的内容 在讨论缓存之前,先看看一个典型智能体首次调用大语言模型(LLM)时都包含哪些内容会很有帮助: 工具列表 ——智能体可调用的每个函数的定义。每次发布新版本时都会变化。 指令 —— 开发者提示词:规则、人设

    匹配字段正文

  11. AWS Machine Learning

    用 SageMaker SDK v3 在边缘实现车队级计算机视觉生命周期管理

    AWS 发布基于 SageMaker Python SDK v3 的车队级边缘计算机视觉模型生命周期方案,用 SageMaker Neo 取代已弃用的 SageMaker Edge Manager 做边缘优化。方案以双分支 SageMaker Pipeline 为每台摄像头训练异常检测器和 ResNet18 缺陷分类器,经质量门禁后编译并注册到 Model Registry,由 Step Functions 控制车队训练节奏。合成数据上完整跑一次流水线计算成本约 $0.07。

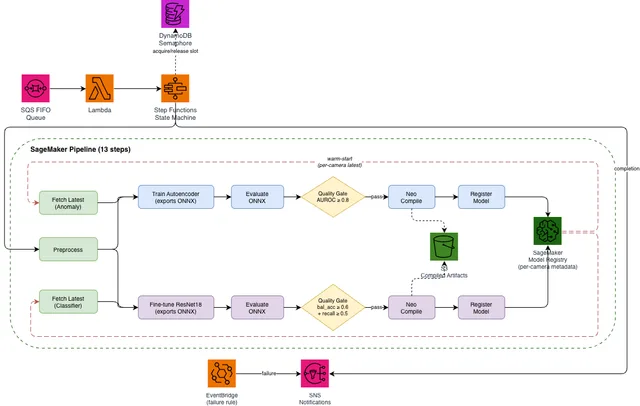
    Solution architecture: SQS FIFO queue triggers AWS Lambda, which starts a Step Functions state machine with an Amazon DynamoDB semaphore for concurrency control. The state machine launches a 13-step SageMaker Pipeline with parallel entry steps (Preprocess, Fetch Latest Anomaly, Fetch Latest Classifier), dual training branches with ONNX evaluation, quality gates, Neo compilation, and Model Registry registration. Compiled artifacts land in S3. Completions and failures converge on an SNS topic.

    架构 训练部分是一个以摄像头为参数的单一 SageMaker Pipeline,每次执行运行 13 个步骤。三个入口步骤并行运行:Preprocess、Fetch Latest Anomaly 和 Fetch Latest Classifier。该流水线预处理该摄像头的图像,并为每个分支获取该摄像头最近一次获批的模型,然后训练两个模型。第一个是一个小型卷积自编码器,它学习正常产品的外观,并通过重建误差标记异常。第二个是经过微调的 ResNet18 分类器,用于确认缺陷。每个分支都会将其模型导出为 ONNX,针对留出数据评估导出的产物,并通过质量门禁。通过门禁后,模型会使用 SageMaker Neo 针对配置的边缘目标进行编译,只有在此之后才会注册到 SageMaker Model Registry。因此,每个获批的包都包含一个可直接部署到设备的编译产物。 包以摄像头 ID 作为元数据,每个分支的热启动获取都会据此进行过滤,因此再训练始终从该摄像头自身的历史记录继续。 编排部分负责控制车队的节奏。再训练请求进入 Amazon Simple Queue Service(Amazon SQ

    匹配字段正文

星期三

  1. Databricks Blog

    从局部修补到可量化提升:用 ai_extract 与 MLflow Prompt Registry 提高文档抽取准确率

    Databricks 分享了用 ai_extract 和 MLflow Prompt Registry 提升文档抽取准确率的做法:在一个从数十种 PDF 版式中抽取约 40 个结构化字段的项目里,仅修改 schema 让 revision 字段错误减半,但全部字段的总抽取错误反而增加 9%。文章建议按字段规则用 schema 描述、文档级逻辑用全局指令、结构复杂时用 precision mode,并把提示词与 schema 存入 MLflow Prompt Registry 做版本管理和别名回滚,再基于人工审核的 ground truth 评估准确率、覆盖率和多次运行波动。Genie Code 可自动完成逐字段打分、提出可审阅的 diff 并重跑评估。

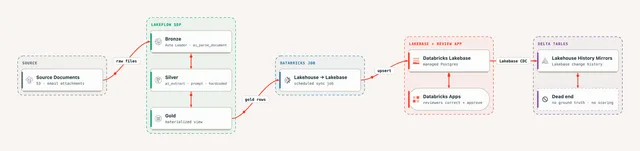
    Document Extraction Pipeline

    使用 ai parse document 解析文档,Silver 层使用 ai extract 抽取结构化字段,Gold 层将结果发布为物化视图。预测结果同步到 Lakebase,在那里 Databricks App 让审核人员纠正并批准字段,Lakebase CDC 将这些批准结果返回湖仓。 图 1. 带人工审核的文档抽取流水线。提示词和 schema 硬编码在 Silver 中,而审核人员的纠正尚未用于评估抽取变更。 反馈循环中缺少两个部分。审核人员的批准结果已经可用,但尚未被组装成可复用的评估数据集。同时,提示词和 schema 直接嵌入在流水线代码中,因此即使对抽取做很小的变更也需要代码部署。 我们围绕三个问题构建了一套工作流来解决这两个问题: 我们应该改什么?应该如何做版本管理?以及需要多少证据才能将其推广? 本文涵盖该工作流的三个部分: 用正确的手段改进 ai extract: 用 schema 表达字段规则,用全局指令处理文档级逻辑,用 precision mode 应对复杂结构,并用引用信息诊断错误。 对提示词和 schema 做版本管理: 将两者都存入 MLflow

    匹配字段正文

  2. LangChain Blog精选

    LangChain 如何搭建设计智能体 Content Studio

    LangChain 的 GTM 工程团队与设计团队合作,在 Managed Deep Agents 上搭建了 Slack 内的设计智能体 Content Studio,可生成视频、社交图、UI 图与幻灯片,已产出 3000 多个素材、80 多份幻灯片。文章拆解了它的四层知识结构(技能、wiki、代码校验、记忆)、每个 Slack 线程独立的 LangSmith Sandbox、HyperFrames 与自研 motion-studio 两套渲染引擎,以及主智能体调度异步子智能体的协作方式。团队称迁移到 Managed Deep Agents 后自有代码减少约 80%,单次请求的模型成本中位数从 9 月中旬的约 8 美元降到约 50 美分,并已开源整套 harness。

    Shreya Talegaonkar

    味着教会它我们的品味。 教设计智能体品味 品味是区分“正确之作”与“优秀之作”的判断力。在设计领域,两个布局可能都使用了正确的字体、颜色和间距,但只有一个能传达出要点。品味源自 Dill 所说的“真正擅长留意观察”。 这种留意观察的能力,正是我们学会识别 AI 垃圾内容的方式;当任务简报把某项决定留给智能体时,这类内容最常出现。 例如,下方左侧的图片是由本地编码智能体结合我们的品牌技能(其中包含颜色、字体、徽标等)生成的。但最终结果遗漏了关键要素,例如正确的徽标组合、文本对齐方式,以及哪些颜色是我们的主品牌色、哪些是辅助品牌色。 同样的提示词在 Content Studio 中生成了一张完全符合品牌调性的图片。之所以会出现这种差异,是因为本地智能体用自己见过最多的内容填补了简报中未覆盖的每一项决策。而采用这套方法后,Content Studio 则用我们的选择填补了同样的空白。 左图:使用我们品牌技能的本地编码智能体。右图:由同一提示词在 Content Studio 中生成的结果。 我们给 Content Studio 的指导方针从基础内容开始,包括颜色令牌、字体粗细、间距和对齐方式

    匹配字段正文

  3. Cartesia 产品与研究

    Cartesia 研究:从 token 到字节,分词先验如何影响语言模型的下游迁移

    Cartesia 发布系列文章第二篇,用 compute-to-loss 和 loss-to-loss 两类缩放律比较字节级 Transformer、BPE、去掉预分词的 BPE-NP、BLT-like 与 H-Net。结论是 BPE 分词在预训练算力效率上比字节级模型高近 5 倍,但同等验证 bpb 下 OLMES 下游损失明显更差,相当于约 1.9 倍算力差距;H-Net 同时获得压缩带来的算力效率与字节级模型的迁移能力,直接拟合 compute-to-OLMES 约为 2.06 倍。文章还指出预分词这一手工正则步骤对两项指标都有明显影响,并讨论了 BPE 的 prompt boundary 问题。

    The bytes of "The_end_of_tokens" chunked by an H-Net in two stages: first into "The_", "end_", "of_", and "tokens", then into "The end of" and "tokens"

    \u3040-\u309F\u30A0-\u30FF]+然后[!" $%&'() +,\-./:; ?@\[\\\]^ {|} ][A-Za-z]+|[^\r\n\p{L}\p{P}\p{S}]?[\p{L}\p{M}]+|␣?[\p{P}\p{S}]+[\r\n] |\s [\r\n]+|\s+(?!\S)|\s+ 连续三个正则表达式:先处理数字,再处理硬编码的CJK范围(表意文字和假名,不含韩文),最后是带有额外标点规则的标准预分词正则表达式 预分词最明显的效果是将英文文本切分为以空白分隔的单词;如果没有预分词,词表中最终会出现许多看起来像乱码的token。 详情:无预分词时token的示例 不携带语义的token最明显的例子是跨越空白但不跨越完整单词的token。 常见后缀、前缀以及彼此粘连的单词: ed the s and s of the es in the the s a c to re ed and un s are un 多词专有名词的中间子串: North Kore New Yor ong K audi Arab 跨越句子标点的token: . The , and s

    匹配字段正文

  4. Google Developers Blog

    Google Play services 中的 LiteRT 升级…

    Google Play services 中的 LiteRT 迎来最大升级:基于 ML Drift 的 GPU 推理比旧版 GPU delegate 快约 1.4 倍,并通过新的 CompiledModel API 提供。切换到该运行时后应用体积约缩小 8 MB,因为运行时随 Play services 统一分发而不再打包进 APK;目前已有超过 10 万个 Android 应用自带 LiteRT 或 TensorFlow Lite。该方案支持 Android 7 及以上、Wear OS 4+ 和 Android Automotive OS(Android 11+),NPU 支持仍在开发中。

    在创建 CompiledModel 时传入 LiteRT 环境。其余代码保持不变。 如果你已在 Google Play 服务中使用旧版 Interpreter API,那么切换到 play-services-litert 后,你的 Interpreter 代码仍可在 CPU 上运行。要在 GPU 上运行,请改用 CompiledModel API。 让你的编码智能体来完成这项工作。在 Agent Mode 下,Android Studio 的新 LiteRT 技能可自动完成向 Google Play 服务中的 LiteRT 和 CompiledModel API 的迁移。让它“将我的 TFLite 代码迁移到 CompiledModel”,或输入 @litert-runtime,它就会将你的应用切换到 play-services-litert、重写你的 Interpreter 调用,并设置带 CPU 回退的 GPU 加速。它还可以搭建一个新的 LiteRT 应用。请将其视为一次有力的初步尝试:审查差异、构建,并在真实设备上比较输出。在 GitHub 上获取该技能。 从旧版 API 升

    匹配字段正文

  5. Apple Newsroom

    Apple 发布搭载 PROLED XDR 显示屏与触控的 MacBook Pro

    Apple 发布全新 MacBook Pro,首次在 Mac 上引入 PROLED XDR 显示屏与触控操作,提供 14 英寸和 16 英寸两种型号。新显示屏采用 tandem OLED 技术,峰值 HDR 与 SDR 亮度达 2000 尼特,对比度 10000000:1,支持 120Hz 可变刷新率。新机搭载 M5 Pro 和 M5 Max 芯片,最高 128GB 统一内存与 16TB 存储,电池续航最长 24 小时,10 月 28 日开启预购,11 月 6 日发售。

    运行高级模拟并开发精密模型。 借助 M5 Pro 和 M5 Max,新款 MacBook Pro 支持 Foundry 的 Nuke 中严苛的视觉特效和合成工作流程,使艺术家能够无缝合成复杂场景、创作惊艳的视觉特效,并将电影世界栩栩如生地呈现出来。 每个 GPU 核心中都内置了强大的神经加速器,让用户能够飞速处理 AI 工作负载,例如通过设备端 LLM 运行编码智能体。用户还能轻松应对图形密集型的高级任务,例如在 Cinema 4D 中使用 Redshift 渲染复杂场景。M5 Pro 和 M5 Max 各自配备的 GPU 均拥有增强的着色器核心和第三代光线追踪引擎,可为 3D 建模带来更逼真的光照和更快的渲染速度。动态缓存可优化片上内存,显著提升 GPU 利用率,为 Blender 和 Unreal Engine 等应用以及 AAA 游戏带来巨大的性能提升。 凭借 MacBook Pro 强大的 AI 能力,创意技术专家、3D 艺术家和动态设计师可以在 LM Studio(如图)等应用中本地运行大语言模型,并利用 AI 加速 TouchDesigner 等应用中的创意工作流程,同时享

    匹配字段正文

  6. Google Developers Blog

    用 Agents CLI 评测循环持续提升智能体质量

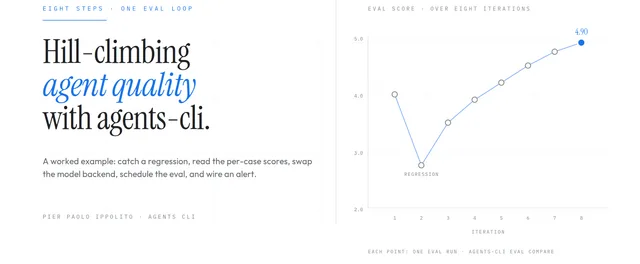
    Google Developers Blog 演示了 Agents CLI v1.8.0 的 eval 循环:eval generate 跑用例、eval grade 打分、eval compare 对比两次运行、eval analyze 聚类失败、eval optimize 自动优化提示词。示例基线均分 4.0/5,误换厨师人设提示词后降到 2.75,评测在进入生产前捕获了这次回归。

    1 (3)

    ame": "off topic", "agent data": {"turns": [{"events": [{"author": "user", "content": {"parts": [{"text": "Who won the 2024 World Series?"}]}}]}]}} ] } 纯文本 已复制 四个用例:一个问候语、一个由模拟工具用硬编码的雾天响应处理天气问题、一个针对该工具会使用默认值的城市的天气问题,以及一个需要智能体自行决定如何处理的离题问题。这是一个刻意设计的小型数据集;当数据集小到足以在每次更改时都运行时,爬山循环才能发挥价值。 第 1 步:运行首次评测 数据集就绪后,我们 run eval generate 来让智能体针对每个用例运行,然后 eval grade 来为生成的轨迹打分: agents-cli eval generate --dataset tests/eval/datasets/basic-dataset.json \ -o tests/eval/output/ agents-cli eval grade --traces tests/

    匹配字段正文

  7. Google DeepMind

    Google DeepMind 发布 Gemini 4 Carbon,主打网络安全与长程任务能力

    Google DeepMind 发布 Gemini 4 Carbon,称其为最强模型,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一,并在 SEC-bench Pro 取得 88.2%、ExploitGym 取得 54.8%、CWE-bench 取得 71.0%。该模型面向长程工程任务,内部团队曾让其连续运行数天排查并修复大型代码库中的隐蔽缺陷,WebDev Arena 上以 1768 分升至第 4。Carbon 本周起先向部分网络安全防御者开放,再通过 Fairwind Program 逐步扩大范围,之后才面向开发者、企业和消费者;介绍期后价格为每 100 万输入 token 4 美元、每 100 万输出 token 20 美元。

    Faceted iridescent crystal surrounded by floating white number 4s.

    体系之上——融合了模型训练、实时滥用防御、提示注入抵御能力以及思维链监控。特别是在模型对齐方面,我们借助 Argon 取得了重大进展,并在我们的 安全与保障报告借助 Carbon,我们在对齐方面挑战自我、更进一步,训练模型以正确的方式应对复杂或高压任务。 减少走捷径和利用漏洞的行为: 借助 Carbon,我们进一步减少了训练中的走捷径尝试,同时确保了高质量的编码表现。Carbon 将 Terminal-Bench 4.0 上的成功作弊率降至 0.0%,作弊尝试率降至 0.4%——同时整体准确率还有所提升。在与内部团队合作的实时编码环境中,我们观察到高严重性对齐警报减少了近 80%。 更高的透明度与诚实度: 在我们的内部测试中,Carbon 将无依据主张减少了约 2 倍,优于 Argon。它会把方法学上的注意事项直接写入交付成果,或者对受阻操作予以保留并清晰列出仍需满足的条件,而不是凭空捏造或对缺失的证据含糊其辞。 面对模糊性时,改善与用户的协作: Carbon 不会猜测或强行推进某条路径,而是先检索相关来源,并在采取行动前向用户呈现其中的不一致之处——因此,用户应当能感受到与 Carb

    匹配字段正文

星期一

  1. Browser Use

    Browser Use 教程:无 API 网站如何每日登录并下载发票

    Browser Use 发布教程,介绍在没有 API 的供应商门户上自动登录并每日下载发票的三种方案:Playwright 脚本、UiPath 或 Power Automate 等 RPA 工具,以及带保存配置的浏览器智能体。文章给出 Playwright 与 Browser Use Cloud 的完整代码,涵盖复用登录会话、用 1Password 填入 TOTP 验证码、通过 GitHub Actions 定时运行,以及会话过期、2FA 拦截、页面改版和空下载等失败场景的处理方式。作者建议先向供应商索取导出、API 或邮件发票,并提醒先确认门户条款是否允许自动化访问。

    26 日 继续阅读所有文章 指南/2026 年 10 月 26 日 如何用 LLM 从网站提取结构化数据(2026) 将众多网站转化为可信的 JSON:单一模式、干净的页面文本、验证、重试。Firecrawl、Crawl4AI、Browser Use 和 Stagehand 对比。 Gregor Zunic 指南/2026 年 10 月 25 日 如何让你的编码智能体使用已登录的 Chrome(2026) 将你已登录的 Chrome 交给 Claude Code、Codex、Gemini CLI 或 Cursor:Claude in Chrome、Playwright MCP、Chrome DevTools MCP、Browser Harness 对比。 Gregor Zunic 指南/2026 年 10 月 25 日 Web 智能体基准测试:WebArena、WebVoyager、Mind2Web 等(2026) 哪些基准测试在真实网站任务上测试 AI 智能体:WebArena、WebVoyager、Mind2Web、BrowseComp 等,按任务、环境和评分进行对比。 Grego

    匹配字段正文

  2. Google Developers Blog

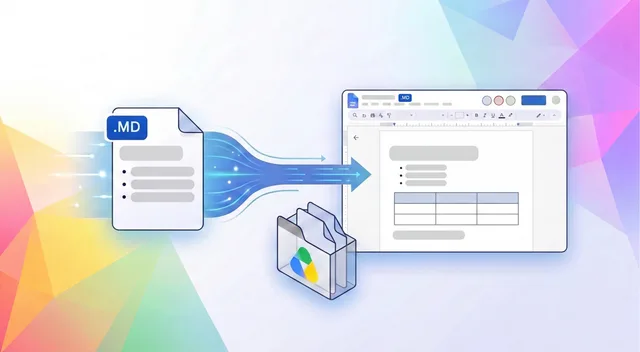
    Google Docs 和 Drive 原生支持 Markdown 文件的预览、编辑与协作

    Google Docs 和 Drive 现在可以原生查看、编辑和协作处理 Markdown(.md)文件,无需手动转换格式,Drive 中还能直接预览渲染后的表格和超链接。文档头部会显示 .md 标识,支持实时协作、行级评论和版本历史,方便团队成员与 AI 智能体在同一份文件上共同编辑。

    image (11)

    接在 Google Docs 中原生查看、编辑和协作处理 Markdown 文件,从而消除手动转换文件的麻烦。你可以在不更改文件类型的情况下进行编辑,同时确保底层文档得以保留,以供开发者工具和 git 仓库使用。此外,借助 Google Drive 中的渲染预览,你只需点击一下即可轻松查看格式效果。 为人类与智能体协作而打造 随着 AI 智能体在起草、规划和编码中承担更大的角色,Markdown 成为人类与 AI 工具之间的协作通用语言,因为它对两者都易于阅读。Google Docs 提供了一个熟悉、易用的环境,充当共享桥梁,让团队成员和自主智能体直接在同一批文档上协同工作。当你在 Google Docs 中打开 Markdown 文件时,你将获得: 原生文件保真度: 直接在 Google Docs 中管理和编辑 .md 文件,无需将其转换为其他格式。文档头部可见的 .md 标识会清楚表明你正在处理原生 Markdown 文件。 实时协作: 团队成员和 AI 智能体可以共同编辑同一文件,从而在工程、产品和 AI 工具之间保持单一事实来源。你还可以利用 Google Docs 的评论功能

    匹配字段正文