←搜索结果

按匹配度 · 共 2019 条结果 清除搜索

星期五

  1. PyTorch Blog

    PyTorch 大会 2026 在圣何塞举行,公布 TorchTPU 与 TorchNeuron 等进展

    PyTorch Conference North America 2026 于 10 月 20–21 日在圣何塞举行,吸引 3500 多名参会者,聚焦加速开放智能及 PyTorch、vLLM、DeepSpeed、Ray、Helion、Safetensors 等项目。会上公布了 Google 与 Meta 合作的 TorchTPU 原生 PyTorch TPU 后端,以及面向 AWS Trainium 的 TorchNeuron 原生后端,后者于 10 月 20 日以 Apache 2.0 进入公开测试。Shopify 分享了用 PyTorch 与 vLLM 构建持续学习循环的案例,称其每天将生产故障压缩进模型权重,服务成本降低 96%。

    PyTorchCon community expo

    Titan 在其 5D 并行栈中扩展了模型支持,并通过 TitanRL 引入了强化学习。TitanRL 在预训练、后训练以及在 vLLM 内执行时保持相同的模型实现,支持异步 rollout,并为训练和生成提供多种并行形式。此次更新还涵盖了性能改进、FlexShard、基于图的训练、分布式通信和检查点。 阅读 TorchTitan 更新。 Helion 与 NVIDIA CompileIQ Helion 与 NVIDIA CompileIQ 的集成将编译器控制项加入内核自动调优搜索。开发者可以在内核配置(如 tile 大小和 warp 数量)之外评估 Advanced Control Files,进行离线调优,并固定所选配置。编译器默认值仍是搜索中的一个候选。 阅读关于 Helion 与 NVIDIA CompileIQ 的内容。 Arm Cortex-M CPU 上的 ExecuTorch ExecuTorch 现在提供了从 PyTorch 训练到设备端推理的直接路径。Cortex-M 后端使 PyTorch 模型能够在 Arm Cortex-M CPU 上直接运行,并借助 Arm

    匹配字段正文
  2. Hugging Face

    微软用 ThinkingBox 把数据库评分变成 RL 奖励,微调 Qwen3.8-27B

    微软 Copilot Studio 团队与 Toloka 等合作,将 ThinkingBox-Bench 的数据库终态可执行检查直接作为强化学习奖励,对 Qwen3.8-27B 做全参数 RL 微调。在 507 个未参与训练的分布外任务上,该模型 20 次全部通过的任务数从 38 个(7.5%)升至 107 个(21.1%),pass@1 从 51.70% 升至 60.78%,单次成功成本从 0.177 美元降至 0.139 美元。训练池用离线策略相对难度筛选,最终保留 187 个任务,训练与评测代码已开源在 microsoft/thinkingbox-training。

    分; docs/reference-q38-run.md 用于经过验证的 24-H100 Qwen3.8 配置; docs/evaluation.md 用于合并检查点并运行 ThinkingBox-Bench 507 x 20。 开始之前 已在 Linux 和 WSL 上使用 Python 3.12 和 uv 测试。你需要具备兼容 CUDA/NCCL 栈的 NVIDIA GPU、本地 Qwen3.8-27B 检查点,以及用于模拟用户和评判器的 OpenAI 兼容端点。经过验证的参考配置使用 3 个节点 x 8 块 H100 GPU;更小的自定义配置取决于模型大小、上下文长度和 rollout 并发度。 公开示例任务列表用于演练接口。它不是所报告运行中使用的私有 187 任务训练池。请提供与公开基准保持不相交的授权训练源。 安装 将三个仓库并排放置: 创建经过验证的环境 发布的栈面向 Linux、Python 3.12、Verl 0.9.0 以及固定的包锁: 最后两条命令应报告已验证的已打补丁 Verl 检出,且没有损坏的依赖项。之后不要运行另一次自动包同步:它可能会用原版 Verl w

    匹配字段正文

  3. Latent Space

    为什么 AI 算力是矩形的——对话 Modal CEO Erik Bernhardsson

    Modal CEO Erik Bernhardsson 解释,传统按固定 GPU 数量和时长签订的算力合同呈矩形,而真实负载会波动,Modal 通过聚合数千客户需求提供弹性切片。Modal 已跨过 10 亿美元年化收入、以 160 亿美元估值完成 7.5 亿美元 D 轮融资,并累计启动近 30 亿个 sandbox。sandbox 目前约占 Modal 收入的 1/3,其增长主要来自编码智能体、后台智能体和强化学习。

    并发挥作用时,弹性才有意义。Modal 的无服务器 GPU 文章描述了这套机制:可用 GPU 缓冲区、自定义文件系统、进程检查点和 GPU 内存快照。这些组件减少了让另一个模型副本上线所需的工作。这是一个具体例子,说明基础设施决策如何体现在应用的响应速度和成本上。 我们还讨论了 Erik 从 Spotify 推荐系统到 Modal 的历程、公司如何购买算力、NVIDIA 的替代方案、forward-deployed 工程师,以及为什么在 Modal 代码审查是可选的。跳转到工程文化 → 节目笔记 Modal——Erik 创立的 AI 基础设施平台。 Erik 的文章——他关于基础设施、市场和创办公司的随笔。 Modal 的 D 轮融资公告——公司最新报告的增长和 sandbox 里程碑。 Modal 如何实现真正的无服务器 GPU——弹性推理背后的启动和扩展技术。 Modal 的资源求解器——它如何在不断变化的价格和可用性之间选择容量。 扩展到一百万个并发 sandbox——关于 sandbox 扩展的工程记录。 我们与 Erik 的第一次采访——最初的无服务器基础设施论点。 我们与

    匹配字段正文

星期四

  1. Dwarkesh Patel Podcast & Blog

    2045 年的计算机芯片会是什么样?

    Dwarkesh Patel 花两天走访 Intel 最先进晶圆厂并对话其管理层,探讨 2045 年芯片形态。Intel CTO 称,过去十年 AI 算力需求每年增长 3 倍,但全球芯片制造设备仅够让先进制程产能大约翻倍。节目还以动画讲解 gate-all-around 晶体管、背面供电、CFET、混合键合等技术。

    变其性质。这使它不稳定,现在我们必须为那个工艺找到更好的气密密封。如果我们找不到控制它的方法,那对我们来说就是死路一条。 00:39:45 – 混合键合 Dwarkesh Patel 堆叠晶体管仍停留在研究实验室阶段。而堆叠整个芯片已经投入生产,并且它解决的是另一个问题:独立芯片之间如何通信。 现代计算机被划分为多个部分,每个部分针对不同任务进行优化。例如,Nvidia 的 Blackwell 数据中心 GPU 将两块巨大的处理器芯片连接在一起,并在它们周围环绕八组高带宽内存堆栈。这些芯片必须不断地相互来回发送数据。而在 AI 中,往往正是这种数据传输的速度——而非原始计算本身——限制了工作负载完成的速度。 想象两块并排的芯片,通过彼此相对的边缘进行通信。如果你把每块芯片的宽度和长度都翻倍,电路面积会变成四倍,但用于连接的边缘长度只有两倍。这就是面积与周长的问题。随着晶体管密度提高,芯片进行计算的能力增长得比它搬运数据的能力更快。业界多年前就已知道这个问题,因此发明了多种技术来应对它。 视频旁白 完成的电路必须经过最后两道工序:键合和封装。 Dwarkesh Patel 芯片制造完成后

    匹配字段正文

  2. CTech

    Modelyo 融资 1700 万美元,让企业在不暴露机密的前提下使用 AI

    以色列网络安全初创公司 Modelyo 完成约 1700 万美元融资,由美国 OlivTree 领投,资金将用于研发其“主权机密云”平台并拓展国际业务。该平台结合机密计算、硬件加密、持续验证与零信任架构,使企业在第三方云上运行 AI 和托管服务时仍掌控数据与加密密钥,并以密码学方式证明数据受保护。公司成立于 2024 年,现有 30 名员工,技术背后有 20 多项专利及申请,目标客户包括政府、国防、银行、医疗和关键基础设施运营方。

    集4亿美元,使2026年融资总额达到14亿美元 Cymphony完成2500万美元A轮融资,以保障员工与AI智能体之间日益增长的交集 Corma完成6000万美元种子轮融资,以构建旨在对抗AI驱动网络攻击的AI。Meir是一名预备役中校,在特种作战、组建作战单位以及开发技术和作战能力方面拥有20多年经验。联合创始人Itzhak Aviv博士在国防通信、计算和加密系统方面拥有经验,包括在MATZOV以及以色列国防军通信与计算局的工作经历。另一位联合创始人Michael Kiperberg博士专长于安全虚拟化系统、计算基础设施和加密。研发由Artem Barger领导,其背景包括虚拟化技术、Linux和IBM系统。Modelyo在以色列以及包括美国、欧洲、韩国、印度和阿联酋在内的国际市场开展业务。该公司还表示,它与NVIDIA、Intel和Google合作开展技术计划,旨在推进现代硬件和云基础设施上的机密计算,包括为资源密集型AI应用提供安全环境。其目标客户包括政府、国防组织、金融机构、医疗和制药公司、关键基础设施运营商以及寻求在采用云和AI服务的同时保留对数据和知识产权控制权的大型企业。

    匹配字段正文

  3. Fortune Tech

    马斯克的合并梦想,对 SpaceX 股东却是一场噩梦

    SpaceX 与 Tesla 已各自成立由独立董事组成的特别委员会,探讨两家公司合并;消息公布后 Tesla 股价上涨 3.4%、SpaceX 上涨 7.8%,市值增加 1550 亿美元。按 30% 溢价计算,SpaceX 需支付约 1.98 万亿美元收购 Tesla,并增发相当于现有股本 92% 的股份,股本从 131 亿股增至 250 亿股。Tesla 过去四个季度 GAAP 净利润仅 32.8 亿美元,而 SpaceX 同期亏损 15 亿美元,合并后 SpaceX 股东将让出近一半未来收益。

    于:收购Tesla只会让SpaceX要爬的山陡峭得多,几乎陡了一倍。 如果SpaceX承担30%的溢价,合并后的公司起步市值将为4.12万亿美元。(即SpaceX当前的2.14万亿美元加上为收购Tesla支付的1.98万亿美元。)SpaceX 2.0将超过Alphabet(4.0万亿美元)和Microsoft(3.9万亿美元),成为美国第三大市值企业,仅次于Nvidia(5.3万亿美元)和Apple(5.0万亿美元)。据《财富》估计,SpaceX需要在2035年前实现5500亿美元利润和约3万亿美元收入才能达标。5500亿美元的目标是Alphabet目前利润的两倍多。 再说一次,如果Tesla能带来已经规模庞大且快速增长的利润,任务就不会那么艰难。但情况恰恰相反。这家电动车制造商提供的利润微乎其微,且已从2023年的150亿美元、2024年的50亿美元降至仅为两年前三分之二的运行速率。 Tesla将在SpaceX最需要的地方助其一臂之力:大量现金流来为其庞大而昂贵的人工智能冒险买单 对SpaceX财务状况的关注大多集中在其惊人的现金消耗上,这主要是在为其人工智能(即它现在所称的“超级智

    匹配字段正文

  4. The Elec

    AMD 将 FSR 4.1 支持扩展至 RX 6000 系列

    AMD 于 10 月 20 日宣布将 FSR 4.1 的支持范围扩展至 Radeon RX 6000 系列、Ryzen AI Max 处理器和 Xbox 主机,该技术随 AMD Software: Adrenalin Edition 26.10.1 版本提供。FSR 4.1 采用 INT8 模型,AMD 通过简化和优化计算架构提升了硬件兼容性,并为掌机设备单独设计了轻量模型。此次更新还新增对 Vulkan 3D 图形 API 的支持,并改进了帧节奏。

    理器和 Xbox 主机。FSR 是面向 AMD 图形处理器(GPU)的基于人工智能(AI)的图形增强技术。该技术包含在 AMD Software: Adrenalin Edition 26.10.1 版本中。 在 FSR 3 阶段,AMD 依赖的是为广泛兼容性而设计的基于算法的技术。于 CES 2025 上发布的 FSR 4 转向了基于机器学习的 AI,与 Nvidia 的深度学习超级采样(DLSS)类似。与前几代相比,FSR 4.1 的图像质量显著提升。 FSR 4 最初于 2025 年推出,仅面向 Radeon RX 9000 系列。2026 年 7 月,支持范围扩展至 Radeon RX 7000 系列。该技术采用 8 位整数(INT8)模型。AMD 现已进一步简化和优化其计算架构,以扩大硬件兼容性。 RX 6000 系列是于 2020 年首次推出的显卡产品线。Ryzen AI Max 处理器是 AMD 加速处理器(APU),集成了中央处理器(CPU)、GPU 和神经处理单元(NPU)。 FSR 4.1 还支持搭载 Ryzen AI 9 笔记本电脑处理器、Ryzen AI Z2

    匹配字段正文

  5. AWS Machine Learning

    基于 Strands Agents 的自适应智能体框架 AAIF

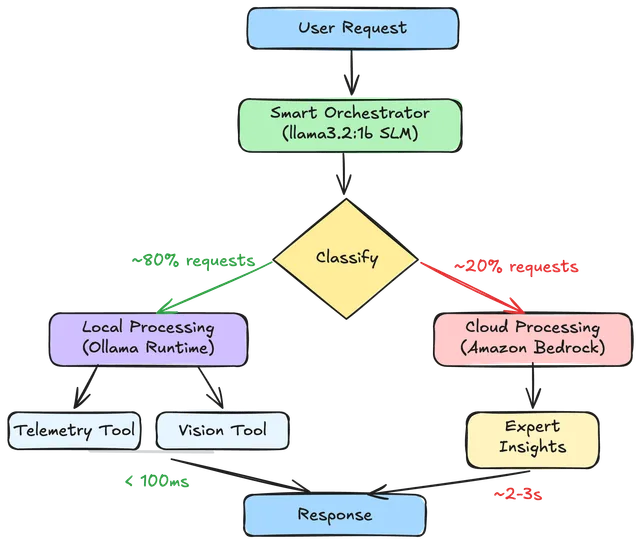
    AWS 用 Strands Agents 构建了自适应智能体智能框架 AAIF,以 llama3.2:1b 作为编排层对请求分类,常规任务交给 Ollama 本地 SLM 处理,复杂分析则经 boto3 路由到 Amazon Bedrock 的前沿模型。该架构可运行在 8 GB 内存的 Raspberry Pi 等边缘设备上,也可全云端或混合部署,从而降低 API 成本并保持本地低延迟。

    AAIF three-layer architecture with an SLM orchestrator routing requests to local processing tools or to Amazon Bedrock cloud processing

    本地解决的常规查询,最终也需要通过完整的网络往返请求云端托管的大语言模型(LLM)。 使用 Strands Agents 构建的自适应智能体智能框架(AAIF)采用了不同的方法。AAIF 不会将所有请求都路由到单个大型模型,而是使用小型语言模型(SLM)在本地处理常规任务。更复杂的请求则通过 Amazon Bedrock路由到云端托管的模型。这种方法建立在 NVIDIA 的 Belcak 等人的研究立场之上。他们认为,小型语言模型“能力足够强大、本质上更适合,并且对于智能体系统中的许多调用而言必然更经济”。该框架基于 Strands Agents 构建,展示了智能模型编排如何帮助降低成本,同时保持本地操作的低延迟。 在本文中,我们将介绍 AAIF 的关键组件,其中通过 Ollama 使用本地 SLM,并通过 Amazon Bedrock 使用云端模型。我们使用物联网(IoT)监控场景作为参考实现。 解决方案概述 如图 1 所示,AAIF 将 AI 处理组织为三个层,每一层针对不同的任务类型进行优化: 智能编排使用轻量级 SLM(llama3.2:1b)作为决策层。该编排器对传入请求进行

    匹配字段正文

  6. PyTorch Blog

    TorchTitan 更新:新增多款 SOTA 模型支持、TitanRL 与大规模性能提升

    PyTorch 原生训练平台 TorchTitan 发布更新,新增 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 的完整训练栈支持,并引入强化学习组件 TitanRL。TitanRL 让预训练、后训练到 vLLM 推理共用同一份模型代码,支持异步 rollout 和长上下文、代码执行等智能体任务训练。性能方面,FlexShard 在 256 张 H100 上把 DeepSeekV3 的优化器耗时最多降低 79%,在 Llama3 405B 上把端到端训练步时最多降低 20%。

    l over recomputed regions, avoiding CPU overhead and custom op wrapper requirements. For distributed compute and scaling, Dist-MoE provides fused communication-compute kernels for NVIDIA SM100+ GPUs with activation packing for dynamic tensors to remain fully CUDA-graphable. Meanwhile, a fully revamped pipeline parallel package provides CUDA-graphable, deterministic execution with user control knobs to maximize overlap when composing FSDP and pipeline parallelism. Finally, TorchTitan overrides en

    匹配字段正文

  7. TechSpot

    SemiAnalysis 称英伟达限制采用 AMD 与 TPU 的 neocloud 参加 GTC Berlin

    SemiAnalysis 称英伟达拒绝部分采用 AMD GPU、TPU 等第三方芯片的 neocloud 厂商参加 GTC Berlin,以此施压其减少采用竞品硬件。报道提到超大规模云厂商因采购量更大未受同样对待,部分 neocloud 已低调部署 AMD 方案以规避压力。SemiAnalysis 今年早些时候还称英伟达会推迟向这类厂商分配新芯片,并影响其 IPO 与融资支持;也有观察者认为英伟达有权决定自家会议的邀请名单。

    Rumor mill: Analysts with SemiAnalysis have uncovered what could be another troubling trend in the AI hardware industry. Nvidia is reportedly retaliating against some "neocloud" providers for integrating GPUs and other chips from rival manufacturers into their cloud offerings. SemiAnalysis' latest "shocking" rumor allegedly confirms what the firm had already revealed in June. Several neocloud providers have reportedly been denied access to GTC Berlin, Nvidia's upcoming conference covering AI, GP

    匹配字段正文

  8. Clément Delangue

    Hugging Face 与英伟达展示欧洲造机器人 Microduck

    Hugging Face 联合创始人 Clément Delangue 称,英伟达 CEO 黄仁勋欧洲之行收官时把 Microduck 机器人带上舞台。该机器人由 Pollen Robotics 与 Hugging Face 团队在法国波尔多设计研发,2026 年全球销量超过 15,000 台,成为当年最受欢迎的机器人。Delangue 表示欧洲在 AI 时代的机会比以往任何技术浪潮都大,将与英伟达及开源 AI 社区共同证明这一点。

    It feels pretty fitting for @JensenHuang & @nvidia to end their European tour with Microducks on stage. Microduck was designed and engineered in Europe (more precisely Bordeaux, France) by the @pollenrobotics and @huggingface teams. With American capital and ambition + Chinese manufacturing genius, it became the most popular robot of 2026 with over 15,000 sold all over the world! I believe Europe has more opportunity to shine in AI than in any previous tech wave. We intend to prove it with @hugg

    匹配字段正文

星期三

  1. LMSYS Blog

    SGLang 的弹性专家并行扩展:用 NIXL 在线扩容 MoE 部署

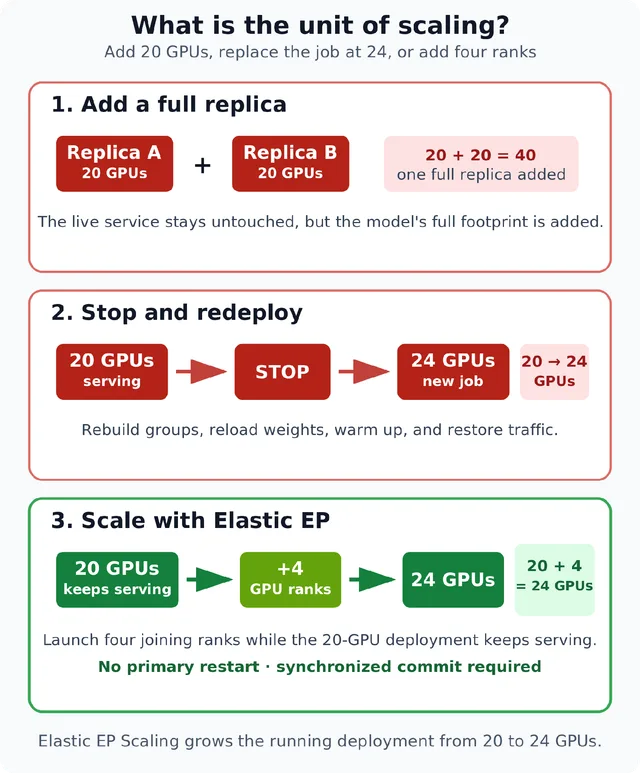
    SGLang 的 Elastic EP Scaling 让 MoE 部署无需整副本或重启即可按细粒度增量加入 GPU,20 GPU 示例中扩到 24 GPU。max_ep_size 在启动时预留元数据与通信缓冲容量,新 rank 按需启动;在 8×H100 上用 DeepSeek-V3-Lite FP8 测试,首个完成请求比重启快 5.3×–8.2×。加入 rank 进入 Mooncake WORLD 后暂不支持自动回滚,收尾失败可能需重启部署。

    Comparison of horizontal scaling, restart-based vertical scaling, and live Elastic EP scaling from 20 to 24 GPUs.

    返回博客‹ 返回博客 目录 摘要 扩容如何建立在恢复机制之上 一个逻辑部署,三层协同 在线 EP 组如何增长 衡量过渡过程 路线图 扩容后的 EPLB CUDA 图重新捕获 多 rank DP 注意力分片 缩容与恢复 试用弹性 EP 扩容 结论 参考文献 致谢SGLang 中的弹性专家并行扩展:使用 NIXL 扩容在线 MoE 部署Yoray Zack — NVIDIA 高级软件架构师、SGLang 贡献者2026 年 10 月 21 日 推理部署在变化的负载下运行,必须在保持吞吐量和延迟目标的同时调整容量。对于大型混合专家(MoE)模型,标准选项是水平扩展(增加另一个完整副本)和垂直扩展(以更宽的专家并行拓扑重启部署)。 水平扩展保持当前服务运行,但会增加完整的模型占用。垂直扩展可以用更小的增量达到所需拓扑,但需要重建分布式状态、重新加载模型并预热新部署。 弹性扩容基于恢复流程中已实现的原则。在恢复中,活动成员会意外变化;而在扩容中,变化是计划内的,新的 GPU rank 在运行时加入。在下面的示例中,一个 20 GPU 的部署通过增加四个 rank 扩展到 24 GPU,而无需替换

    匹配字段正文

  2. Cohere 产品与研究博客精选

    Cohere 发布 Rerank 5 Pro 与 Fast 检索模型

    Cohere 发布企业检索模型 Rerank 5,分 Pro 和 Fast 两档,已在 Cohere API、Model Vault、Microsoft Foundry 和 Amazon SageMaker 上线,Pro 定价为每 1M tokens 0.05 美元、Fast 为 0.02 美元。Cohere 称 Rerank 5 Pro 在 ViDoRe V3、nanoMTEB、BRIGHT 和 BEIR 四项公开基准上领先所有被测模型,在 46 个复合数据集中有 39 个排名第一。新功能 Context Focus 可在单次调用中返回文档内最相关的文本片段,官方测试中移除一半上下文仅损失 2 个百分点答案质量。

    Abstract image

    ng Gemini 1.5 Flash. Latency + Throughput Rerank 5 Fast is built for volume. Under sustained load, Fast reranks about 187 standard-length documents (1,000 tokens) per second on an NVIDIA A100 GPU - delivering 2.9x the throughput of Pro. Fast also delivers nearly 3x faster response times than Pro, making it ideal for latency-sensitive applications and agents that run many searches per task. Pro remains best suited for applications where ranking quality takes priority over speed. Document throughp

    匹配字段正文

  3. ChinaTalk精选

    中国商务部拟将AI模型纳入出口管制目录

    中国商务部和科技部于10月16日发布2026年第48号公告,拟在《中国禁止出口限制出口技术目录》中新增40项条目,其中14项为禁止出口、26项为限制出口,并即日起对全部新增技术实行出口前登记。草案对前沿模型设定≥10^26 FLOP、≥2T参数或达到全球领先水平三条门槛,同时覆盖AI芯片设计、存储芯片、万卡级集群、智能体、AIGC检测工具、训练数据和网络攻防能力;开源、自建海外数据中心、海外流片等场景可走即报即出通道。意见征集期至11月15日。

    could have a comparative advantage include wiring many weaker chips into superPoDs like Huawei’s CloudMatrix 384, engineering systems to keep running through failures, and mixing Nvidia and domestic fleets as one. This corresponds directly to this announcement’s proposed restriction on the export of technology relating to large clusters (≥10,000 AI accelerators) with either fast interconnect (≥800 GB/s), fast recovery from failures (≤120 s), high scaling efficiency (≥98%), or unified scheduling

    匹配字段正文

  4. TechSpot

    AMD 将 FSR 4.1 超分下放到 Radeon 6000 与 Ryzen AI Max

    AMD 在显卡驱动 26.10.1 版本中把 FSR 4.1 超分开放给 Radeon RX 6000 系列桌面 GPU、Ryzen AI Max APU 以及搭载 Ryzen AI 9 的笔记本,用户无需再借助 Optiscaler 等第三方模组。FSR 4 去年发布时仅支持 RX 9000 系列,2026 年 6 月扩展到 RX 7000 系列。搭载 Ryzen Z2 Extreme、Ryzen AI Z2 Extreme 和 Z2 A 的掌机也在支持范围内,但需等待设备厂商推送驱动。AMD 表示 Xbox Series 主机的支持即将到来,但未提及 Steam Deck。

    Cs can now enable FSR 4.1 upscaling without mods like Optiscaler. The update, included in version 26.10.1 of AMD's graphics driver, aims to bring upscaling image quality closer to Nvidia's DLSS. FSR 4 supported only RX 9000 cards when it launched last year, but AMD extended support to the RX 7000 series in June 2026. This week's update brings the feature to all RX 6000 desktop GPUs, Ryzen AI Max APUs, and laptops with Ryzen AI 9 chips. Handhelds with Ryzen Z2 Extreme, Ryzen AI Z2 Extreme, and Z2

    匹配字段正文

  5. 半导体产业纵横

    AMD与Intel将x86 CPU的PyTorch优化统一进oneDNN

    AMD与Intel宣布将各自针对PyTorch的x86 CPU优化工作统一整合进开源深度学习加速库oneDNN,AMD把自研ZenDNN并入其中,并以指导成员身份加入Linux基金会旗下的UXL基金会。整合后开发者只需对接一套接口,即可同时获得AMD EPYC与Intel Xeon的底层优化。双方还在共同开发面向矩阵乘法的下一代x86指令集扩展ACE,计划通过后续oneDNN版本逐步集成到PyTorch。

    阵营在指令集架构(ISA)层面的一次自我革新,用统一的底层指令定义,去匹配AI工作负载的新需求。 x86必须在ARM攻势前守住软件生态 从宏观的角度看,这次合作更多是补全自身的防御短板。Arm在今年10月刚发布了AGI CPU,并联合Fujitsu、Meta、OpenAI推出了新的CPU评测方法论,声称其方案在每机架性能上可达主流x86服务器处理器的2倍。而NVIDIA也在5月发布了定位为“Agent CPU”的Vera处理器,宣称比x86方案任务完成速度快1.8倍。市场研究机构的预测更不乐观:到2030年ARM定制/ASIC在服务器CPU价值份额中的占比预计将达到约37%,而Intel和AMD各约28%。 ARM阵营的差异化竞争,不再只拼硬件性能,而是围绕“为AI从头打造”的新故事展开,从最底层的指令集到上层软件栈实现系统性重塑。面对这种攻势,x86阵营最不能输的就是开发者生态。如果开发者需要为AMD和Intel分别维护两套AI优化代码,迁移到ARM平台的成本优势就会变得更加诱人。而把oneDNN统一为默认路径,则等于告诉开发者:你在x86上写的AI代码,AMD和Intel都能跑,而

    匹配字段正文

  6. Unite.AI

    Databricks 正式发布 AI Runtime 托管 GPU 训练平台

    Databricks 于 2026 年 10 月 21 日宣布 AI Runtime(AIR)正式可用,这是内置于 Databricks Lakehouse 的全托管无服务器 GPU 平台,用于在企业数据上训练和微调深度学习模型。Databricks 称已有数百家公司使用 AIR,平台经过超过 10 万 GPU 小时的训练运行,并支持通过一条 CLI 命令启动首个工作负载、用自然语言提示迁移 Kubernetes 或 SLURM 上的工作负载。Superhuman 的 Kostia Omelianchuk 表示,团队把训练从单节点 8 块 A100 扩展到多节点 16 块 H100,训练时间从约 7 天降到 48 小时。

    so described built-in priority and pre-emption controls that minimize idle GPU time and monitoring through tools such as Genie ZeroOps. The AI Runtime product page lists on-demand NVIDIA GPUs with multi-region capacity, distributed training across multiple GPUs and nodes with managed RDMA networking, optimized checkpointing for long-running jobs, and support for custom Docker containers, including NVIDIA NGC containers. Kostia Omelianchuk, an applied research scientist and area tech lead at Supe

    匹配字段正文

  7. heise online

    继 QSSR 之后:AMD 将 FSR 4.1 带到 Xbox

    AMD 宣布其 AI 超分辨率技术 FSR 4.1 将登陆微软 Xbox 主机,Xbox Series X、Xbox Series S、ROG Xbox Ally 系列掌机及部分较老的 AMD GPU 都将支持,但主机端支持尚无具体时间表。掌机端将于 10 月 23 日获得精简版 FSR 4.1,所用 AI 模型体积不到原 INT8 版本的一半,可通过 Command Center 新磁贴启用,据 Asus 称覆盖超 400 款游戏。PC 端 RX 6000 系列显卡已随 Adrenalin 26.10.1 驱动支持 FSR 4.1,早于原计划的 2027 年初。

    terne Inhalte angezeigt werden. Damit können personenbezogene Daten an Drittplattformen (Google Ireland Limited) übermittelt werden. Mehr dazu in unserer Datenschutzerklärung. Wie Nvidias KI-Upscaler DLSS nutzt FSR seit Version 4 ein KI-Modell, um Spiele aus einer niedrigeren Auflösung hochzurechnen. Zahlreiche Spiele dieser Konsolengeneration laufen in sehr niedrigen Auflösungen und sehen auf hochauflösenden Fernsehern entsprechend unscharf aus. Kompetentes Upscaling fehlte der aktuellen Konsol

    匹配字段正文

  8. Rohan Paul

    消息称 Groq 下一代推理芯片将堆叠 DRAM 以突破 SRAM 容量限制

    据行业消息,Groq 计划在下一代推理芯片中堆叠 DRAM,以绕开片上 SRAM 容量过小的问题。当前 Groq 3 LPU 的 500MB 片上 SRAM 带宽达 150TB/s,约为 Rubin GPU HBM 带宽的 7 倍,但 256 芯片整机架仅 128GB,低于单块 Rubin GPU 的 288GB。报道中的 3DS 方案通过硅通孔垂直连接 DRAM 裸片并保留标准 DRAM 接口,主要按普通 DRAM 速度增加容量;此前供应链消息还提到 SK Hynix DRAM 以混合键合直接贴合逻辑裸片。Groq 尚未公布该设计,Cerebras 也计划在 CS-6 晶圆上堆叠 DRAM。

    Groq plans to stack DRAM in its next inference chip to get around SRAM’s small capacity, industry sources say. Nvidia paid $20B last December to license Groq’s technology and hire its leaders, so this chip is effectively Nvidia’s next LPU. The big deal here is that, each generated token requires reading the model’s weights from memory, so bandwidth sets speed. The big deal here is that each generated token requires reading the model’s weights from memory, so bandwidth sets speed. Today’s Groq 3

    匹配字段正文

  9. Analytics India Magazine

    OpenAI 拟以 1.4 万亿美元估值融资 300 亿美元,抢在 Anthropic IPO 前

    据路透社报道,OpenAI 正加速推进 300 亿美元融资,估值可能超过 1.4 万亿美元,软银、MGX 等现有投资方在洽谈参与。OpenAI 向投资者称年化收入已达 500 亿美元,并预计 2026 年底升至 700 亿美元;其上一次估值是 2026 年 3 月的 8520 亿美元。报道同时提到 Anthropic 预计 11 月中旬 IPO,估值最高或达 2 万亿美元,其 2026 年第三季度收入为 168 亿美元,上半年算力与基础设施支出近 90 亿美元。

    on Microsoft services. These commitments apply regardless of how much computing capacity the company ultimately uses. Anthropic has also agreed to spend up to $86 billion renting NVIDIA chips through AI infrastructure providers Nscale and Lambda, with the agreements extending into 2033 and 2034, respectively. Anthropic’s infrastructure commitments exceed $600 billion, including more than $160 billion tied to leasing Google chips through an arrangement involving Broadcom, according to WSJ. The c

    匹配字段正文