←搜索结果

按匹配度 · 共 3168 条结果 清除搜索

星期四

  1. LG AI Research 官方博客

    LG AI Research 发布首个开源权重视觉语言模型 EXAONE 4.5

    LG AI Research 发布 EXAONE 4.5,这是 LG 首个以开源权重方式发布的视觉语言模型(VLM),在 EXAONE 4.0 基础上集成自研 Visual Encoder,采用原生多模态预训练同时学习文本与图像。模型引入 Multi-Token Prediction(MTP)模块,推理速度较此前方法提升 1.5 倍以上,并采用自研 AGAPO 强化学习算法提升逻辑推理能力。官方称其在 MMMU-Pro、MathVision、CharXiv、OCRBench_v2 等基准上优于或接近 Qwen 3 VL 32B、GPT-5-mini、Claude Sonnet 4.5,在韩语视觉基准 k-viscuit 和 KRETA 上表现领先,模型已在 Hugging Face 发布并附技术报告。
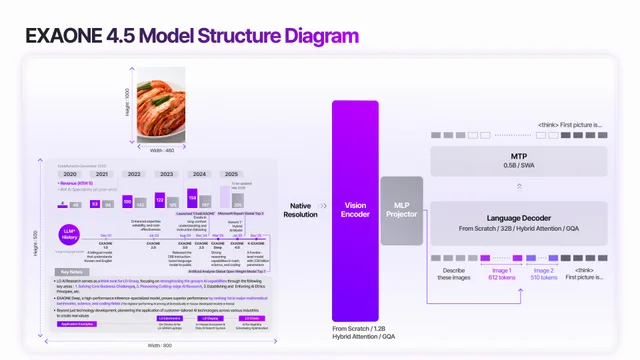
    LG AI Research 发布 EXAONE 4.5,这是 LG 首个以开源权重方式发布的视觉语言模型(VLM),在 EXAONE 4.0 基础上集成自研 Visual Encoder,采用原生多模态预训练同时学习文本与图像。模型引入 Multi-Token Prediction(MTP)模块,推理速度较此前方法提升 1.5 倍以上,并采用自研 AGAPO 强化学习算法提升逻辑推理能力。官方称其在 MMMU-Pro、MathVision、CharXiv、OCRBench v2 等基准上优于或接近 Qwen 3 VL 32B、GPT-5-mini、Claude Sonnet 4.5,在韩语视觉基准 k-viscuit 和 KRETA 上表现领先,模型已在 Hugging Face 发布并附技术报告。

    匹配字段摘要
星期二

  1. Cognition 模型 / Devin 博客精选

    Cognition 发布 SWE-1.6 并在 Windsurf 全面开放

    Cognition 发布面向软件工程智能体的新模型 SWE-1.6,并在 Windsurf 中全面开放,未来 3 个月免费。SWE-1.6 从零后训练,在 SWE-Bench Pro 上与 Preview 版本表现相当,但显著减少了过度思考、串行调用工具和循环推理等行为,更多使用并行工具调用。训练中引入长度惩罚以抑制过长的轨迹。免费版由 Fireworks 提供 200 tok/s,付费用户可通过 Cerebras 获得 950 tok/s 的更快版本。

    匹配字段摘要

  2. Modal 官方工程博客

    Modal 产品更新:RTX Pro 6000 Blackwell、Command K、Sandbox FS API 等

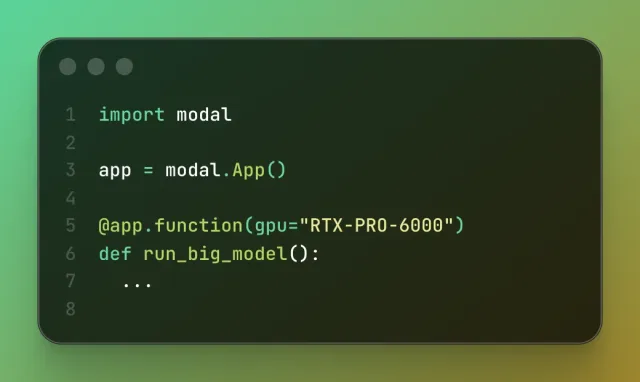
    Modal 上线 NVIDIA RTX Pro 6000 Blackwell GPU,配备 96GB 显存,适合推理与微调负载;仪表盘新增 Command K 命令面板,Sandbox Filesystem API 进入 Beta,支持读取 5GB 文件、任意大小写入与双向流式传输。SDK 1.4.0 新增 modal app logs 与 modal container logs 历史日志查询、--strategy recreate 部署策略,并开始移除 1.0 前旧 API 的向后兼容。

    匹配字段摘要

  3. Together AI Blog

    什么是 AI 原生云?

    Together AI 将 AI 原生云定义为围绕 AI 垂直整合的云平台,统一覆盖 GPU、互连、存储、编排、训练、微调和推理。它应支持数千块 GPU、持续集成前沿研究成果,并在突发需求下兼顾性能、成本与可靠性,让团队无需重写代码即可从本地实验扩展到大规模集群。

    Together AI 将 AI 原生云定义为围绕 AI 垂直整合的云平台,统一覆盖 GPU、互连、存储、编排、训练、微调和推理。它应支持数千块 GPU、持续集成前沿研究成果,并在突发需求下兼顾性能、成本与可靠性,让团队无需重写代码即可从本地实验扩展到大规模集群。 · Together AI defines an AI Native Cloud as a vertically integrated platform spanning GPUs, interconnects, storage, orchestration, training, fine-tuning, and inference. It should support thousands of GPUs, continuously incorporate frontier research, and balance performance, cost, and reliability under bursty demand, allowing teams to scale from laptop experiments t

    匹配字段摘要

星期四

  1. Together AI Blog

    Deepgram STT 和 TTS 模型现已原生运行于 Together AI

    Deepgram 的 STT 和 TTS 模型现已原生运行于 Together AI,开发者可将语音转写、LLM 推理和语音合成部署在同一平台。模型包括支持 250ms 话轮结束检测的 Flux、Nova-3、Nova-3 Multilingual 和 Aura-2,并可通过 Dedicated Model Inference 使用隔离容量及 99.9% 正常运行时间 SLA。

    Deepgram 的 STT 和 TTS 模型现已原生运行于 Together AI,开发者可将语音转写、LLM 推理和语音合成部署在同一平台。模型包括支持 250ms 话轮结束检测的 Flux、Nova-3、Nova-3 Multilingual 和 Aura-2,并可通过 Dedicated Model Inference 使用隔离容量及 99.9% 正常运行时间 SLA。 · Deepgram’s STT and TTS models now run natively on Together AI, allowing developers to deploy speech transcription, LLM reasoning, and speech synthesis on one platform. The lineup includes Flux with 250ms end-of-turn detection, Nova-3, Nova-3 Multilingual, and Aura-2, with isolated capacity and a 99.9% upti

    匹配字段摘要

  2. Qwen Blog精选

    阿里千问发布 Qwen3.6-Plus,主打真实世界智能体能力

    阿里千问发布 Qwen3.6-Plus,通过阿里云百炼 API 提供,默认 1M 上下文窗口,重点提升智能体编码与多模态感知推理能力。官方基准显示其在 SWE-bench Verified 得 78.8、Terminal-Bench 2.0 得 61.6、QwenClawBench 得 57.2,均高于 Qwen3.5-397B-A17B。API 新增 preserve_thinking 参数用于保留多轮思考内容,默认关闭,可接入 Claude Code、Qwen Code、Cline、OpenCode 等编码工具。

    阿里千问发布 Qwen3.6-Plus,通过阿里云百炼 API 提供,默认 1M 上下文窗口,重点提升智能体编码与多模态感知推理能力。官方基准显示其在 SWE-bench Verified 得 78.8、Terminal-Bench 2.0 得 61.6、QwenClawBench 得 57.2,均高于 Qwen3.5-397B-A17B。API 新增 preserve thinking 参数用于保留多轮思考内容,默认关闭,可接入 Claude Code、Qwen Code、Cline、OpenCode 等编码工具。

    匹配字段摘要

星期三

  1. Sakana AI:Blog

    Sakana AI 推出商用研究助手 Sakana Marlin 并启动封闭 β 测试

    Sakana AI 发布其首个商用产品 Sakana Marlin,一款面向商业调研的自主研究助手,并开始招募封闭 β 测试者,测试期间免费。用户只需给出调研主题,AI 即可自主研究近 8 小时,输出结构化摘要幻灯片和数十页调研报告,全程无需人工介入。该产品基于 AB-MCTS 的推理时搜索与 AI 科学家的工作流自动化技术,可调用多个模型协同调研;此前验证中,其在信息深挖方面获得比现有聊天服务内置研究功能更实用的反馈。

    匹配字段摘要

星期四

  1. Noam Shazeer

    Gemini 3.1 Flash Live 现已开放使用,面向生产级语音智能体

    Gemini 3.1 Flash Live 现已开放使用,整体质量得到改进,支持开发者和企业规模化构建可完成复杂任务的语音优先智能体。该模型在 ComplexFuncBench Audio 的受约束多步函数调用和 Scale AI AudioMultiChallenge 的含中断长程推理测试中领先,并以多语言能力支持 Search Live 推广。

    Gemini 3.1 Flash Live 现已开放使用,整体质量得到改进,支持开发者和企业规模化构建可完成复杂任务的语音优先智能体。该模型在 ComplexFuncBench Audio 的受约束多步函数调用和 Scale AI AudioMultiChallenge 的含中断长程推理测试中领先,并以多语言能力支持 Search Live 推广。 · Gemini 3.1 Flash Live is now available with improved overall quality, enabling developers and enterprises to build voice-first agents that perform complex tasks at scale. It leads ComplexFuncBench Audio for constrained multi-step function calling and Scale AI’s AudioMultiChallenge for long-horizon reasoning with interrup

    匹配字段摘要

星期三

  1. Modal 官方工程博客

    Doppel 如何用 Modal 消除 ML 基础设施税

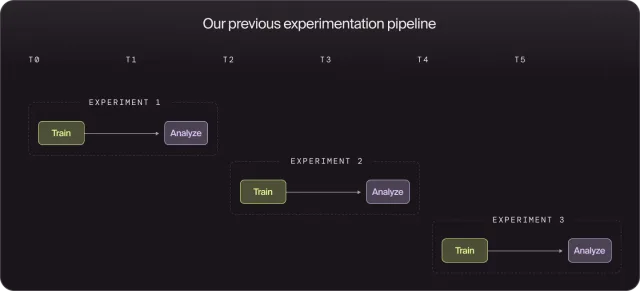
    Doppel 将大部分 ML 工作流迁移到 Modal,训练实验从串行改为并行,推理部署的镜像构建时间最多缩短 10 倍,复杂模型也能实现亚分钟级热构建。Modal 的 CLI 让编码智能体可直接启动实验、查看日志并触发后续运行,Cloud Run 单实例仅支持单 GPU 等限制带来的运维摩擦随之减少。

    匹配字段摘要

  2. Anthropic Engineering精选

    Anthropic 详解 Claude Code auto mode:如何更安全地跳过权限确认

    Anthropic 发布 Claude Code auto mode,用输入层的提示注入探针和输出层基于 Sonnet 4.6 的 transcript 分类器替代人工逐条批准,以缓解审批疲劳。分类器分两阶段运行,第一阶段单 token 快速过滤、第二阶段仅在命中时启用链式推理,把 8.5% 的误报率降到 0.4%。在 52 条真实过度主动行为样本上,其漏报率为 17%,官方称多数漏判源于把会话中的批准痕迹误当作对当前操作范围的授权。

    匹配字段摘要

星期日

  1. Sakana AI:Blog

    Sakana AI 与读卖新闻联合分析 SNS 认知战,处理 110 万条帖子

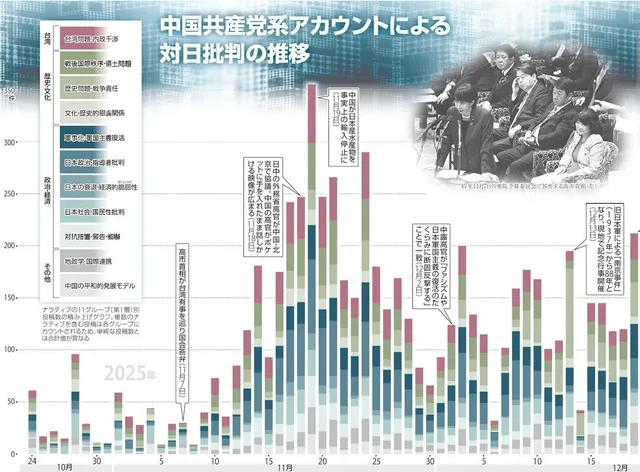
    Sakana AI 与读卖新闻社合作,用其自研 AI 系统分析了 SNS 上约 110 万条涉华对日批评帖子,提取叙事结构并生成可验证假设。系统依靠三项技术:从上下文和语气中提取叙事、用三种不同 LLM 集合推理进行新颖性搜索并分层可视化、以及自动生成带推理路径的假设供人工核验。读卖新闻对其中一条关于对日批评时间线的假设进行了采访核实,Sakana AI 同时宣布将防务与情报列为与金融并列的重点领域。

    匹配字段摘要

星期二

  1. Browser Use

    New Generation 如何用 Browser Use 为智能体评估电商网站

    New Generation 的智能体电商平台 Kepler 推出 Agent Score,用于评估电商网站对 AI 智能体的支持程度,衡量智能体能否有效访问、导航并推理商品与站点信息。Agent Score 基于 Browser Use 运行,可并发启动数百个浏览器会话,对真实品牌站点进行大规模智能体就绪度测试。自 2 月以来,New Generation 已运行超过 120,000 个 Browser Use 任务。

    匹配字段摘要

星期一

  1. Prime Intellect

    Prime Intellect 如何借助 NVIDIA 构建开放超级智能栈

    Prime Intellect 公布与 NVIDIA 的合作细节:训练与推理负载运行在 NVIDIA Blackwell 及即将推出的 Vera Rubin 机架级系统上,并用 NVIDIA Dynamo 承担全球推理编排,支持 LoRA 服务与 Arcee Trinity 等大规模 MoE 推理。其沙盒基础设施适配 Vera CPU,单路 88 核、SMT 开启后 176 线程可稳定运行 176 台 VM,真实 RL 沙盒负载下每 CPU 吞吐较 AMD Zen 5 平均高 30%。

    Leveraging NVIDIA to Build the Open Superintelligence Stack

    匹配字段摘要

星期五

  1. Ed Bayes

    Ed Bayes 称赞 OpenAI 自动化功能 GA

    OpenAI Developers 宣布 Automations 正式 GA,支持设置模型与推理等级、选择在 worktree 或现有分支中运行、用模板复用工作流,适用于每日仓库简报、issue 分诊、PR 评论跟进等重复任务。Ed Bayes 转发并评论:更干净、更简单、更灵活!自动化起来!

    匹配字段摘要

星期二

  1. METR Notes

    METR 用 Opus 4.6 复刻《杀戮尖塔》与《小丑牌》CLI 版的观察

    METR 用简单 ReAct 脚手架让 Opus 4.6 复刻《杀戮尖塔》和《小丑牌》的 CLI 版本,给出 6000 万 token 总量、64,000 token 上下文窗口和 max 推理强度,结果两个游戏都基本可玩但存在不少缺陷。作者各试玩约两小时,发现卡牌效果偏差、地图导航混乱、部分遗物与事件缺失、优惠券逻辑错误等问题,并估计自己达到同等质量需 2 到 8 周。作者在 7 月 27 日的更新中表示深入检查《杀戮尖塔》成品后发现了更多初看不易察觉的问题。

    匹配字段摘要

星期日

  1. Cognition 模型 / Devin 博客精选

    Cognition 发布 SWE-1.6 早期预览:SWE-Bench Pro 较 SWE-1.5 提升 11%

    Cognition 公布 SWE-1.6 的早期预览,该模型与 SWE-1.5 基于同一预训练模型做后训练,推理速度同为 950 tok/s,当前 checkpoint 在 SWE-Bench Pro 上比 SWE-1.5 高 11%。团队称通过改进 RL 配方和扩展基础设施获得两个数量级算力,训练步骤比 3 个月前快 6 倍,并使用低至 NVFP4 的精度和 NVIDIA Multi-Node NVLink 加速。目前该模型向少量用户开放早期访问以收集反馈,团队同时指出大规模 RL 带来了过度思考、过多轮次等影响模型使用体验的行为。

    匹配字段摘要

星期四

  1. 蚂蚁百灵:Developer Blog

    蚂蚁百灵发布 Ling 2.5 万亿参数混合线性架构改造实践

    蚂蚁百灵在开发者博客公开 Ling 2.5 架构改造实践,将 Ling 2.0 的 GQA 替换为 1:7 的 Lightning Attention 与 MLA 混合线性注意力,并扩展到万亿参数规模。Scaling Law 实验显示 1:7 比例(M=8)在相同 FLOPs 下表现最佳,M=16 推理成本低但 Loss 明显劣化。团队通过权重转换、QK Norm 数学融合与 Partial RoPE 解耦实现平滑迁移,并采用激进数据切换策略在全量加训早期切入新语料。博客提到当上下文窗口扩展至 256K 或更大时,Ling-2.5-1T 仅有的 10 层 MLA 占据超过 60% 的计算成本。

    01

    匹配字段摘要、正文

星期三

  1. Zyphra Research

    Zyphra 发布 ZUNA 脑机接口基础模型,推进思维转文本

    Zyphra 发布首个基于脑数据训练的基础模型 ZUNA,这是一个 380M 参数的扩散自编码器,可从有噪声或不完整的头皮 EEG 数据中重建高保真脑信号,并能从稀疏输入和电极坐标预测缺失通道,适配从消费级头戴设备到 256 电极研究系统的多种布局。ZUNA 在更高缩放因子下持续优于 MNE 中实现的球面样条插值这一行业标准方法。模型以 Apache 2.0 许可开源,权重发布于 Hugging Face,推理与预处理代码发布于 GitHub,并提供 pip install zuna 安装包。

    匹配字段摘要

  2. Claude Platform:开发者版本说明精选

    Anthropic 发布 Claude Sonnet 4.6,支持 1M token 上下文

    Anthropic 发布 Claude Sonnet 4.6,在编码、计算机使用、长上下文推理、智能体规划和知识工作等方面全面升级,并支持 1M token 上下文窗口(beta)。该模型现为 claude.ai 和 Claude Cowork 的默认模型,定价与 Sonnet 4.5 相同,起价 $3/$15 每百万 token。早期测试中,用户在 Claude Code 里对 Sonnet 4.6 的偏好度比 Sonnet 4.5 高约 70%,比 Opus 4.5 高 59%。

    匹配字段摘要

星期一

  1. 蚂蚁百灵:Developer Blog

    蚂蚁百灵发布并开源 Ling-2.5-1T 即时模型

    蚂蚁百灵发布并开源旗舰级即时模型 Ling-2.5-1T,总参数 1T、激活 63B,预训练语料从前代 20T 扩展至 29T,支持最高 1M token 上下文。模型采用 1:7 的 MLA + Lightning Linear 混合线性注意力架构,引入正确性与过程冗余复合奖励机制,在 AIME 2026 上平均输出约 5890 token 即接近消耗 15k–23K token 的前沿思考模型水平。官方称其在复杂推理与指令遵循上优于 DeepSeek V3.2、Kimi K2.5、GPT 5.2,可适配 Claude Code、OpenCode 等智能体产品,但在复杂智能体交互和长程任务上仍落后于前沿模型。

    匹配字段摘要、正文