←搜索结果

按匹配度 · 共 2783 条结果 清除搜索

星期二

  1. Google Blog

    Google 如何通过 Android 新功能、行业联盟与 600 万美元资助对抗亚太诈骗

    Google 正通过 Android 的 Fake Call Detection 识别 AI 驱动的电话冒充、Pixel 内置诈骗检测,以及与业界共享威胁情报来加强亚太地区防诈。Google.org 还向 The Asia Foundation 和 Tech for Good Institute 提供 600 万美元资助,用于培训社区、孵化 AI 防御原型,并将教育游戏 Be Scam Ready 扩展至印尼、日本、马来西亚、菲律宾和越南。原文提到 2025 年东亚、东南亚、澳大利亚和新西兰的诈骗损失最高达 1141 亿美元。
    A woman using her smartphone, surrounded by graphic icons representing online security, privacy, and message alerts.

    我们正在加强整个亚太地区对复杂诈骗的防御。我们新的 Android 功能现在可以检测 AI 驱动的冒充电话,并向您发出可疑消息提醒。我们还与行业伙伴合作共享威胁情报,并提供 600 万美元资助当地组织。这些努力帮助您、小型企业和社区识别欺诈、安全上网,并增强对有组织犯罪团伙的抵御能力。 摘要由 Google AI 生成。生成式 AI 仍处于实验阶段。 探索其他样式: 诈骗正变得日益复杂,其背后是跨国犯罪集团 日益精密的作案手法 。最近一份 联合国报告 说明了这些诈骗在整个亚太(APAC)地区造成的影响。2025年,东亚、东南亚、澳大利亚和新西兰的诈骗损失高达1141亿美元,据称 超过40%的东盟消费者 遭遇过诈骗。 应对这些高度组织化的网络需要统一行动。今天,我们分享 Google 如何扩大防御规模以保护亚太社区。这包括跨产品和平台的内置保护、全行业协作,以及新的本地合作以增强社区韧性。 跨设备和平台的内置保护 我们的第一道防线是保护人们日常使用的设备和平台。今年,Android 推出了 Fake Call Detection,这项功能旨在识别 AI 驱动的电话冒充。它基于开放的 R

    匹配字段正文
  2. MacRumors Apple Intelligence

    苹果 2026 财年 Q4 财报电话会:iPhone Duo 供不应求、Siri AI 将设用量上限

    苹果 2026 财年 Q4 财报电话会上,CEO John Ternus 称 iPhone Duo 需求无法满足、供应平衡时间未定,并确认将为 Siri AI 等服务器端 AI 功能设置用量上限、超出需付费扩容。该季度 iPhone 营收 576 亿美元同比增长 17%,Mac 营收 108 亿美元,服务营收 316 亿美元创历史新高,大中华区营收增长 21% 创季度纪录。苹果称内存成本“前所未有”,预计 12 月季度进一步上涨,并预期当季营收同比增长 7% 至 10%。

    户了解 AI 智能体可以访问哪些内容。 就智能体能力而言,你知道,我们认为这些对用户来说是有前景的工具。我们只是希望确保用户清楚自己正在授予哪些访问权限。我们希望确保以保护安全和隐私的方式来做这件事。所以,你知道,我们正在 Siri AI 上大力推进这一点,但我们也感到很受鼓舞的是,苹果设备是使用各种形式 AI 的最佳场所。 他还表示,苹果对隐私的专注使其与其他 AI 提供商区别开来。 我的意思是,如果你仔细想想,你的大量个人数据都存储在 iPhone 上。无论是联系人、通信记录、健康数据、财务数据,所有这些,Siri 都能访问这些数据,并以一种非常安全、私密的方式帮助你获取,其他任何人都无法访问。就连苹果也无法访问,因此我们认为这是一个核心的差异化优势,我们对此感到兴奋,并将继续在这方面推进。 iOS 与 macOS 合并 随着 MacBook Pro 配备触摸显示屏,一位分析师询问未来我们是否会看到单一统一的操作系统。 Ternus 表示,苹果致力于为每一款产品打造最佳版本,同时也会添加 Handoff 等跨设备功能,但公司没有进行重大改变的计划。 如果你看看我们上周在 MacBo

    匹配字段正文

  3. NVIDIA Developer · Generative AI精选

    NVIDIA 开源 NVIDIA Recovery,自动恢复集群分布式训练任务

    NVIDIA 发布开源工作负载级恢复服务 NVIDIA Recovery,通过应用日志、GPU 指标和调度器信号检测训练中断,并按检测、归因、隔离、重启或停止四阶段循环处理。该服务以 Apache 2.0 许可在 dsx-ai-factory/NVIDIA-Recovery 仓库开放,Slurm 集成通过 Helm chart 部署的 Advisor Controller 实现,支持集群内和 SSH 两种模式。新部署默认处于监控模式,只输出恢复建议不执行调度动作;7 月 9 日至 10 月 9 日在一个训练集群上的监控覆盖每天近 200 个任务,记录约 8,550 次异常检测,平均检测与恢复动作延迟分别为 69 秒和 94 秒。

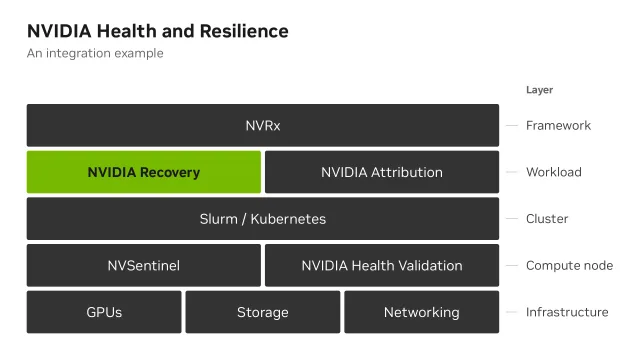
    Five-layer stack diagram showing where NVIDIA Recovery sits in the health and resilience architecture. From the base up: infrastructure, compute node, cluster, workload (where NVIDIA Recovery and NVIDIA Attribution sit), and framework (NVIDIA Resiliency Extension, or NVRx).

    serve"}}' 随后,NVIDIA Recovery 通过应用日志和调度器信号监控工作负载。在监控模式下,它会发布恢复建议而不采取行动。在 Recovery Console 中验证这些建议后,通过在 Helm values 中将 mode 设为 action、将 acknowledgeSchedulerActions 设为 true,即可启用自主恢复。 其他资源涵盖其余内容: 包含源代码和问题跟踪器的 dsx-ai-factory/nvidia-recovery GitHub 仓库。 快速入门指南,无需物理 GPU 即可运行。 操作员部署指南,适用于集群内和基于 SSH 的 Slurm 部署。 架构参考,说明控制平面如何组合在一起。 NVIDIA 归因 是推荐的配套部署。它为 NVIDIA Recovery 提供更深入的诊断结论和更丰富的审计追踪;它是可选的,并与 NVIDIA Recovery 一同发布。 接下来是什么 此版本可恢复 Slurm 作业,包括通过 slurm-operator 在 Kubernetes 上运行的 Slurm。接下来将推出两项能力。针对 Slurm 作

    匹配字段正文

  4. Sierra:Blog

    Sierra 围绕 Ghostwriter 重新设计 Agent Studio

    Sierra 重新设计 Agent Studio,将 Ghostwriter 贯穿整个界面,用户可在同一会话中排查问题、修改 journey、运行模拟并测试修复。每个工作项对应一个会话,改动在评审合并前保留在会话内,支持共享和 fork;相关智能体可归入同一项目统一测试发布,并提供逐行对比、Preview Chat、Simulations 和发布审批与受控上线。

    Ghostwriter

    身处 Agent Studio 何处 现在,当你在 Agent Studio 中移动时,Ghostwriter 会始终陪伴你,并能看到你正在查看的内容——无论是 journey、模拟还是仪表盘。当发现异常时,你可以直接询问,或让 Ghostwriter 当场修复,无需停下来解释上下文。它整合了过去分散在 Explorer、Sierra Assistant 和其他专用智能体中的能力,因此你不再需要了解哪个工具负责什么。 每项工作对应一个会话 与 ChatGPT 或 Claude 类似,每个会话都像一个聊天线程。它会把您与 Ghostwriter 的对话及其所做的更改保存在一起。更改会保留在会话中,直到有人评审并合并。这意味着你可以在一个会话中调查为什么越来越多的客户要求与支持人员通话,而在另一个会话中构建新的 journey,两者互不干扰。 会话也让团队协作更轻松。你可以共享一个会话,共同解决一个问题,或 fork 一个会话,从同事停下的地方继续。在任何内容合并之前,你可以让 Ghostwriter 评审队友的改动。 跨多个智能体构建 大多数客户旅程都涉及不止一个智能体。Agent St

    匹配字段正文

  5. NVIDIA Developer · Generative AI精选

    NVIDIA 发布 Cosmos Framework 与 Cosmos NIM,支持世界模型训练与部署

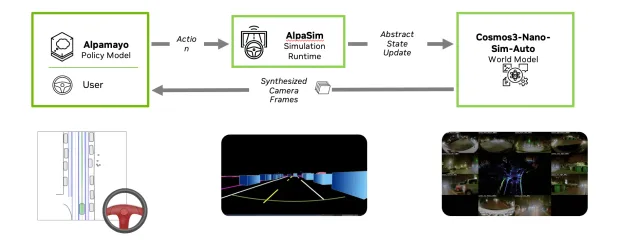
    NVIDIA 发布面向物理 AI 的 Cosmos Framework 和 Cosmos NIM,前者提供训练、强化学习、优化与推理的模块化工具和智能体技能,后者以容器形式提供加速推理服务。Cosmos 3 Nano 仿真配方可从已发布 checkpoint 生成同步的相机视频与 LiDAR 观测,覆盖自动驾驶、机器人和手术场景。NIM 通过量化、投机解码和 KV-cache 感知路由,在 H200 上实测约 2–3 倍加速,Cosmos3-Nano 生成任务在 BF16 下需 58 GiB 显存。

    A policy model (e.g., Alpamayo) or user sends an action to the AlpaSim simulation runtime. AlpaSim updates the simulation state and forwards the context to Cosmos3-Nano-Sim-Auto, which synthesizes the next camera frames and returns them to the policy, completing the loop.

    、验证就绪状态,并发送你的第一个推理请求。 何时使用 Cosmos Framework 进行世界模型开发 Cosmos Framework 是一个开放且完全模块化的框架,用于世界模型训练、模型优化和推理,借助新的智能体技能支持完整的模型开发生命周期。它正从 Cosmos 3 扩展,以支持 NVIDIA Alpamayo、GR00T、Qwen、pi0.5 以及其他兼容的 Hugging Face 模型。 训练 使用新技能更快地在文本、图像、视频、音频和动作上训练模型。 使用 LoRA 进行参数高效适配,或使用全监督微调(SFT)更新所有模型参数。 通过 JSONL、WebDataset、LeRobot 或自定义适配器加载数据,跨 GPU 训练并保存检查点以恢复运行。 将你的智能体指向训练后 技能 以加速并实现自动化。 应用强化学习 该平台现已覆盖 在线与离线强化学习路径新支持的流水线包括: DPO:离线偏好优化。 GRPO:使用规则或模型奖励以及 vLLM rollout 的在线强化学习。 PPO:带冻结参考模型和评论家的 actor-critic 强化学习,包括仿真中具身策略的强化学习

    匹配字段正文

  6. AWS Machine Learning

    Circle K 如何借助 Amazon Bedrock 将 DevOps 事件分诊缩短至 15 分钟内

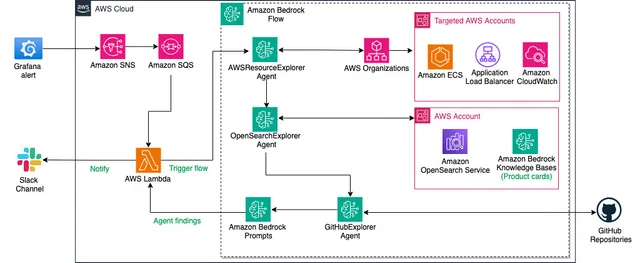
    Circle K 用 Amazon Bedrock 构建智能体式自动分诊系统,把 DevOps 事件平均分诊时间降到 15 分钟以内,按团队内部指标降幅达 67–75%。系统由 Grafana 告警经 Amazon SNS、Amazon SQS 触发 AWS Lambda 调用 Amazon Bedrock Flows,并行调度多个专用智能体查询日志与基础设施,并将结构化摘要推送到 Slack;后续已迁移至 Amazon Bedrock AgentCore。

    Amazon Bedrock Flows triage architecture: a Grafana alert flows through Amazon SNS, SQS, and Lambda to parallel agents that post a summary to Slack

    8 分钟内收到摘要。复杂的多服务事件此前人工分诊需要一小时以上,现在可在 15 分钟内完成。 工程师们现在从摘要入手,而不再自行收集上下文。团队看到事件处理方式发生了三项变化: 一致的分诊。 无论值班工程师对受影响服务的熟悉程度如何,每位值班工程师都会收到相同的结构化摘要,其中包含相同的日志摘录、知识库参考和推荐的后续步骤。 更快的升级处理。 当某个问题需要其他团队提供支持时,摘要会为值班工程师提供相关背景信息,以便及时、知情地进行升级处理。 更快地处理误报。 当分析发现服务运行正常且没有相关错误时,工程师可以确认该告警并继续处理其他工作。 经验教训 构建这个系统经历了多次迭代。其中有四条经验尤为突出,适用于使用 Amazon Bedrock 构建类似解决方案的团队。 将日志内容直接包含在提示词中。早期版本只传递日志组名称和时间范围,然后由智能体尝试通过操作组查询 CloudWatch。这增加了延迟,而且往往返回过多数据而无法处理。Circle K 通过让 Lambda 函数预先查询日志并将相关行直接传递给智能体,获得了更好的结果。当智能体能够读取实际的错误消息时,它的推理速度会更快。

    匹配字段正文

  7. AWS Machine Learning

    用 Amazon Nova Multimodal Embeddings 与 Bedrock…

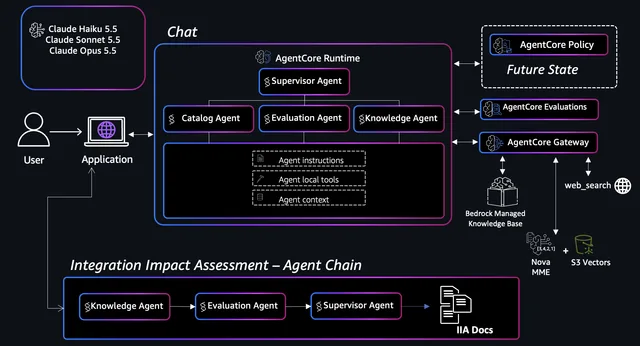
    AWS 展示了基于 Amazon Bedrock AgentCore、Amazon Nova Multimodal Embeddings 和开源 Strands Agents SDK 的多智能体工程助手,用于减少零件替代评估中的人工交叉核对。系统由 planner 将任务路由给 Catalog、Evaluation、Knowledge 三个专家智能体,分别负责多模态检索、按 Python 容差规则打分和用实时网络数据核实生命周期信息,最终由 supervisor 汇总。系统只组装证据并起草评审文档,不自行推荐或批准替代方案,每次评估都会写入对齐 AS9100 8.4 和 8.5.6 的审计记录。

    Architecture of the multi-agent assistant: a planner routes engineer queries across Catalog, Evaluation, and Knowledge specialists, with a supervisor synthesizing results

    及部署到 AgentCore runtime。 完整代码示例是 GitHub 仓库, 中的五个 Jupyter notebook,每个 notebook 均可独立运行。这些 notebook 从 mei core,同一文件夹中包含智能体和工具模块的自包含副本,并且它们包含各自的零件数据、图表裁剪图和评估查询集。你可以在笔记本中运行本文中的每个代码片段,而无需其他应用代码。 构建零件语料库 示例数据集包含来自一家虚构制造商(AnyCompany)的七个反作用轮,动量存储范围覆盖 0.003–5.0 Nms。每个零件都是一个文件夹,将结构化数据与工程师实际阅读的源文档配对,正是这种组合使该语料库成为多模态语料库。 specs.json 文件保存了驱动确定性评分的机器可读字段,而 ICD、产品照片和渲染后的数据表页面则承载了结构化字段所遗漏的视觉与叙述细节。 data/synthetic-parts-data/rw rl 0060/ ├── specs.json structured specs + lifecycle fields ├── description.txt flat text

    匹配字段正文

  8. AWS Machine Learning精选

    在 Amazon SageMaker AI 上用知识蒸馏构建高效智能体

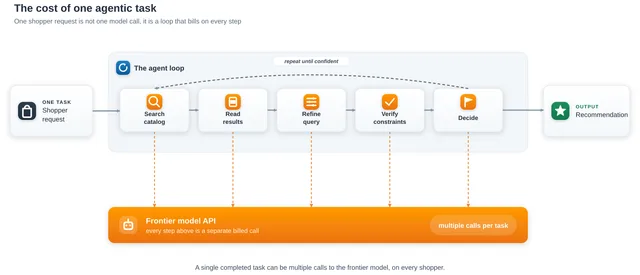
    AWS 官方博客介绍如何用序列级知识蒸馏(SeqKD)在 Amazon SageMaker AI 上微调购物智能体:以 Amazon Bedrock 上的 GLM-5.3 作为教师模型生成轨迹,用 ShoppingBench 评分器只保留解出任务的轨迹,再对 Qwen3.5-4B 学生模型做服务端无服务器 SFT。在 324 道留出测试题上,蒸馏后 4B 学生平均绝对成功率从 0.297 提升到 0.541,与教师模型和中等规模前沿模型基本持平;去掉教师推理过程只学工具调用时,平均成功率降至 0.415。

    Diagram of an agentic task as a loop: search, read results, refine, verify, and decide, with each step a separate billed call to the frontier model

    是序列级知识蒸馏(SeqKD)? 最简便适用的蒸馏形式是序列级知识蒸馏(SeqKD)。它使用教师模型生成高质量响应,然后通过监督微调(SFT)在这些响应上训练学生模型。SeqKD 只需要教师模型的 文本, 无需访问教师 logits,也不需要强化学习基础设施,因此即使面对闭源或仅提供 API 的教师模型也能奏效。与基于 logit 或 on-policy 等其他方法相比,它处于蒸馏谱系中最具成本效益且最易移植的一端。教师写出答案,学生便在这些答案上进行微调。由于这些答案会作为数据集持久保存,你可以复用它们来训练或测试不同的学生模型,而无需重新生成数据。 原则上,你会希望学生模型匹配教师模型在可能输出上的完整分布。但问题在于,你做不到。可能序列的空间极其庞大,因此精确匹配并不可行。SeqKD 通过用教师实际产生的样本进行近似,从而绕开了这一问题。 对于智能体而言,教师产生的序列不是一段散文,而是一条轨迹,即推理、工具调用及其返回观察结果的有序运行,其中每一步都以之前的一切为条件。在整个序列上训练学生模型,能教会它通向每个动作的推理以及多步行动路线本身,而不仅仅是一段答案文本。这使得智能体

    匹配字段正文

星期一

  1. ElevenLabs Blog

    合成语音是如何创建的?分步指南

    合成语音由神经 AI 模型分析并复刻人类语音模式生成,流程分三步:收集真人录音数据、训练或微调模型、再从文本生成音频。现代模型之所以听起来自然,是因为它复刻了人类韵律并具备上下文感知,而非逐词拼接;ElevenLabs 的生成式 TTS 还可用音频标签等指令控制情绪与节奏。

    Collect voice data, train a model, generate speech; voice design needs no recording.

    使没有昂贵的录音设备,你也可以做很多小事来改善语音克隆的效果。 这些习惯有助于你采集干净的样本: 在安静的空间中录音:窗帘和地毯等软质家具可减少回声,关闭风扇和通知可消除背景噪音。 让麦克风保持稳定距离:一致的距离可保持音量均匀,防喷罩可减少刺耳的爆破音。 以你希望克隆声音呈现的方式说话:克隆会复制你的表达方式。以你计划使用的语气和语速进行录音。 避免音乐和其他人声:使用单一说话人,不要有背景音乐或重叠的语音。 保持一致:在所有录音中使用相同的麦克风和房间。 虽然即时克隆需要的音频较少,专业克隆需要的音频较多,但两者都依赖于干净的录音。长度合适的干净音频比大量嘈杂音频能带来更好的结果。 如何在不录音的情况下创建声音:语音设计 并非所有合成语音都始于录音。使用 语音设计,你可以用文本描述你想要的声音,包括年龄、性别、口音、语气和节奏等细节,AI模型会生成与你的描述相匹配的声音选项。你可以试听这些选项,选择你喜欢的一个,并将其保存到你的语音库中。 语音设计 在你需要为角色、品牌或产品寻找声音,而又没有真人可供克隆时非常有用。阅读 语音设计文档 ,了解如何撰写有效的语音描述。 如何判断一个声

    匹配字段正文

  2. Zyphra Research精选

    Zyphra 提出分层注意力 ZHA,实现亚二次复杂度稀疏注意力

    Zyphra 提出分层注意力 ZHA,通过构建并搜索 KV cache 的压缩树为每个查询挑选相关 token,在合适 top-p 阈值下实现亚二次复杂度。ZHA 只需用几十亿 token 的 KL 蒸馏即可把已有预训练模型适配过来,在 Qwen3.6-35B-A3B 上仅新增 81,920 个可训练参数;RULER-13 256K 上宽树达 96.2%、深树 93.3%,LongBench v2 深树 63.4% 高于稠密注意力的 58.0%,SWE-bench Verified 上与稠密基线相当。其 GPU 性能模型预测在约 48K token 时快于稠密注意力、约 480K token 时快于 MSA,一千万 token 上下文下相对稠密注意力约 32–35 倍加速。

    Top-p Set Growth Rate is Sublinear

    关重要。在固定的 top-k 预算下,我们面临一个严格的权衡:k 既要足够大以回答分散的查询,又要在只需一小部分高度集中的子集时避免浪费计算。而 top-p 则允许计算量自然地适应任务。 图 3. ZHA 以自顶向下的方式关注其树索引器,在每一层扩展相关的表示并丢弃不相关的表示。这使得它能够进行有效检索,同时将活跃状态大小保持在亚二次复杂度,这与 MSA 及其他稀疏注意力方法的二次索引器形成对比。 这如何实现亚二次方扩展? 分层索引最重要的优势在于 我们不再需要以相同的分辨率搜索整个索引在每一层,都可以在不检查其具体内容的情况下,将上下文中的大片区域排除在考虑之外。只要所探索的区域数量随上下文长度呈亚线性增长,路由计算和最终的注意力计算就能在每次查询时保持亚线性。这与那些仍需扫描整个上下文的一维扁平索引的稀疏注意力方法有着本质区别。树结构使得 寻找相关 token 的过程本身是稀疏的. 它也与固定大小的状态有着根本区别。ZHA 不对可存储或检索的信息量施加固定的上限。活跃状态可以随上下文持续增长,同时仍显著小于完整序列。此外,完整的 KV-cache 保留在树的叶级,因此原始的键和值仍

    匹配字段正文

  3. Pydantic AI 官方文章

    Pydantic AI 对比 2026 年九款 Python 智能体框架

    Pydantic AI 官方发布 2026 年 Python AI 智能体框架对比,按模型可切换性、崩溃后持久执行、人工审批、前端与语音接入、MCP 和可观测性等标准逐项评估九款框架,并给出各自适用场景。文章称 Pydantic AI 支持 30+ 模型提供商、8 个持久执行引擎(Temporal、DBOS、Prefect、Restate、AWS Lambda、Absurd、pgtask、Apache Airflow)、5 家语音到语音提供商和 10 个沙箱,同时说明其仅支持 Python、不提供托管平台,检索类集成少于 LangChain。对比还覆盖 LangGraph/LangChain、OpenAI Agents SDK、Google ADK、Microsoft Agent Framework、Strands Agents、CrewAI、Claude Agent SDK 和 Agno,并单列 LiveKit Agents 与 Pipecat 两款语音框架。

    Douwe Maan avatar

    并组合流水线,就选 LiveKit Agents 或 Pipecat 。 最后更新:2026 年 10 月 29 日。能力、数量和许可证均于该日期从各项目自己的文档和代码库中读取。 选择智能体框架时应关注什么 以下是我们的标准,而且它们带有明确倾向。 能否在不重写智能体的情况下更换模型? 价格、质量和速率限制每月都在变化。围绕单一厂商 API 构建的框架会让其他所有厂商都成为二等路径,通常要通过文档中称为 beta 的适配器。 进程在运行中途死亡时会发生什么? 需要调用工具数分钟、或等待人工数天的智能体,需要持久执行:一份已完成模型调用和工具调用的日志,重启后的运行可以重放它。检查该框架是否能与你公司已经在用的引擎配合,还是只能用它自己的存储。 人工如何批准某个操作? 要寻找一种在进程消失后仍能存续的暂停,而不是阻塞线程的回调。 智能体如何触达用户? 聊天前端、编辑器、另一个智能体、一通电话。检查该框架原生支持哪些协议,以及语音是否由同一个智能体处理,还是另一套独立技术栈。 追踪数据是否流向你其他追踪数据所在的地方? OpenTelemetry 可发送到任何后端,或使用厂商自己的追踪产

    匹配字段正文

  4. Databricks Blog

    Lakebase Postgres 在 Google Cloud 正式可用

    Databricks 宣布全托管无服务器 Postgres 数据库 Lakebase Postgres 在 Google Cloud 正式可用,支持自动扩缩容、缩容到零、秒级分支和按时间点恢复。它与分析数据共享同一存储层,无需维护 ETL 管道,并通过 Unity Catalog 统一治理;多可用区端点提供 99.99% SLA,单可用区为 99.9%。Lakebase Search 的向量与全文搜索吞吐为 pgvector 的 2 倍、成本低 4 倍。

    Cloud 上构建的团队现在可以直接在 Databricks Data + AI Platform 上运行生产级、无服务器的 Postgres。 Lakebase 架构将计算与存储分离,从而消除了传统数据库的资源冲突和基础设施开销。它还与您的分析数据共享同一存储层,从而无需构建和维护管道。最终得到的 Postgres 数据库可随您的应用扩展,与您数据资产的其他部分共享同一治理模型,并降低您的总拥有成本。 Lakebase Postgres 消除运营障碍,让团队更快交付 多年来,事务数据库和分析平台一直彼此分离。将运营数据移入湖仓意味着需要构建和维护 ETL 管道、重复存储并接受数据延迟。如今 AI 智能体实时对数据采取行动,这种运营开销成为更大的负担。 相反,借助 Lakebase,运营工作负载与分析及 AI 工作负载运行在同一平台上,享有相同的安全与治理。无需管理孤立的数据库,无需维护单独的访问控制,也无需移动数据来保持同步。Lakebase 是 湖仓事务/分析处理(LTAP)架构 的关键组件,该架构使组织能够统一数据基础、降低运营开销并降低基础设施成本。 Google Cloud

    匹配字段正文

  5. LMSYS Blog

    LMSYS 详解 HiCache 如何适配多并行与分布式推理

    LMSYS 博客介绍 HiCache 在上下文并行、流水线并行、投机解码、统一 KV 布局和 P/D 分离场景下的实现方式,核心是让各 rank 在缓存决策上保持一致。讯飞星辰 MaaS 团队用 HiCache 加外部存储服务 GLM-5.1/5.2 CodingPlan 负载,缓存命中率从约 30% 提升到 95%,中位 TTFT 降到 3 秒以内。CP 分片实测中 GPU token 命中率提升 40.48 个百分点,host 内存服务 token 量下降 81.2%,prefill 平均排队时间降低 56.2%。

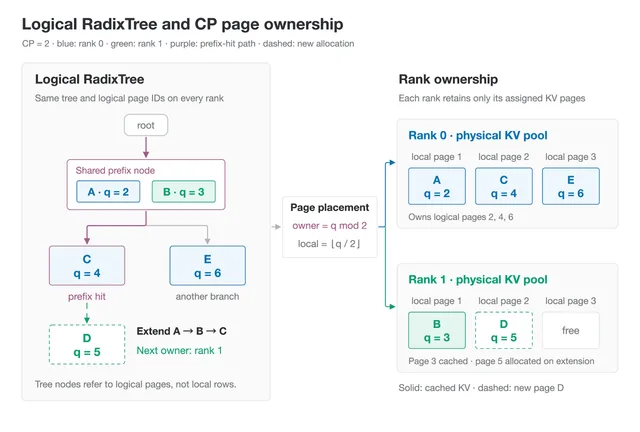
    A logical radix tree shared by two CP ranks: logical page IDs map to rank 0 or rank 1 by q mod 2, and extending the A/B/C prefix allocates page D on rank 1.

    进行匹配。HiCache 将这种复用扩展到主机内存,因此前缀在其 KV 离开 GPU 后仍可复用。在后续请求中,decode 恢复本地缓存的前缀,并要求 prefill 仅发送缺失的后缀。 图 5。 高亮的树路径匹配一个 8K 前缀:A 在 GPU 上,B 在主机内存中。Decode 在本地恢复 B,并仅从 prefill 接收 4K 后缀 C。灰色分支显示其他缓存的前缀;C 尚未缓存。解码会同时等待恢复和接收完成。 对于每个请求,decode 将提示与其基数树进行匹配,并锁定驻留在 GPU 上的前缀。它为任何本地恢复的 KV 和传入的后缀预留 GPU 空间,然后向 prefill 报告可复用边界为 decode prefix len。Prefill 仅发送该边界之后的 KV;其自身的前缀缓存独立决定它可以跳过多少计算。如果配置了外部存储,L3 跨度只有在其预取被接受后才能扩展可复用前缀。 在图 5 中,12K token 的提示包含三个 4K 跨度。A 已在解码 GPU 上,B 在其主机缓存中,C 缺失。树将 A 和 B 匹配为 8K 前缀。解码从主机内存恢复 B,同时从 prefi

    匹配字段正文

  6. Google Blog

    Google 10 月 AI 更新:Gemini 4 Argon 全球上线、Gemini 4…

    Google 在 10 月将前沿推理模型 Gemini 4 Argon 全球上线,覆盖 Google AI Studio、Gemini API、Google Cloud、Search 和 Gemini 应用,两周后公布主打长周期工程与网络安全防御的 Gemini 4 Carbon,目前通过 Fairwind Program 与美国政府及部分可信网络安全方进行预发布测试。同期发布实时交互世界模型 Genie 4,支持原生音频与自然语言操控场景;SynthID Detector 以英文全球开放,可识别 OpenAI、NVIDIA、Kakao、Apple 等合作方的 AI 内容。

    Text with a rainbow colored gradient "The big picture"

    I公告。 10月彰显了我们对AI创新的承诺:我们在全球发布了一款前沿模型,仅两周后又公布了下一款模型。在向开发者、企业、科研人员和消费者推出前沿推理模型 Gemini 4 Argon 之后,我们公布了 Gemini 4 Carbon,这是我们迄今最强的模型,专攻长周期工程与网络安全防御。Carbon体现了我们推进前沿的速度,同时同步强化安全防护措施。10月的其他动态方面,我们推出了 Genie 4 ,用于实时交互式世界模拟并支持原生音频;我们还推出了迄今最智能的健身追踪器 Google Fitbit Edge,打破了 量子计算领域长达20年的瓶颈,以及更多内容。 立即开始使用 Gemini 4 Argon,并了解 Gemini 4 在前沿领域的下一步动向. 在完成早期安全测试后,Gemini 4 Argon 已在全球上线,用于复杂编程、财务分析和法律工作流程,覆盖 Google AI Studio、Gemini API、Google Cloud、Search 以及 Gemini 应用,同时通过 Gemini 4 Argon for Robotics实现物理世界推理。为展示我们推进前沿的

    匹配字段正文

  7. Figma AI / Agent / Make

    Figma 如何把 Hello Kitty 和朋友们带进 FigJam

    Figma 与 Sanrio 合作,从 11 月 1 日起为期一周在 FigJam 上线 Hello Kitty and Friends,用户可从 12 个 Sanrio 角色中选择一个加入头脑风暴,每个角色自带专属光标、和纸胶带和便签主题。团队用 Figma Motion 制作加载动画,并用 Figma agent 完成批量修改;11 月 6–8 日纽约还将举办 Hello Kitty 生日免费快闪活动。

    Three vertical panels showing tightly cropped views of Keroppi, My Melody, and Hello Kitty against green, pink, and red backgrounds, with matching character-themed cursors and name labels.

    神与用心的设计,连接了一代又一代粉丝。以下是我们对工艺与社区的共同热爱如何塑造了我们与Sanrio®的合作——在FigJam中,也在世界各地。 分享:我们如何将Hello Kitty®和朋友们带入Figma Sanrio的旗舰角色Hello Kitty作为全球文化偶像已逾50年。她诞生于1974年,并于1975年在一款小型乙烯基零钱包上首次商业亮相。多年来,其他熟悉的角色陆续登场,如今Sanrio的广阔宇宙包含450多个角色。 在Hello Kitty®和朋友们背后的公司Sanrio®, nakayoku 是 一条指导理念. 大致译为“大家和睦相处”,这一精神根植于这样一种信念:没有人能在孤立中茁壮成长,分享快乐让人们更加亲近。同样的精神贯穿于Figma。Figma一直是多人协作的,从浏览器中最早的共享光标,到如今在 画布上用代码 在画布上使用代码图层一起设计 今天,代码图层进入公开测试。现在,团队可以在画布上探索并构建由代码支持的原型。. 我们相信一起创造比独自创造更快乐,我们也发现跨设计与代码的协作能帮助人们 把想法推得更远 以设计构建:构建新方式的新工作流 以下是今天我们发布的一

    匹配字段正文

  8. Trail of Bits Blog精选

    Trail of Bits 用 Codex 为稳定版 Linux 回移安全补丁,已覆盖 149 个 CVE

    Trail of Bits 用 Codex 配合 GPT-5.6 为稳定版 Linux 内核和发行版回移安全补丁,截至 10 月 29 日已向稳定内核分支交付 149 个 CVE 的修复,另有若干 Fedora 和 Ubuntu 软件包修复。其流程由智能体识别缺失修复、适配补丁、组装验证证据、运行测试并准备提交材料,工程师负责审核并提交给维护者;不含项目初始配置时,一次简单回移约需 30 分钟人工投入,复杂情况约 3 小时。作者同时给出 Linux 内核各稳定分支及 Debian 13、Ubuntu 26.04 中已修复于新版本但未回移的 CVE 数量,并说明回归测试与维护者接受仍是必要环节。

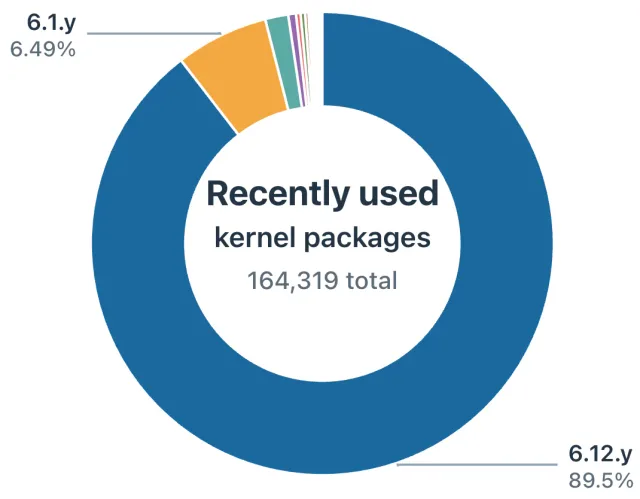
    “A Codex-generated graph of recently installed kernel packages from Debian’s popcon”

    使得一大类被忽视的安全工作变得切实可行。补丁积压量很大,但我们现在有了切实可行的方法来处理它。 我们必须在稳定性和安全性之间做出选择吗? 软件有错误,我们会在可能的时候尝试修复它们。修复首先发生在软件的最新版本中。不幸的是,这往往也是修复发生的 唯一 地方。 回移是将修复从最新源代码移植到较旧版本的过程。针对知名关键错误的修复确实往往会被快速回移。但对于许多其他错误,回移过程从未发生。原因很容易理解:软件打包通常由已经超负荷工作的志愿者完成,而回移是令人沮丧、不被感谢的工作,几乎得不到认可或关注。对于由志愿者团队运营的开源项目来说,回移(可以理解地)优先级很低。正如 XFS 开发者 Dave Chinner 曾经描述的那样,这项工作“ 实际上是一份全职工作”,在没有足够资源的情况下就是没人去做。缺乏回移是一个问题,因为几乎没有人运行用当今代码更改 freshly 构建的最新最好版本的软件。人们 绝大多数 更喜欢打包在“长期稳定”版本中的稍旧、经过更多测试的软件。例如, 大约 95% 的 Ubuntu Linux 安装是长期支持(LTS)版本。查看 Debian 的 popcon 中已安

    匹配字段正文

  9. 少数派

    派早报:Apple 智能将随 iOS 27.3 登陆中国,Claude Code 插件被植入后门

    苹果宣布 Apple 智能核心功能将于 12 月随 iOS 27.3 正式版面向中国用户推送,11 月 4 日先开放开发者测试,并确认与阿里巴巴合作接入千问大模型为 Siri、写作工具等提供支持。Cursor 扩展市场一款冒用 Anthropic 官方名义的 Claude Code 插件(版本 2.1.313)上架约 11 小时,波及多达 5000 名开发者,试图植入持久化 SSH 后门。Anthropic 称其内部系统与官方分发渠道未遭入侵。

    ,在部分体验中接入千问大模型,为 Siri、写作工具及视觉智能等功能提供文本与图像理解支持。 该功能支持 iPhone 16 及后续机型、iPhone Duo、iPhone Air 以及 iPhone 15 Pro 系列,设备与 Siri 语言须设为简体中文或英文。本轮更新不包含 WWDC 2026 宣布的下一代 Siri AI 功能,对 iPhone 以外其他平台的支持将在获得相关监管审批后推出。 之前不是说15 就开始支持吗 咋又改了 不知道欧盟那边的情况怎样。 也没见阿里股票涨,看来是已经拉完了 iPhone14表示,与我无关 看到有人说“狼来了”,海外版都那么拉,国内版能是一匹“狼”?全部讨论 10 苹果对闪存的议价权受到压制 据《华尔街日报》报道,受 AI 数据中心需求推动,全球闪存芯片价格过去一年飙升至原来的五倍,长期受苹果压价的闪存供应商迎来议价权反转。研究机构 TechInsights 预计,苹果 2026 年闪存采购支出将达 250 亿美元,而 2025 年采购同量闪存仅需 60 亿美元。 自 2005 年推出 iPod Nano 以来,苹果长期是全球最大闪存买家,能

    匹配字段正文

星期日

  1. Sakana AI:Blog

    Sakana AI 举办东京研讨会:Jürgen Schmidhuber 谈 AI 历程…

    Sakana AI 在东京一桥讲堂举办研讨会,宣布启动自研预训练语言模型系列「Sakana Sawara(暂定名)」,首个模型 Sawara Small(暂定名)计划于 2027 年春季发布。首席科学顾问 Jürgen Schmidhuber 发表主题演讲,与 CEO David Ha 对谈,活动吸引日本各地 400 余名参会者。Sakana AI 将 AI 主权规划为预训练、后训练与编排三大支柱,后两者分别对应 Sakana Namazu 与 Sakana Fugu。

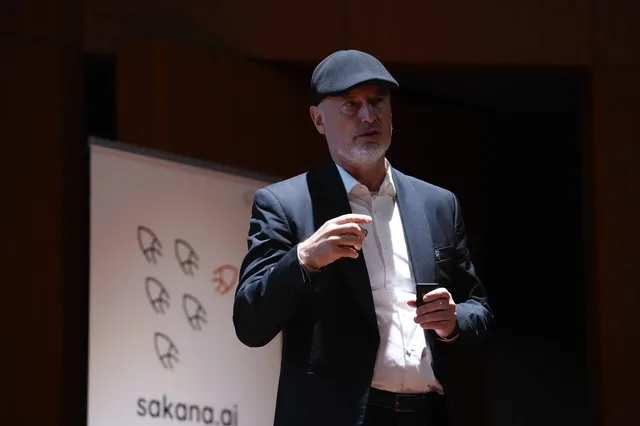
    na Sawara(暂定名) 发布新语言模型系列“Sakana Sawara(暂定名)”的秋叶拓哉 那么,RSI Lab接下来要做什么?今天要介绍的是新的语言模型系列“Sakana Sawara”。请注意这仍是暂定名称。 Sawara是我们从零开始构建的语言模型。此前的Namazu专注于对现有开放模型进行后训练,而Sawara将把工作扩展到预训练。由于不基于其他模型,我们可以管理包括训练数据和学习方法在内的模型的全部内容。此外,它从一开始就面向使用工具的推理、编程以及长时间任务等智能体用途进行设计。我们称之为“智能体原生”的语言模型。 Sawara有两个角色。一是作为Sakana AI产品和解决方案的基础。二是作为RSI研究的基础。能够掌握模型和配方的全部内容、所有过程对我们透明,这将使更广泛范围的RSI研究成为可能。 遗憾的是,Sawara仍在开发中,今天能讲的内容不多。因此今天我想谈谈自己对语言模型开发的看法及其战略。 Sawara的4个特征 语言模型开发是“研究的竞争” 这场竞争是使用更多GPU的竞争,这一点很多人都会同意。这100%正确。只不过,GPU往往被认为主要用于“规模”

    匹配字段正文

  2. TechCrunch AI

    数据中心成中期选举议题:布鲁克林活动现场几乎人人反对 AI 数据中心

    在 Newsreel 于布鲁克林举办的中期选举活动上,AI 与数据中心成为贯穿全场的话题,主持人问“谁支持 AI 数据中心”时现场直接响起嘘声。Data Center Watch 报告显示,2026 年上半年近 2000 亿美元数据中心项目因政治与社区反对而延期、停滞或被叫停,宾夕法尼亚、佐治亚、得州、纽约和弗吉尼亚等州正考虑加强监管与透明度。与会者担忧科技公司与地方官员私下交易、居民失去社区控制权,以及环境与健康风险。

    谈话,主题是“注意力的现状”;竞选管理软件Baraza的开发者阿里扬·兰詹则对中期选举做了预测。而我呢,主持了一场关于数据中心的专题讨论。 布鲁斯特说,活动的目标是让人们“放下手机,在选举前五天彼此聊聊选举”。 然而,随着夜晚推进,几乎每一场对话都被同一个话题占据:AI、数据中心,以及对日益膨胀的技术官僚统治的反感。 最近,作为一名科技记者,我注意到科技界与其他所有人之间的鸿沟越来越大。我大部分时间都在和那些看到AI好处的人交谈,他们如此热衷于构建AI,如此乐观地相信它会成功,以至于当我与科技圈之外的人交流时,我忘了这一切在他们眼中显得多么丑陋。在科技泡沫之外,数据中心和AI已经成为一个如此激烈的选票议题,以至于它们可能影响11月3日的一些中期选举选情。 数据中心观察组织最近的一份报告发现,由于政治和社区反对,2026年上半年有近2000亿美元的数据中心项目被延期、停滞或叫停。与此同时,宾夕法尼亚、佐治亚、得克萨斯、纽约和弗吉尼亚等州正在考虑对数据中心的快速扩张施加更多约束和透明度要求。仅弗吉尼亚一个州就计划新建数百个数据中心,而该州已经被称为“世界数据中心之都”。 就在我的专题讨论之

    匹配字段正文

  3. Databricks Blog

    Databricks 用 Lakebase 分支为每个 PR 建独立数据库的 CI/CD 实践

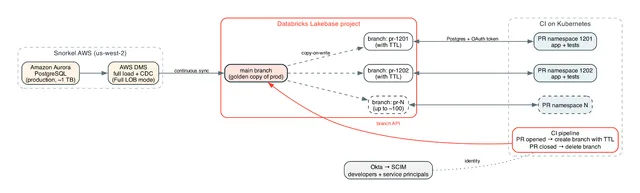
    Databricks 介绍 Snorkel AI 用 Lakebase 分支为每个开放 PR 创建独立可读写数据库的 CI/CD 方案,分支就绪时间从 30 分钟以上降到 60 秒以内。分支采用写时复制,约 2.5 TB 生产数据集上 100 个并发 PR 分支只额外存储各自改动的 5 至 10 GB 数据,并通过 TTL 在 PR 结束后自动清理。生产数据经 AWS DMS 持续同步到 main 分支,开发者用 Okta SSO 登录,CI 流水线以 service principal 和短期 OAuth token 鉴权。

    image1.png

    发者将分支部署到该命名空间,并在合并前运行完整测试套件。 这些测试在针对真实数据运行时最为有用。Snorkel 的生产数据库是一个 Amazon Aurora PostgreSQL 集群。为每个 PR 命名空间提供该数据库的独立副本才是难点所在。恢复一个副本每个环境大约需要 20 分钟,当开发者全天不断提交 PR、合并队列每次运行都需要全新环境时,这太慢了。其他替代方案(共享预发布数据库、裁剪后的测试夹具或合成数据)会重新带来类生产测试本应解决的问题:测试相互干扰、模式过期,以及只有在真实数据形态下才会出现的缺陷。 成功标准 如果满足以下标准,Snorkel 就会认为 Lakebase 在 CI/CD 场景中是成功的: 快速配置: 新的 PR 分支在 60 秒内就绪(p95)。 规模: 峰值时约 100 个并发 PR 分支,每个分支都有独立的读写能力。 兼容性: 现有应用和 CI 套件通过标准 Postgres 在 Lakebase 上运行,性能与 Aurora 相当,并支持大型 JSONB/LOB 列。 数据新鲜度: 通过持续的 DMS 复制,main 分支与生产 Aurora 的差

    匹配字段正文