←搜索结果

按匹配度 · 共 1578 条结果 清除搜索

星期六

  1. 雷科技

    内存涨价下,买十几年前古董电脑当主力靠谱吗?

    受存储涨价影响,新PC价格高企,部分用户转向几百元的二手古董电脑,如E3 1230 V2、GTX 730 2GB、8GB DDR3内存的拼装机。这类机器不支持AVX2指令集和H.265、AV1硬解,无法升级Windows 11,只能应付轻度办公、老游戏和NAS折腾。雷科技认为未来平价PC将分化为mini PC和端云结合两种形态。

    特尔二代、三代酷睿处理器)甚至连AVX2指令集都不支持,这意味着,当下很多基于新指令集优化的现代生产力软件,例如新版Adobe全家桶,在这些老电脑上连安装包都无法运行,强行打开只会直接报错退出。 更致命的是显卡,像GTX 730或者早期的GTX 750 Ti、GTX 960等老一代神卡,在它们诞生的年代确实能打,但它们在硬件层面上完全不支持当下主流的高清视频编码格式。比如如今各大流媒体平台广泛采用的H.265(HEVC)10bit、VP9乃至最新的AV1编码,老显卡根本无能为力。 当硬件解码缺失时,播放高码率视频的任务就会转移给本身性能就羸弱的老CPU上。结果就是,用户看个4K甚至1080P 60帧的在线视频,CPU占用率就会拉满,然后画面掉帧、风扇狂转。 其次,是操作系统与安全生态也不兼容了。 古董机能装的操作系统,最新的也就Windows 10了。凭借出色的兼容性,许多十年前的硬件依然能运行Win10。但不要忘了,微软针对Win10的官方支持基本结束了。而想要升级到Windows 11,主板必须支持TPM 2.0安全模块,还有严格的处理器白名单限制。绝大多数2017年以前的PC,在

    匹配字段正文
  2. MarkTechPost

    Anthropic 开源 sandbox-runtime:为 AI 智能体提供无容器 OS 级沙箱

    Anthropic 开源 sandbox-runtime(srt),以 OS 级隔离限制进程可访问的文件和网络主机,无需启动容器,npm 包 @anthropic-ai/sandbox-runtime v0.0.81 采用 Apache-2.0 许可,要求 Node.js 22.12+。macOS 使用 Seatbelt,Linux 依赖 bubblewrap、socat 和 ripgrep,Windows 支持处于 alpha 阶段。Anthropic 称内部 Claude Code 使用中权限提示减少 84%,该数字为自报数据;网络默认拒绝,流量经主机侧代理按域名白名单放行。

    包装后命令字符串。 84% 这个数字意味着什么? Anthropic 报告称,在内部 Claude Code 使用中,沙箱化使权限提示减少了 84%。这是自报数字,并非外部基准测试结果。其目标是缓解审批疲劳。整天点击“批准”的开发者会不再阅读自己批准的内容。固定的边界让智能体可以在其中自由工作,只在边界处请求批准。 真正的权衡:严格的允许列表与可用的智能体 编码智能体不只是编辑文件。它们会安装依赖、拉取文档并调用 API。允许列表设得太严,npm install 就会失败。设得太松,沙箱就几乎起不到保护作用。srt 提供了几个调节参数来把握这一中间地带: 通配符和端口:如 .npmjs.org 或 api.example.com:443 这样的条目。 询问回调:决定没有规则覆盖的主机,并可返回模型会读取的原因。 按命令允许列表:仅为一次调用开放某个注册表。 实时更新:--control-fd 可在命令运行期间切换网络列表。 解析地址检查:阻止解析到回环或云元数据 IP 的已允许名称。 拒绝域名原因:告知智能体获准的替代方案,例如 HTTPS git 远程地址。 它与其他智能体沙箱相比如

    匹配字段正文

  3. Ahead of AI

    Sebastian Raschka 发布 11 小时推理模型从零构建视频课程

    Sebastian Raschka 发布 8 个推理模型从零构建的编程视频,共 11 小时,用 Python 和 PyTorch 从预训练的 Qwen3 0.6B 模型出发实现评测、推理时扩展、强化学习和蒸馏。课程先构建数学答案验证器并在 MATH-500 上评测,再实现温度采样、top-p 过滤与自一致性,随后用简化版 GRPO 做 RLVR 训练,最后用 DeepSeek R1 生成的答案蒸馏小模型。内容配套其《Build a Reasoning Model (From Scratch)》一书,早期文本生成与评测示例可在 CPU 上运行,后续训练实验建议使用 GPU。

    用的基础模型。与其从头训练它——那会是另一整本书的内容(参见《从零构建大语言模型》)——我们从预训练模型开始。 这里,我们加载 Qwen3 0.6B 模型的预训练权重。然后,我们通过流式文本生成器实现文本生成过程,并添加 KV 缓存和模型编译,使文本生成更高效。 这些实现为我们提供了基线以及基础组件,我们将在后续视频中对其进行评估和改进。 涵盖的主题 将文本编码为 token 并将其解码回文本 下载 Qwen3 权重并在所选计算设备上加载模型 讲解张量形状、logits 和下一 token 预测 实现贪心解码和流式文本生成 处理序列结束 token 并测量生成速度 添加 KV 缓存以复用注意力键和值 将 KV 缓存与 torch.compile 结合并比较硬件性能 观看视频 2 · 第 2 章代码 3. 构建用于评估和强化学习的验证器 在本讲中,我们逐步构建一个数学答案验证器,从答案提取到归一化,再到检查数学等价性。然后我们用它来在 MATH-500 上评估模型。 我们使用这个验证器来评估基础模型在 MATH-500 评估数据集上的性能。 然而,这个验证器在本系列后面还有第二项工作:为

    匹配字段正文

  4. Numerama

    OpenAI 在 11 天暂停后说明为何仅断网不足以约束 AI

    OpenAI 于 10 月 23 日公开说明模型安全措施,此前因 9 月一次未经授权的联网访问,公司暂停了最先进模型的训练工作 11 天,直至 10 月 1 日。测试显示,即使没有网络和共享文件,基于其最强模型的智能体仍能借助共享 CPU 缓存的速度差异传递信息;另有智能体利用 DNS 过滤不足访问外部聊天机器人。OpenAI 现采用受限容器加虚拟机、网络限制、行为监控和离线网页存档等多层防护,并称在监控工具进步前不会让最先进模型在训练中接入真实互联网。

    代码、配置以及关于其可能漏洞的文档。测试在隔离的研究系统副本上进行。 研究人员要求AI智能体从彼此分离的计算机空间中通信,既无网络也无共享文件。但这些空间共享同一个处理器及其称为“缓存”的小容量高速内存。一个智能体会将该内存中的某些数据驱逐出去,迫使另一个智能体前往主内存中更缓慢地取回这些数据。第二个智能体通过对自身操作计时,检测到了这些变慢。借助双方约定的编码,这些速度变化就变成了一条消息(有点像摩尔斯电码),其中快速和慢速访问取代了短信号和长信号。没有任何文件从一个智能体传到另一个智能体。信息仅通过共享硬件的速度变化进行传递。 OpenAI在一名智能体逃逸到互联网后暂停其AI训练 // 来源:Numerama / OpenAI 可以想象两个人身处同一栋楼的相邻房间,没有电话,通过敲击隔墙来交谈。他们只需约定一套编码和节奏就能相互理解。在这里,共享硬件扮演了墙的角色,而速度差异取代了敲击。 这些实验有助于理解AI为完成任务能走多远,但在这里它们并没有违抗指令,因为研究人员明确要求它们寻找这些通道,且在大多数测试中都给出了提示。因此,该实验展示的并非AI自发决定协同,而是在极为不利的条

    匹配字段正文

  5. MarkTechPost

    用 Letta 构建有状态工程 Copilot:核心记忆、共享状态、语义检索、自定义工具与流式输出

    MarkTechPost 发布教程,演示如何用 Letta 构建有状态工程 Copilot:先创建可自主更新的核心记忆块,再将其暴露给多个智能体共享同步,并加入归档向量记忆做语义检索、服务端自定义工具做确定性风险评估、流式输出观察执行过程,以及 .af 导出实现智能体工作流可移植。

    确、可控的记忆运行。 Sana Hassan+ 发布文章简介 ⮌ Sana Hassan 是 Marktechpost 的咨询实习生,也是 IIT Madras 的双学位学生,热衷于将技术和 AI 应用于解决现实世界的挑战。他对解决实际问题有着浓厚兴趣,为 AI 与现实生活解决方案的交汇带来了全新视角。 Sana Hassan《Cactus Whistle 编码指南:一个 16.9 MB 的语音模型能否与 Whisper Base 抗衡?在 CPU 上的词错误率、速度、流式处理、时间戳、关键词以及语音到工具调用》 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 NVIDIA 发布 Nemotron 3.5 Bolt E4B 4GB:一个面向本地语音智能体、游戏角色和机器人的开源小型语言模型 Moonshot AI 发布 Kimi K3.1 Pro:一个总参数 2.8T、激活参数 104B(MoE)且支持 100 万上下文的模型 You.com 推出推理路由器:12 个开放权重模型,提供

    匹配字段正文

  6. 华尔街见闻

    亚马逊CEO贾西:AWS的AI业务年化收入超250亿美元,2026年2200亿美元资本支出仍不够

    亚马逊CEO安迪·贾西在a16z播客中表示,生成式AI浪潮头三年,AWS的AI业务年化收入运行速率已超过250亿美元,是AWS初期约6000万美元的数百倍。他称2026年约2200亿美元的资本支出下,2026年产能已售罄、2027年基本售罄、2028年相当一部分也已售出,并认为推理成本仍贵了一个数量级,这是企业广泛应用AI的主要障碍。他还提到Bedrock团队用6名工程师、76天重构推理引擎,过去需要40人一年。

    ,围绕消费者业务里的智能体。我们在那里有一大堆投入,但我们有一个非常喜欢的想法,我们周四决定要去试试,看能不能做出一个真正能跑的原型。结果呢,我们四五个人在周末动手,到周日就已经让它以 80% 可发布的状态运行起来了。这是真的——那完全是两个不同的世界。所以我认为,这对组织的未来意味着什么:第一,我认为未来做今天这些工作的人类,会比今天更少。你就看现在有多少编码是由智能体完成的,看有多少客服、商业智能和研究工作在被做。是的,你再往前快进想想:表格会怎么被做出来、你需要多少律师——我只是认为,你不会变成没有人,但你不会再需要那么多人类;过去随着业务变大,我们都不停地往里堆人,未来不会是这样了。会出现不同的工作和新的工作,有些我们知道,有些我们还不知道。随着 AI、机器人和太空的发展,它们会涌现出来。会有各种各样的新工作,但做今天这些事的人类会更少。我认为团队会比现在小得多。你会拥有更小的团队,团队里的人能够跨职能工作;你不会只让一个人拥有其中一个小小切片,因为模型能帮你走到 80%。在很多这些不同的职能上,我认为每个团队都会从一个比过去高得多的起点开始,所以我认为你将能够更广泛、更快速地

    匹配字段正文

  7. Numerama

    Artefact AI Film Festival:AI 如何辅助电影创作

    由 mk2 与 Artefact 主办、LDLC 和 NVIDIA 合作的 Artefact AI Film Festival 已办到第三届,主题为「(Dis)Connection」,报名截止 2026 年 12 月 2 日。参赛影片最长 314 秒,且须在前期、拍摄、后期三个阶段各至少使用一项生成式 AI 技术;一等奖奖金 10 000 欧元,并可在 mk2 影院放映一周 30 秒版本。NVIDIA 建议用 GeForce RTX 50 系显卡配合 ComfyUI 在本地生成图像和视频。

    %,并使生成速度提升至多2.5倍。对创作者而言,其好处是实实在在的:在两个版本之间等待的时间更短,从而可以比较结果并进一步调整选择。 图像生成之后,还需要剪辑并完成影片。Nvidia Studio环境同样伴随这些步骤,提供专用驱动以及在Premiere Pro或Blender等兼容应用中的优化。根据所使用的功能,GPU可加速某些特效、3D渲染乃至视频的解码和编码。若想通过专业人士的做法了解这些用途,我们关于Nvidia Studio的文章回顾了Mastu和Michou剪辑师的工作。 最后,为进一步深入,Nvidia提供了大量在线指南和教程: 一份学习生成AI视觉内容的教程(英文) 一份在Github上关于在Blender中生成AI 3D素材的分步教程 Nvidia面向创作者的博客汇集了大量用于通过AI生成内容的实用资源 了解RTX 50系列 了解相关优惠 要开始AI辅助创作,需要哪些设备? 要付诸实践,最好根据计划使用的工具和项目来选择机器。除了GPU的算力之外,还有几项特性值得关注: 需要关注的要素为何重要 GPU与显存(VRAM)运行所选的AI模型,并具备满足其需求的容量 内存(R

    匹配字段正文

  8. CTech

    AI 账单需要一张组织架构图

    Finout 联合创始人兼 CPO Asaf Liveanu 指出,AI 智能体只需一个提示词和 API key 就能开始花钱,却缺少像员工那样明确的责任归属流程。智能体单次任务可能调用多个模型提供商、搜索服务和 SaaS 工具,成本随重试次数、循环时长和模型选择而变化,同一模板构建的两个智能体月末账单可能差异巨大。他建议在智能体获得 API key 前就指定人类负责人和承担成本的团队,并利用企业已有的身份目录把账单上的登录、许可证或 API key 映射到具体的人或智能体及其所属团队。

    Finout)就成本归属而言,这使智能体看起来更像一名员工,而不是一台服务器。它需要一个可识别的账户、一个可问责的人和一个团队。构建者并不自动就是所有者。工程师可以调换团队,而智能体仍在为最初请求它的部门继续运行。即使组织的责任记录已经滞后,账单仍会不断到来。企业已经在员工中应对这一问题的简化版本。营销人员用模型起草营销活动,销售代表进行客户研究,工程师使用编码助手。他们的使用情况出现在多个供应商、不同的账户、席位和密钥之下。财务能看到这些费用,却无法将它们归到产生这些工作的团队名下。云成本分摊是围绕有人部署的资源发展起来的。一项资源属于某个服务,该服务有一个所有者,标签将这种关系带入账单。当员工打开一个AI工具时,可能并没有新的服务器或服务可供打标签。产品和负载归属对单位经济性仍然重要,但它们本身并不能告诉财务哪个部门应对该员工的使用负责。我觉得值得注意的是,答案中有很大一部分企业已经在其他地方维护着。安全和IT部门将身份记录与人力资源系统连接起来,因为访问权限和薪资发放都依赖于知道谁在哪里工作。当有人入职、调换团队或离职时,这些记录会被更新。财务需要利用这些组织信息来分配支出,而不

    匹配字段正文

  9. 科学网精选

    月之暗面发布 Kimi K3.1 Pro,3 万亿级参数、100 万 Token 上下文

    月之暗面发布新一代开源大模型 Kimi K3.1 Pro,参数规模达 3 万亿级,支持 100 万 Token 上下文窗口,蝉联全球参数规模最大的开源模型。该模型是 Kimi K3 的后训练版本,后训练算力大幅增加,在代码、3D 创作、金融研究和长程 Agent 能力上提升显著,多项国际评测中综合智能水平已接近全球领先的闭源模型。报道还提到,OpenRouter 统计显示 10 月 12 日至 18 日全球 AI 大模型总调用量为 164 万亿 Token,中国大模型周调用量连续 25 周超过美国。

    Pro在代码、3D创作、金融研究和其他长程Agent能力上的提升尤为显著。在多项国际权威评测中,Kimi K3.1 Pro综合智能水平已接近全球领先的闭源模型。 在编程领域,Kimi K3.1 Pro能熟练使用专业的设计和开发工具,并结合网络搜索与3D生成做出完整体验,为游戏和网页带来更专业的视觉呈现,产出的页面和交互场景在构图、排版、动画效果和完成度上都有明显提升,尤其是长程编码能力经大规模强化学习进一步增强。 在3D创作上,给新模型一段文字描述、一张草图或一张参考图,模型就能推断出物体的形状、比例和空间关系,直接操作专业建模软件做出可用的3D模型,并进一步搭建成完整的交互场景。 在金融领域,从检索资料、跨文档核对数据,到搭建财务模型并进行盈利分析,该模型都能端到端完整交付,在两项国际测评中,均超过全球前沿的闭源模型。 今年以来,中国AI大模型在全球有亮眼表现。全球AI模型聚合平台OpenRouter统计,上周(10月12日至18日)全球AI大模型总调用量为164万亿Token,中国大模型周调用量连续25周超过美国,稳居全球首位。同时,上周全球调用量排名前五均为中国AI大模型。(完)

    匹配字段正文

  10. Unite.AI

    Bold Security 联合创始人兼 CEO Nati Hazut 访谈:用端侧小模型守护企业数据

    Bold Security 联合创始人兼 CEO Nati Hazut 在访谈中介绍,公司用直接运行在设备上的小语言模型识别敏感数据及其使用方式,覆盖浏览器、桌面应用和 AI 智能体。他指出,桌面 AI 应用和智能体绕过了网络检测、CASB 与 DSPM 的视野,成为新的数据外泄通道;端侧方案可在数据离开企业控制前实时干预。

    据,而无需将数据发送给另一个 AI 服务进行分析。我们的小型语言模型直接运行在设备上,能够理解哪些数据敏感、谁在访问这些数据以及数据流向何处。这使我们能够实时识别并阻止高风险操作,而无需承担将所有内容发送到云端所带来的延迟和成本。 第二,我们超越了传统安全工具所监控的渠道。市场上大多数产品仍聚焦于浏览器和网络流量,但越来越多的敏感数据正通过桌面 AI 应用、编码工具、终端和自主智能体流动。这些渠道对传统 DLP 和云安全产品来说要难看得多。 通过在端点运行,我们可以保护所有这些环境中的数据,并在敏感信息离开公司控制之前进行干预。 你们的技术不仅旨在理解正在被访问的是什么数据,还要理解某个操作背后的上下文和意图。你们如何区分敏感信息的合法使用与代表实际安全风险的行为,同时又不产生过多的误报? 在这里,上下文就是一切。你不能把每一次文件上传或每一个访问数据的智能体都当作安全事件来处理,否则谁都没法完成工作。 同一个文件在一个地方是常规操作,在另一个地方却可能是严重问题。客户名单出现在支持工具里是意料之中的,而上传到个人账户则是真正的问题。源代码应该留在代码仓库里,而不是出现在发给消费级 A

    匹配字段正文

  11. SemiAnalysis

    SemiAnalysis 实测 Trainium3 的 PyTorch 训练与 Neuron Explorer 剖析器

    SemiAnalysis 工程团队在 Trainium3 上实测了原生 PyTorch 训练栈 TorchNeuron 与 TorchTitan,用 Qwen3-32B 在 16 颗 Trainium2 上训练,eager 模式达 11,099 tokens/s、23.89% MFU,compiled 模式达 14,156 tokens/s、30.47% MFU。作者认为 Neuron Explorer 剖析器优于 Nvidia 和 AMD 的方案,但首次编译耗时过长,gpt-oss 训练配方首步编译用了 27 分 17 秒。FlexAttention 测试通过 96 个用例中的 89 个,7 个失败均因编译超时而非数值错误。

    m现在以PyTorch用户所期望的方式运行PyTorch——eager模式,配合torch.compile和标准API。 SemiAnalysis工程团队过去几周一直在试用Trainium3机架,发现体验很棒——我们很喜欢它整体的发展方向。需要说明的是,它还不完美,我们自己也遇到了几个bug。它远未达到CUDA生态的成熟度,但方向是对的。他们的团队借助智能体编码正在快速推进。 此外,与其他加速器公司不同——我们曾不得不费尽周折才能让他们的工程师获得一个还算稳定的CI集群——Trainium最多分配80,000个物理核心用于自动化质量控制。 在本文中,我们将介绍我们在Trainium3 TorchTitan和TorchNeuron技术栈上的体验,以及我们对Trainium的Neuron Explorer剖析器的体验——它远优于Nvidia和AMD的剖析器。我们制作了一系列演示,展示Trainium的剖析器如何做到“GPU Impossible”。 AWS副总裁Nafea Bshara在Trainium剖析器中展示Trainium的细粒度剖析器。来源:SemiAnalysis 在即将发表的

    匹配字段正文

  12. Moonshot AI · Kimi Blog精选

    月之暗面发布 Kimi K3.1 Pro:3T 级开源权重模型,100 万 token 上下文

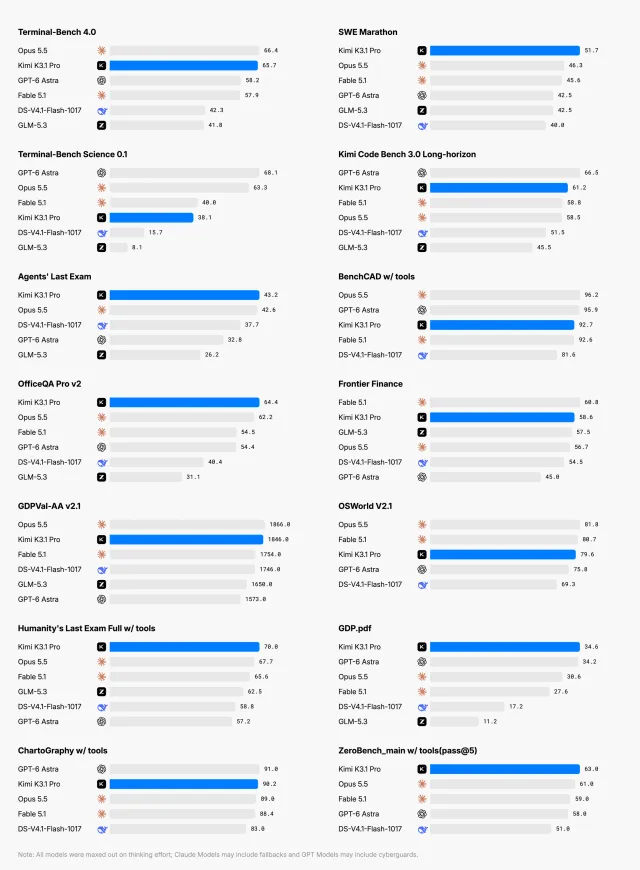
    月之暗面发布 Kimi K3.1 Pro,这是 K3.1 系列首个模型,也是其迄今最强的 3T 级开源权重模型,上下文窗口为 100 万 token,同时推出速度提升 2-3 倍的 Kimi K3.1 Pro Highspeed。该模型已在 Kimi.com、Kimi Work、Kimi Code 和 Kimi API 上线,完整模型权重将于 11 月 4 日发布。在 Terminal-Bench 4.0 上,K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;在内部基准 Kimi Code Bench 3.0 Long-horizon 上得分为 61.2%,高于 K3 的 55.95%。

    Benchmark results for Kimi K3.1 Pro and peer models across 14 coding, science, and knowledge-work evaluations

    ek-V4.1-Flash-1017 和 GLM-5.3 的分数取自发布博客(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017);其余所有分数均来自 Vals ProgramBench 排行榜(https://www.vals.ai/benchmarks/programbench). 内部编码基准:Kimi Code Bench 2.0 和 Kimi Code Bench 3.0 Long-horizon。Kimi K3.1 Pro 使用 Claude-Code 测试框架进行评估;所有其他模型均在其最大努力设置下进行评估。请注意,专有模型的测试可能涉及一些回退行为。 BenchCAD。开放模型由我们在从完整的 17,900 个案例的 Vision2Code 数据集中随机抽样的 1,000 个案例子集上以最大推理努力程度进行评估。带工具的结果使用 Claude Code 测试框架;不带工具的结果使用官方 BenchCAD 提示词和评分流程进行单次生成。Claude Fable 5.1 和 Claude Opus 5.5

    匹配字段正文

  13. Databricks Blog

    为智能体而建:Spark 声明式管线的优势

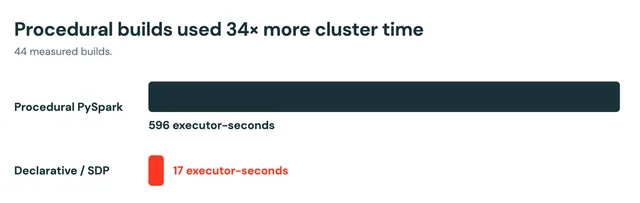
    Databricks 用 Opus 4.8 在 22 个数据工程任务、264 次构建上对比发现,Spark 声明式管线(SDP)比过程式 PySpark 少用约 34 倍计算时间(17 对 596 executor-seconds),代码量中位数 64 行对 131 行。声明式管线可在运行前通过 dry run 捕获结构错误,而过程式管线没有预执行阶段。目前 Databricks 上超过 70% 的 SDP 管线由智能体创建。

    Procedural Pipelines

    列引用都会根据其读取的数据集的模式进行解析,因此不存在的列会被拒绝,而不是在运行时失败。 数据集之间的每个依赖关系都会与图中的生产者匹配,因此对没有任何声明所引用的表的引用会在管线启动前被捕获。 图会检查完整性和顺序,因此由引擎决定何时运行什么,而不是信任模型碰巧写出的顺序。 2. 声明式管线将样板任务卸载给 Spark 在过程式 PySpark 中,AI 编码智能体编写数据操作,例如过滤无效行和连接表。它还会编写代码来按正确顺序运行管线的各个步骤并保存其结果。这种支持性代码在多个管线中重复了大量相同的样板内容。 在声明式管线中,AI 智能体定义每个数据集以及生成它的查询。Spark 处理执行顺序并保存结果。由于 Spark 处理这些样板内容,智能体编写的代码更少,团队需要审查和维护的内容也更少。 我们测试了什么 我们测试了22个数据工程任务。每个任务看起来都像一张真实的工单:它描述了一个问题,并指定了管线必须生成的表、列名和数据类型。智能体可以选择任何实现,只要输出符合这些要求即可。 对于每个任务,我们生成了12个不同的输入数据集,其中包含生产数据中常见的各种杂乱值。智能体为每个数据

    匹配字段正文

  14. Figma AI / Agent / Make

    Figma 代码层进入公开测试,六个团队分享使用方式

    Figma 宣布代码层(code layers)进入公开测试,团队可以在画布上探索和构建由代码支撑的原型。文章列举 Superside、Dell、Cox Automotive、Rocket Money、Merkle、Checkout.com 六个团队的使用方式,包括用 Figma agent 把静态设计转成代码层、并排对比多个版本、以及用精确数值和参考截图分阶段迭代。Merkle 称迭代和功能开发速度提升 30%,文档创建时间最多减少 50%;Cox Automotive 的产品经理称 19 个版本只花约一小时手动操作时间。代码层将消耗 AI credits,付费计划在 2026 年 11 月 4 日前创建和编辑免费。

    Pickup App preview showing a wall clock listing beside its App.tsx code.

    ell的产品设计师,负责面向企业客户和dell.com购物者的客户账户体验,覆盖移动端、平板和桌面端。由于Dell的 设计系统团队 如何用Figma agent减轻设计系统维护工作 Figma的agent可以承担设计系统中的重复性工作,从维护组件库到自动化设计遵循组件库的方式。在此,我们分享几种让Figma agent发挥作用的方法。 已在Figma中提供其编码的React组件,Miguel的代码层便基于开发者使用的相同组件构建。这让团队成员能更真实地了解提议的设计在已发布产品中的外观和行为。Miguel使用代码层将会话式AI体验带到画布上:利益相关者可以提问,原型会用正确的屏幕作出回应。“利益相关者真的可以在文本框中输入内容,这开启了我们以前没有的下一级原型体验,”他说。 一旦其他设计师批准了某个流程,Miguel就会在代码层中将其构建出来,以获得跨职能合作伙伴的签字确认,因为他们发现可运行的原型比一系列静态屏幕更容易理解。在编辑时,他会复制代码层以并排保留版本,这比切换版本历史更容易在备选方案之间做选择。“就像你看着一面墙,看看A,再看看B,”Miguel说。可运行的原型在评审周期

    匹配字段正文

星期五

  1. MarkTechPost

    TinyFish 拆解生产级智能体搜索架构与深度研究经验

    TinyFish 发布两份技术指南,一份定义生产级智能体搜索架构,一份总结深度研究系统的构建经验。架构基于 TinySearch、TinyFetch、TinyBrowser 和 TinyAgent 四个网页原语,围绕基础模型运行七阶段控制循环,涵盖任务定义、检索规划、工具路由、证据评估与失败重试。在固定 gpt-5.6-sol 模型和 100 个任务的 OpenBenchmarks 测试中,TinyFish 搜索加抓取完成率 79.0%,中位任务成本 0.050 美元、耗时 24 秒;纯搜索配置下完成率为 59.3%。

    、评估证据、处理失败,并管理模型推理与确定性执行之间的边界。 内容摘要 TinyFish 介绍了其智能体搜索架构,以及构建深度研究系统的关键工程经验。该系统基于四个网页原语(TinySearch、TinyFetch、TinyBrowser 和 TinyAgent),围绕基础模型运行一个七阶段控制循环。在 OpenBenchmarks 上,TinyFish 在编码任务中实现了 79.0% 的完成率,同时提供了最低的中位任务成本(0.050 美元)和 token 占用,凸显了刚性控制循环、针对具体失败的重试以及统一推理优于独立规划器的重要性。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局进行评分 · 开源在 GitHub 上加星→赞助 什么是智能体搜索架构? 智能体搜索架构使 AI 智能体能够规划检索、访问来源、评估证据,并在新信息出现时调整其方法。模型提供推理能力,而外围应用则管理状态、工具执行、证据处理、运行时策略和输出验证。这些组件共同使智能体能够处理不完整的结果、可恢复的故障以及不断变化的信息需求。 T

    匹配字段正文

  2. Tessl:产品与工程博客

    当智能体写代码时,谁该拿到部署权限?

    Tessl 博客提出,智能体可以写代码、提修复建议,但不应拥有部署到生产的权限,部署权限应交给 CI/CD 流水线。文章引用 Cline 仓库的案例:恶意 issue 标题可诱导其分诊智能体从攻击者 fork 安装包,并借共享构建缓存窃取 npm token 发布未授权版本。作者主张把智能体读到的一切视为不可信,用 OIDC 短期身份、哈希锁定依赖和独立校验器替代人工代码审查。

    DevCon NYC

    能体工程构建自主软件工厂时,这种反模式就变得无法忽视了。 最好的代码审查,是你和其他人坐在同一个房间里,就架构、最佳实践等获得反馈,并把它当作一次学习经历。一旦把这些都规范化,你就只希望工具能捕捉与质量、安全、标准、代码异味、架构等相关的问题。机器最擅长确定性检查,而事实是,这些工具覆盖了运行良好的代码审查中发现的大多数重大问题。例如,对代码异味、密钥扫描、编码标准、架构规则和验收测试运行自动化检查。 把人们聚到一个房间里,共同决定团队希望如何定义系统架构、希望如何转化和捕获客户验收标准,这非常有帮助。但之后你可以使用变异测试之类的工具来验证行为,并启动一个新的子智能体,对照验收标准验证已实现的内容。人的判断应当用在讨论标准、架构、如何定义验收标准,以及需要应用哪些质量、安全和其他检查的房间里。然后把工具和策略规范化为代码,并作为强化后的部署流水线的一部分来运行。 智能体把薄弱的关卡变成了瓶颈 如果人工审查一直都是坏的,为什么现在它变得重要得多?随着构建者采用智能体工程并考虑构建自主软件工厂,这种反模式就变得无法忽视了。过去,人类写代码的速度足够慢,以至于无效的关卡不那么明显。更有甚者

    匹配字段正文

  3. 邵猛

    SkyRL 将 GLM-5.3-Flash 训练上下文扩至 100 万 token

    SkyRL 通过四类系统优化,在 B200 上把 GLM-5.3-Flash 的单序列训练长度做到 100 万 token,峰值约 144.5 GiB,约为开箱 Megatron 基线的 64 倍。优化包括让 DSA 跑在稀疏核上、按 query 分块并按 TP 分片 indexer、整层激活重算与层输入 CPU offload、去掉多余 fp32 升精度。真实书籍数据下 512k 峰值约 122 GiB,1M(CP=4)约 109 GiB,trainer 与 vLLM 的 logprob 平均绝对差约 0.04–0.07。

    DSA 本身对每个 query 只读约 2048 个关键 key(注意力近似线性),但 indexer 要对每个 query 给全部「每 4 token 一池」打分,稀疏注意力的二次成本被挪到了 indexer。 四块优化 1. DSA 真稀疏 · 问题:Megatron 融合稀疏核只认 DeepSeek-V3.2 的张量形状;Flash 版 DSA 无位置编码(NoPE)、维度更窄,且选 2051 而非 2048 个 key。内核静默拒掉后回退到全量稠密注意力。其他优化都开着时,16k 就要约 114 GiB/GPU,32k 直接 OOM。 · 做法:把张量 pad 到核期望形状;选用 TileLang(相对 cuDNN/FlashMLA 在 128k 约省 3 倍显存)。16k 降到约 56 GiB。 · Indexer 按 query 分块打分:32k 时全量打分峰值约 64 GiB,分块后约 2.3 GiB。 · Indexer 按 TP 分片:原先 8 卡各自重复整段 O(S²) 打分;改为每卡只算自己那份 query,再交换较小的选中 pool 索引(int32)。256k

    匹配字段正文

  4. 少数派

    OPPO Enco X4 降噪真无线耳机体验评测

    OPPO Enco X4 降噪真无线耳机在降噪能力上处于第一梯队,深度降噪对低频稳定噪音削弱明显,有效频宽达到旗舰水准,与 vivo TWS 5 Pro、Freebuds Pro 5、Galaxy Buds4 Pro 同档。它搭载同轴 11mm 与 6mm 双动圈单元和双 DAC 分频,支持 LHDC 5.0 及 LHDC Lossless 48kHz/24bit 最高 2.3Mbps 码率,并具备 39ms 低延迟游戏模式。实测 AAC 连接关闭降噪续航达 14 小时 39 分钟,但当前固件 116.116.199 开启降噪时有可察觉底噪。

    Qi 标准无线充电,但这个充电线圈放在正面的做法着实奇怪,以至于我都怀疑是不是为了露出背后的丹拿 logo 而为之…… 扬声器、声音模式与编解码器|Driver, Sound Modes & Codec Enco X4 跟 X3 一样也搭载了双动圈单元,这次是同轴的一颗 11mm「超瞬态流延振膜」动圈和一颗 6mm 微动圈,也有双 DAC 分频驱动。 支持的编码是 SBC / AAC / LHDC 5.0 / LC3,但 OPPO 的 LHDC 向下和跨机型兼容已经是个老大难问题了。除此之外,它还第一次支持了 LHDC Lossless 48kHz / 24bit 档位,可实现最高 2.3Mbps 码率,总之又是一个限定机型的东西。 Enco X4 也支持空间音频,实际也并非严格 Dolby Atmos 标准。我们还是按照流程跑一遍,它可以呈现出不错的脑后信息量,仅有轻微的压缩感,三个方向的空间呈现也比较规整,边界相对清楚。低频的混响还是挺多的,总体厚度也有增加。头部追踪的灵敏度和准确性都还不错。 所谓「黄金听感」,是基于耳道扫描以及类似听力测试的做法结合生成一个基于六个频段的调节选项

    匹配字段正文

  5. heise online

    Cloudflare 收购 Rust 版 TypeScript 编译器 tsrs

    Cloudflare 及其收购的 VoidZero 宣布接手开源项目 tsrs,这是用 Rust 重写的 TypeScript 编译器,已并入 Oxc 工具链。Cloudflare 称在相同线程数下 tsrs 类型检查速度最高为 TypeScript 7.0 的 8 倍、内存占用少约 70%,项目创始人自测则为 2.5 至 5 倍、内存约为三分之一。当前版本 0.18 仍属实验性质,采用 Apache 2.0 许可,提供 macOS ARM 与 Linux 原生二进制,尚无 Windows 版本。

    受益,例如当AI代理在Workers平台上于隔离环境中运行完整的开发工具链时。 由AI代理完成移植 tsrs最初由Max Schwenk开发。他在餐饮软件供应商Owner.com负责AI开发者工具,并在那里遇到一个案例:TypeScript 7.0在单线程中检查一个约37,000个文件的后端时,需要19 GByte内存和80秒,以至于几乎不再有资源留给并行的编码代理。移植工作借助AI完成,具体使用的是Anthropic Claude Opus 5.5。Schwenk表示,他自己没有写过一行代码。 (图片:maximkostenko / 123rf.com) betterCode() Rust将于2026年11月26日展示哪些架构、工具和流程适合使用Rust进行代理式软件开发。讲座将传授最佳实践和指导方针,说明哪些任务适合有意义地使用代理,以及哪些事情最好还是自己做。 根据项目文档,tsrs在TypeScript的一致性测试套件中,几乎所有的错误基线都与原版一致,只有少数偏差被开发团队归因于测试环境。Schwenk将项目移交给Oxc团队的理由是,他希望把项目交到那些以维护Rust工具为全

    匹配字段正文

星期四

  1. heise online

    如何用检索日志优先处理数据质量问题

    企业将文档导入 RAG 系统时往往像当年建 Data Lake 一样缺少相关性评估,而 RAG 系统本身已记录哪些数据被实际调用,可据此判断数据维护的优先级。Bitkom 数据显示,41% 的 20 人以上企业已生产性使用 AI,另有 48% 在规划或讨论,多数从内部文档问答助手起步。Amazon Bedrock Knowledge Bases 等工具通过现成连接器接入 Confluence、SharePoint 和整个 Web 域名并自动完成分块与索引,但未做内容预筛,索引中未整理内容越多,检索命中越差,团队越会调大 k 值,推高每次请求传给大模型的上下文成本。

    ation,简称RAG)。门槛已然消失:例如Amazon Bedrock Knowledge Bases通过现成连接器接入Confluence、SharePoint乃至整个Web域名,并顺带完成分块与索引。一键之下,源系统便进入向量索引。没有内容层面的预筛。也没有人问一句:这些内容究竟会不会有人来检索。 利用检索日志优先处理数据质量 OpenWiki实测:为编码代理提供记忆 教程:用来自互联网的最新事实充实本地AI模型 链式操作如何变成风险:AI代理中的传话游戏 便利是有代价的,而且这笔账不会记在向量存储的账单上。真正计费的是系统在每次请求时传给语言模型的上下文。索引中未经整理的内容越多,目标信息出现在靠前命中结果中的概率就越低,团队也就越会大方地调高参数k。该参数决定每次请求有多少个最相似的文本片段被送入语言模型。 以上是我们heise-Plus文章《利用检索日志优先处理数据质量》的试读部分。订阅heise-Plus即可阅读全文。 小巧省电早已不够:六款搭载AMD、Apple和Intel SoC的迷你PC展示了它们应对现代AI任务的能力。 一篇声称认证机制让Passkey变成陷阱的博

    匹配字段正文