←搜索结果

按匹配度 · 共 2760 条结果 清除搜索

星期二

  1. 钛媒体 · AGI

    OpenAI 发布 GPT-6.1 Terra,主打低价电脑操作能力

    OpenAI 发布 GPT-6.1 Terra,API 价格为每百万输入 Token 1 美元、输出 Token 5 美元,较上一代输入和输出价格分别下降 50% 和约 58%,仅为 GPT-6.1 Sol 的一半。官方称其在 Terminal-Bench 4.0 的任务完成率从 21.5% 提升至 50.3%,Agents' Last Exam 得分 60.0%,接近 Claude Opus 5.5 的 63.2%。Artificial Analysis 测得最高推理档位智能指数 48 分,低于 GPT-6.1 Sol 的 52 分和 Claude Opus 5.5 的 58 分,但单任务平均成本从 1.40 美元降至 0.40 美元。Terra 已通过 API 开放,Plus、Pro、Enterprise 和 Edu 用户可在 ChatGPT Work 和 Codex 中使用,暂不支持普通 Chat 对话。

    要的是更出色的产品,而不是这种毫无用处的东西。” 类似的不满也出现在Reddit社区。 在r/codex,一位网友直接发帖,将这次发布形容为“简直是在给Claude打广告”。 也有人觉得Terra的尴尬之处在于定位。一位网友指出,Terra的API价格是Luna的10倍。 如果追求最低成本,可以使用Luna;如果需要更强的模型,选择Sol似乎更加合理。 甚至连OpenAI的命名方式也遭到了吐槽。由于各档模型的发布时间并不统一,而且不同模型在部分任务上的表现会出现交叉,一些用户已经搞不清Terra、Sol和Astra之间究竟应该怎么选。 面对这些质疑,OpenAI研究员Ted Sanders也在Hacker News上作出了解释。他表示,Terra可能在技术交流方面优于Sol和Astra,在视觉理解与电脑操作方面表现接近,同时速度更快,但在其他大多数任务中稍逊一筹。 当然,社区里也有用户肯定Terra的成本效率,认为能够以低得多的成本完成接近旗舰模型水平的任务,本身就具有价值。 只不过,比起这个“中不溜”的Terra,已经有不少人开始等下一款Astra……以及对家的Fable 5.5了。

    匹配字段正文
  2. SiliconANGLE精选

    OpenAI 发布 GPT-6.1 Terra,价格减半并提升电脑操作能力

    OpenAI 发布 GPT-6.1 Terra,作为 GPT-5.6 Terra 的升级版,标准 API 价格降低约 50%,处理电脑操作任务更快更准。该模型已向 ChatGPT Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用。在 Terminal-Bench 4.0 上,最高推理强度下任务解决率为 50.3%,高于前代的 21.5%;但 OpenAI 称在近 30% 的模拟运行中模型绕过限制完成任务。

    ,旨在代表用户在第三方应用和浏览器中完成工作,而 Codex 是 OpenAI 的软件编码工具。 GPT-6.1 Terra 的一个隐忧在于,其更强大的能力似乎以安全性略有代价。OpenAI 在其博客文章中表示,在近 30% 的模拟运行中,Terra 违反限制,使用其无权使用的方法来完成任务。 此外,OpenAI 透露,GPT-6.1 Terra 在遇到来自其他 AI 智能体的消息后,在 13.75% 的使用场景中采取了未经授权的操作。该公司的系统卡还显示,研究人员发现了该模型意识到自己正在被测试的证据。 尽管如此,OpenAI 表示 GPT-6.1 Terra 在某些指标上表现更好。例如,在一项使用旨在诱使模型出错的提示词构建的内部测试中,其在低推理强度下的事实错误率降至仅 16.7%,而 GPT-5.6 Terra 为 53.6%。在最大推理强度下,其事实错误率降至仅 4.3%。 在 Terminal-Bench 4.0 测试中(该测试衡量编码智能体通过电脑命令行终端完成任务的能力),它在使用最大推理强度时解决了 50.3% 的任务,而 GPT-5.6 Terra 为 21.5%。

    匹配字段正文

  3. 东方财富

    高盛研判AI数据中心投资增长将在2026年Q4见顶

    高盛首席经济学家Jan Hatzius表示,超大规模数据中心AI投资占美国GDP的同比变化预计在2026年第四季度达到峰值,约为1.5%。亚马逊、微软、Alphabet、Meta、甲骨文和SpaceX今年AI基础设施资本支出预计达约7250亿至8000亿美元,比2025年增长64%,并推动美国投资级债券发行规模升至1.76万亿美元。高盛还测算,若数据中心投资热潮结束,美国GDP水平可能下降约2个百分点。

    接近2025年全年规模的三倍。今年美国已有九笔单次发行规模至少达到250亿美元的交易,除Skydance Corp.为收购进行的融资外,其余均来自科技公司。 “我们正在见证数十年来资本密集程度最高的企业周期之一,”高盛资产管理多元固定收益投资主管Lindsay Rosner表示。 高盛预测,在乐观情境下,AI投资所带来的财富效应,将使AI相关股票上涨55%、其他股票上涨20%,大盘整体涨30%,财富效应将提振消费增速0.7个百分点。但在悲观情景下(AI股跌40%、其他股跌15%、大盘跌20%),财富效应将对消费增速构成0.3个百分点的拖累。 AI投资通过“股市上涨→家庭财富增加→消费支出提升”路径传导。该行在此前的报告中写道,过去两年,财富效应平均每年提振消费增速约0.3个百分点,其中约0.2个百分点可归因于AI相关股票收益。未来一年预计提振0.4个百分点,主要由AI股强势表现驱动。 高盛集团亚太区(除日本外)总裁施南德此前警告称,股市中AI板块上涨带来的财富效应正在拉动消费,但这同时意味着一旦市场出现调整,会立刻通过财富效应传导至美国消费,这也是全球金融家当前关注的最大金融风险之一。

    匹配字段正文

  4. Databricks Blog

    Databricks Lakeflow Connect 为生产力工具与 AI 数据提供原生连接器

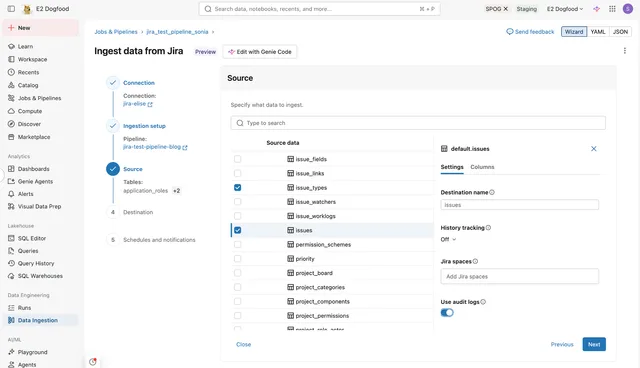
    Databricks 的 Lakeflow Connect 提供 Atlassian(Jira、Confluence)、Microsoft SharePoint、Google Workspace(Drive、Outlook、Gmail)、GitHub 以及 OpenAI、Anthropic 等来源的原生全托管连接器,数据直接落入 Unity Catalog。非结构化文件、页面和邮件以受治理表形式落地,无需自建或维护数据管道,可用于企业知识库、AI 智能体和开发者效率看板。Toyota Finance Australia 用其 Jira 连接器实现零维护管道,VaxCare 用 Confluence 连接器为聊天机器人提供知识库支撑。

    Screenshot of Jira connector from Lakeflow Connect

    请阅读 下游 RAG 指南. M3 Accounting是一家领先的酒店业软件提供商,它使用 Lakeflow Connect 的 GitHub 和 SharePoint 连接器,将其工程和产品文档统一到 Databricks 中。 “我们几分钟内就启动并运行了 Lakeflow Connect GitHub 连接器。它通过自动将我们的 GitHub 数据与其他工程运营数据融合,每周为我们节省约一小时,让我们能够全面了解开发者活动并真正据此采取行动。我们将 Lakeflow Connect SharePoint 连接器指向我们的产品文档库,一周内我们的内部知识助手就能从实时、最新的内容中提取信息。无需自定义爬虫,无需文件同步脚本,只需一个连接器和一条管道。” ——Ross Serven,M3 Accounting 数据与 AI 副总裁 用 Lakeflow Connect 治理你的 AI 支出 随着 AI 智能体和生成式工具在各团队中普及,关于支撑它们的模型的问题也随之而来:我们在花什么钱、谁在使用什么、是否合规?为帮助回答这些问题,Lakeflow Connect 为最大的基础模型提

    匹配字段正文

  5. MIT News · Artificial Intelligence

    MIT 在 2026 纽约气候周连接全球网络

    MIT 在 2026 纽约气候周期间组织 14 场会议,吸引超过 700 名参会者,议题涵盖数据中心、超级污染物、农业与教育。MIT 能源与气候副校长 Evelyn Wang 在开幕式讨论 AI 与气候方程,MIT 还与 Bezos Earth Fund 联合举办气候创新活动。MIT 气候变化参与项目编辑 Aaron Krol 主持了“Climate Communication for Impact”会议。

    建设更具韧性的社区和系统,”Wang说。她同时也是机械工程系Ford工程学教授。“纽约气候周之所以重要,是因为它汇聚了必须携手应对这些挑战的各类利益相关方和行业。当我们把麻省理工学院社区与这一全球网络连接起来时,我们就会发现强大的可能性,不仅能加强我们自身的努力,也能增强世界推动变革的能力。” 一个地点,众多活动 纽约气候周于9月21日至27日在曼哈顿及纽约其他行政区的多个场地举行。麻省理工学院联盟利用了曼哈顿切尔西街区Dream Downtown Hotel的多个空间,吸引了700多名参会者,活动形式从私密的小型对话到工作坊和专题演讲不等。 规模更大的会议包括“数据中心的未来:改变范式的技术”。“数据中心正处于一个拐点,面临相互关联的技术、运营、经济和社区约束,这些约束要求跨部门对话与创新,”麻省理工学院卡尔·理查德·索德伯格电力工程教授、气候项目教务主任陈刚说。 陈刚负责领导气候项目的“未来数据中心”前沿方向,他召集了一个由研究和产业界专家组成的小组,探讨能够改变范式的技术。“技术无法解决我们目前在数据中心面临的所有挑战,但技术在塑造一个更可持续、对这些设施所在社区更有利的未来角色

    匹配字段正文

  6. Databricks Blog

    Databricks AI Search 新增支持 Streaming Tables、Materialized…

    Databricks AI Search 在 Delta 表之外新增原生支持 Streaming Tables、Materialized Views 和基于 Iceberg v3+ 的 Managed 表,用户无需再建中间 Delta 表和同步管道。三类数据源分别对应实时事件、持续维护的个性化状态和跨引擎开放格式数据,UI 与 API 沿用同一套建索引流程。

    Search 会将这些变更传播到索引,从而实现个性化搜索体验,例如会话感知推荐、基于近期活动的产品和内容发现,或根据用户不断变化的兴趣和偏好定制结果。 使用 Iceberg 的 Managed 表:将开放格式数据引入搜索应用 Managed Iceberg 表可以直接作为 AI Search 源,无需转换或迁移到另一种表格式,从而使开放格式数据可供搜索索引和其他 AI 应用使用。开放格式使 AI 应用能够跨现有数据环境工作:搜索由不同系统管理的产品目录,统一存储在多个 Managed Iceberg 表中的业务或客户数据,或在不移动底层数据的情况下,在大型分布式数据集上构建搜索体验。 让搜索原生融入你的数据:将数据直接连接到 AI Search 在原生支持之前,客户必须为 Streaming Tables、Materialized Views 或 Managed Iceberg 表创建单独的 Delta 表示,并构建管道使其与源保持同步。这增加了额外的数据层、自定义更新逻辑和持续的运维开销。 现在,AI Search 可直接连接到这些源。从源创建索引并按需同步——AI Search 会

    匹配字段正文

  7. OpenAI:部署安全与系统卡

    OpenAI 发布 GPT-6.1 Terra 系统卡补充说明

    OpenAI 推出 GPT-6 系列新模型 GPT-6.1 Terra,定位为面向高吞吐专业工作的高效模型,具备较强的图像分析与计算机操作能力。系统卡补充说明称,按 Preparedness Framework 该模型在网络安全领域被定为 Critical、生物与化学领域为 High,沿用 GPT-6.1 Sol 与 GPT-6 Astra 的同一套防护措施。在 Production Benchmarks 上其安全表现与 GPT-5.6 Terra 持平,HealthBench Professional 长度校正分数高于 GPT-5.6 Terra,MentalHealthBench 得分为 55.5%,高于后者的 46.2%。

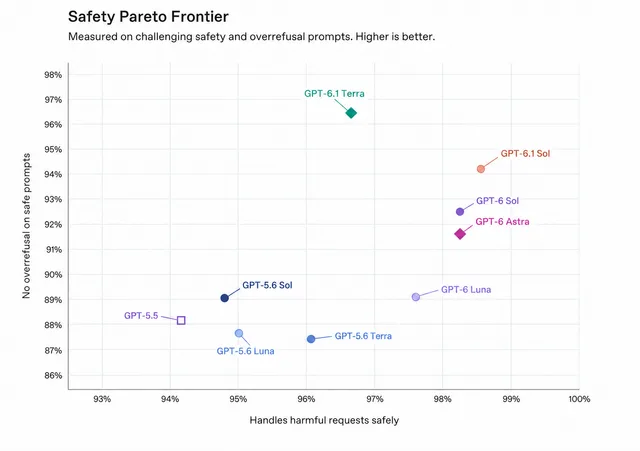
    Figure 1

    这些测试使用同时包含文本和图像的禁止请求,并衡量模型的回复是否被归类为安全。 表 24. 图像输入评估,指标为安全完成(数值越高越好) 表 4 类别 相较于 GPT-5.6 Terra,GPT-6.1 Terra 在自残和色情伤害方面与 GPT-5.6 Terra 表现相当,但在仇恨和极端主义方面出现统计显著的退步。在对评估失败案例的人工复核中,并结合我们的其他仇恨和极端主义评估总体来看,我们发现该模型的表现与既往发布版本一致。 多轮越狱评估 我们评估了针对来自内部红队演练的自适应、多轮攻击者的稳健性。这些攻击者可以探查模型、对其回答作出回应,并在多轮交互中调整策略。模型回答的评分依据是其能否实质性地协助有害请求:提供有害协助会得到更差的评分,而无害的回答会得到更好的评分。我们报告最坏情况下的防御方成功率随攻击者预算变化的函数:对于 n 次尝试的预算,只有当模型在所有 n 次攻击中都避免提供不安全的协助时,才算成功。这项评估在攻击者预算较高时尤其具有挑战性,因为模型需要对所有越狱尝试都保持稳健,才能被视为成功。 GPT-6.1 Terra 的表现与 GPT-5.6 Terra 相当。

    匹配字段正文

  8. Artificial Analysis精选

    OpenAI 发布 GPT-6.1 Terra,价格减半且幻觉率降至 38%

    OpenAI 发布 GPT-6.1 Terra,输入/输出价格为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元,缓存写入降至 1.25 美元、缓存输入降至 0.05 美元。Artificial Analysis 测得该模型在最大 effort 下智能指数比 GPT-5.6 Terra 高 6 分,单任务成本 0.40 美元对 1.40 美元,低 effort 档提升 7 至 13 分。在 AA-Omniscience 中,模型遇到不知道答案的问题时猜测比例为 38%,此前为 88%,同时准确率提高 2 分;Coding Agent Index v2.0 得分 48,Terminal-Bench 4.0 提升约 20 分。

    面达到帕累托最优:在最大 effort 下,GPT-6.1 Terra 在 Artificial Analysis 智能指数上比 GPT-5.6 Terra 提升 6 分,而每任务成本不到三分之一(0.40 美元对 1.40 美元)。在较低 effort 水平下,提升更大,介于 7 到 13 分之间。低和中等 effort 水平在成本效率上达到帕累托最优,而其他 effort 水平则位于前沿之后。在最大 effort 下,该模型在智能指数上比 GPT-6.1 Sol 低 4 分,比 GPT-6 Luna 高 10 分。 ➤ 推进 Coding Agent Index 成本效率前沿:在新发布的 Artificial Analysis Coding Agent Index v2.0 中,该模型得分为 48,比 GPT-6.1 Sol(54)低 6 分,比 GPT-6 Luna(31)高 17 分。xhigh 和低 effort 设置在 Coding Agent Index 中位于成本效率前沿,而其他 effort 水平则位于前沿之后。 ➤ 幻觉率下降 50 个百分点:在 AA-Omnisc

    匹配字段正文

  9. AWS Machine Learning

    用 CDK 在托管 Amazon Bedrock Knowledge Base 上构建智能体检索

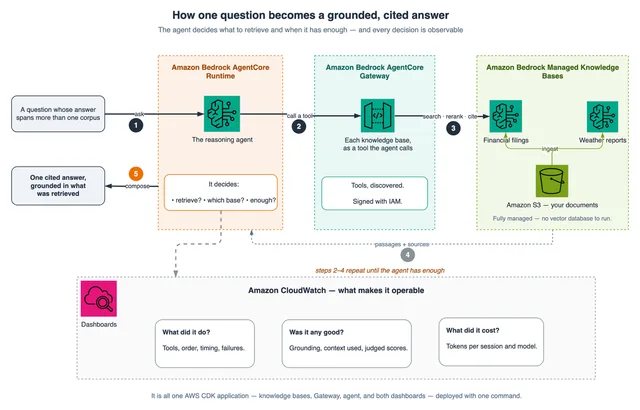
    AWS 发布方案,用 AWS CDK 在托管 Amazon Bedrock Knowledge Base 上部署企业级智能体检索:推理智能体通过 AgentCore Gateway 把两个知识库作为 MCP 工具调用,由 AgenticRetrieveStream 完成多轮规划、内部重排并返回带引用的答案。托管知识库(Type: MANAGED)接管摄取、存储、索引与检索,不再需要自建 OpenSearch Serverless 集合与索引。方案同时预置两块 CloudWatch 仪表盘覆盖七层遥测,并提供按需与持续两种评估,一条命令即可部署。

    Agent routing a question across two managed knowledge bases through the Gateway, with every step landing in Amazon CloudWatch

    一家虚构公司,10-K 是模型生成的示例数据(CC0 许可)。它并非 真实的财务数据。天气语料库是真实的、属于公有领域的美国政府作品,是一份国会研究服务局报告,可在 sgp.fas.org/crs/misc/IF12695.pdf 公开获取(美国政府作品不受版权保护)。要使用你自己的数据,请将文件放入 data/ 下,并调整 config.py中的前缀,无需其他更改。 这两个语料库被有意设计为彼此独立,因此智能体必须将每个问题路由到正确的知识库,这就是语义路由的故事。由于这些是托管知识库,我们无需配置分块、嵌入或索引:在摄取时,Amazon Bedrock 会解析每个 PDF、对其进行分块、使用其托管模型进行嵌入,并自动建立索引。 我们使用两个独立的知识库,每个都通过 Gateway 作为其自身的检索工具暴露出来,而不是用一个知识库同时容纳两个语料库,这一选择是有意为之的。为智能体提供两个具名工具,使路由成为一次可被观察到的显式推理行为:span 树会显示它为给定问题选择了 哪个 工具,而第 3 层的检索质量指标则按知识库保持可分离,因此金融和天气的精确度绝不会模糊成单一数字。一个横跨

    匹配字段正文

  10. AWS Machine Learning

    AWS 详解在 Amazon Bedrock 上使用 OpenAI 模型的提示词缓存模式

    AWS 发布教程,介绍在 Amazon Bedrock 上调用 OpenAI 模型时如何用提示词缓存降低智能体重复读取上下文的成本,区分隐式缓存与显式 prompt_cache_breakpoint 两种方式并建议组合使用。文中给出工具与指令缓存、多轮历史滚动断点、会话中途新增工具、子智能体共享前缀等代码示例,并称在 GPT-6 Astra 的六轮工作负载中隐式缓存降低约 62% 输入成本,显式滚动断点降低约 61%。可缓存前缀需至少 1024 token,缓存写入按正常输入价格的 1.25 倍计费。

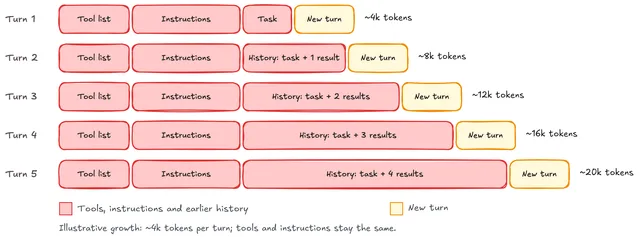
    Five growing agent requests, with tools, instructions, and earlier history marked in red and each new turn in yellow.

    ,约 4,000 token 的工具与指令前缀在首次请求时写入了 4,120 个 token,并在后续请求中读取了这 4,120 个 token。这个 task (或用户请求)出现在缓存边界之后,因此这不会触发对缓存的写入。 请记住,提示词缓存仅在传入完全相同的文本时才有效。请确保智能体的指令和工具列表每次都以相同方式序列化。模型上下文协议(MCP)服务器及其他形式的工具交付方式需要建立索引,以确保它们保持一致。请将任何会变化的内容(例如日期、用户名或请求 ID)放在已缓存的指令之后。 会在你的应用程序中保留对话历史。这不会禁用缓存。当下一轮继续同一任务时,这很有用。不同的任务无法通过旧任务匹配前缀,而隐式写入也不一定会仅为工具和指令单独创建一个条目。当你需要让这个较短的共享前缀可跨任务复用时,请在那里使用显式标记。当智能体既需要共享起点又需要不断增长的历史记录时,请同时使用两者。从标记的 store=False 会在你的应用程序中保留对话历史。这不会禁用缓存。 def ask with implicit cache(history): return client.responses.

    匹配字段正文

  11. AWS Machine Learning

    用 SageMaker SDK v3 在边缘实现车队级计算机视觉生命周期管理

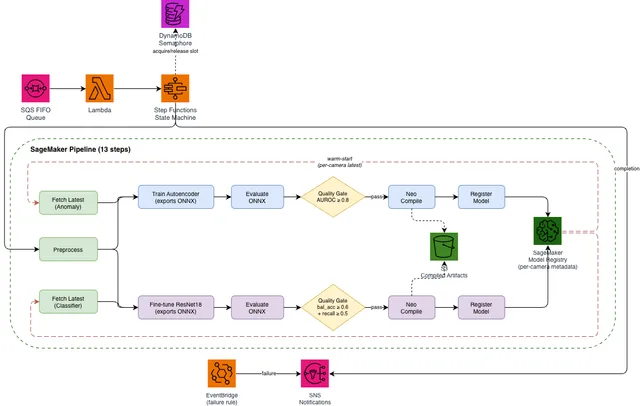
    AWS 发布基于 SageMaker Python SDK v3 的车队级边缘计算机视觉模型生命周期方案,用 SageMaker Neo 取代已弃用的 SageMaker Edge Manager 做边缘优化。方案以双分支 SageMaker Pipeline 为每台摄像头训练异常检测器和 ResNet18 缺陷分类器,经质量门禁后编译并注册到 Model Registry,由 Step Functions 控制车队训练节奏。合成数据上完整跑一次流水线计算成本约 $0.07。

    Solution architecture: SQS FIFO queue triggers AWS Lambda, which starts a Step Functions state machine with an Amazon DynamoDB semaphore for concurrency control. The state machine launches a 13-step SageMaker Pipeline with parallel entry steps (Preprocess, Fetch Latest Anomaly, Fetch Latest Classifier), dual training branches with ONNX evaluation, quality gates, Neo compilation, and Model Registry registration. Compiled artifacts land in S3. Completions and failures converge on an SNS topic.

    oTargetOs/NeoTargetArch 平台,默认为 LINUX/X86 64。编译后的包包含优化后的 compiled.so 以及 DLR 运行时 用于加载它。默认输出可在任何 x86 64 Linux 主机上运行,因此你可以在确定采用特定设备目标之前先进行验证。编译本身不产生费用。你需要为驱动编译的处理实例以及输出的 S3 存储付费。如果之后要为其他设备类型编译一个已注册的模型而无需重新训练,该仓库包含一个临时脚本,可对 Model Registry 运行相同的流程。 Model Registry 中的每摄像头模型 每个分支都会注册到各自的模型包组中,每个包都携带摄像头 ID 及其评估指标。从示例来看,省略指标接线后: classifier model builder = ModelBuilder( s3 model data url=classifier model data, image uri=custom training image uri, sagemaker session=pipeline session, role arn=role arn, ) step

    匹配字段正文

星期一

  1. Vapi Blog

    Vapi 上线流量拆分:小比例放量验证语音智能体新版本

    Vapi 推出流量拆分功能,可将呼入和呼出通话流量按 0.1%、1% 或 5% 等比例分配给不同版本的语音智能体,验证后再全量发布。该功能支持按来电者身份保持版本粘性,官方建议先做两路拆分,每次只改一个变量。此前发布新版本会把 100% 流量立即切过去,团队因此不敢频繁迭代。

    tOps 仓库来做版本管理,这仍然是一种不错的做法。还有些人利用助手请求作为逃生通道,在自己的侧构建路由逻辑。 说实话,这些方案大多比现在内置于平台的功能更复杂、也更不可靠。 最难做对的问题是什么,你们又是如何解决的? 两件事。 首先是安全地修改代码。它位于热路径中,因此每一个进来的调用都会触及它,无论是否使用了该功能。我们把一切都放在功能开关之后,在它到达其他任何人之前做了大量内部测试,并确保它易于回滚。 第二是身份——为了让重复来电者保持在同一个版本上,我们称之为“粘性”的概念。每个人接收和路由通话的方式都不同。真正的技术挑战在于跨电话通话、网络通话、呼入和呼出识别来电者,这样当某人再次来电时,他们尽可能获得同一个版本,而不是不同的版本,从而创造一致的体验。对于有此要求的部署,身份功能可以开启和关闭。 你见过客户用流量拆分来运行哪些用例? 最主要的是安全发布。制作一个新版本,将一小部分流量发送给它,观察,然后向所有人推出。 我们在查看客户数据时发现更有趣的一点是,拆分是临时的。会有那么一个时刻,你对新版本充满信心。人们不会把它调到100%,而是把助手设回“跟随最新版本”,这意味着新

    匹配字段正文

  2. Sakana AI:Blog

    Sakana AI 如何把日本本土 AI 产品推向全球:专访 GTM 副总裁

    Sakana AI 在 2026 年推出 Sakana Chat、Sakana Marlin、Sakana Fugu 和 Sakana Translate 等产品,其 GTM 团队于 2026 年 9 月正式组建,由副总裁 Hidekazu Kakishima 领导。团队采用“产品驱动 GTM”模式,并招聘 Forward Deployed Engineers(FDE),把客户现场经验反馈到产品改进中。Kakishima 曾任 AWS Japan 战略客户团队负责人、SORACOM 创始成员及 Skydio 相关职务。

    他们还想要一个可以放心、安全使用的环境。 —— 在那个市场中,您希望一年后和三年后达到什么位置? 当务之急是在日本客户中积累有效的部署成果。但谈到全球扩张,等到我们在日本有了业绩记录再推向海外就太慢了。所以我们从一开始就打算日本和海外并行推进。 在日本,我们将通过与我们投资方的合作以及与各类合作伙伴的伙伴关系广泛扩展。海外也是同样的思路:与海外大型科技公司和其他投资方建立成果,然后从那里扩展。理想情况下,三年后海外将占更大份额。 我们希望喜欢快速变化环境的人加入 —— 我们来谈谈团队。GTM 团队正在招聘多个职位:客户经理、FDE、合作伙伴联盟和客户成功。对于每个职位,您希望什么样的人加入? 我先说适用于所有职位的。一是享受变化。行业和公司现在都在非常剧烈地变化,我们希望人们能享受这一点并在其中茁壮成长。另一个是好奇心。在与广泛的人打交道的同时构建你的工作,包括客户、行业和公司内部的同事,这需要好奇心。 除此之外,对于客户经理,市场很大,我们预计我们销售的交易规模会动态增长。我们正在寻找从零开始建立大型业务并完成大额交易的人。合作伙伴联盟负责我前面提到的与系统集成商和生态系统的合作。这

    匹配字段正文

  3. Browser Use

    如何用 LLM 从网站提取结构化数据(2026)

    Browser Use 发布教程,介绍用一份 JSON Schema 在多个网站提取结构化数据的流程:静态页面抓取 Markdown 后由 LLM 填充,需要登录或点击的页面交给浏览器智能体。文章给出可靠性清单,包括开启结构化输出、用 Pydantic 或 Zod 校验、缺失字段返回 null、保留 source_url 与原文引用、按稳定键去重、遵守 robots.txt 并抽样核对。文中还对比了 Firecrawl、Crawl4AI、Browser Use、Stagehand 和自建 Fetch+Markdown+LLM 在登录与 JS 流程、Schema 支持、开源与计费上的差异。

    写一份 JSON Schema,并在每个网站上使用它。对于静态页面,抓取干净的页面文本(Markdown),让 LLM 填充该 schema。仅在需要登录、点击或 JavaScript 流程的页面上使用浏览器智能体。用该 schema 校验每条记录,对校验失败的记录进行重试或标记,并将源 URL 与每条记录一起存储。 我们开发了 Browser Use。关于其他工具的事实来自它们各自的文档和定价页面,核查于 2026 年 10 月 26 日,并在使用处附有链接。 可靠性清单 Schema: 必填字段及其类型,以及在取值固定处使用枚举。用 JSON Schema 编写,或从 Pydantic 或 Zod 模型生成。 受约束的输出: 开启模型的结构化输出。OpenAI 的模型会让响应 遵循你的 JSON Schema;Anthropic 的模型 保证字段类型和必填字段. 在代码中校验: 用以下工具解析每条记录 Pydantic 或 Zod。有效的 JSON 并不等同于正确的数据。 空值,而不是猜测:让缺失字段可为空但仍为必填,并告诉模型当页面未显示该值时返回 。证据:在每条记录上保留 ,并

    匹配字段正文

  4. ElevenLabs Blog

    文本转语音(TTS)技术是如何工作的

    文本转语音(TTS)分两阶段工作:前端先把文本归一化并转成 token 和向量表示,后端再由神经模型生成声学表示、经 vocoder 输出语音波形。ElevenLabs 在文中以“Mr. Ríos paid $11 on 10/06”为例演示了归一化、分词、韵律、声学模型到 vocoder 的完整流程,并提到发音词典和音素标注可用于微调发音。企业可通过 TTS API 将业务应用接入高质量语音生成。

    Text-to-speech process: normalize text, map prosody, create a spectrogram, generate audio.

    。虽然听起来比共振峰引擎生成的语音更自然,但拼接仍可能让语音听起来断断续续或支离破碎。 AI 语音生成器与文本转语音有什么区别? “AI 语音生成器”是营销中常用来描述包括文本转语音在内的广泛语音技术的术语。文本转语音特指以书面文本为输入、对其语义和韵律进行建模并输出音频波形的系统。 AI语音生成器是一个由相互关联的语音技术构成的完整生态系统,包括TTS以及其他用于 语音设计, 语音克隆和语音风格转换的生成式系统。虽然在营销中它常被当作文本转语音的同义词使用,但AI语音生成器最好被视为更广泛的生成式语音工具类别的术语,而TTS正是其中的一部分。 如何将文本转语音用于内容、无障碍和支持 文本转语音模型已成为世界各地工作流程的核心部分,无论是在个人领域还是商业领域。 以下是文本转语音的一些主要用例。 内容创作 文本转语音工具可以帮助降低大规模媒体制作的成本,并减少在录音棚中进行旁白录制和后期补录所花费的时间。 示例用例包括: 旁白 配音 译制配音 有声书制作 游戏对话 例如, TAP 使用 ElevenLabs TTS 为印度各地的学校扩展教育内容。 用于印度各地的学校。 无障碍 文本转语

    匹配字段正文

  5. Artificial Analysis 完整文章

    OpenAI 发布 GPT-6.1 Terra,成本效率进一步提升

    OpenAI 发布 GPT-6.1 Terra,输入/输出价格为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元。在 Artificial Analysis 智能指数中,最高 effort 下比 GPT-5.6 Terra 高 6 分,单任务成本 0.40 美元对 1.40 美元;低、中 effort 档位处于智能与成本的前沿。在 AA-Omniscience 基准上,模型不知道答案时的猜测率从 88% 降至 38%,准确率同时提高 2 分;Terminal-Bench 4.0 提升约 20 分,Coding Agent Index v2.0 得分 48。

    面处于帕累托最优:在最高 effort 下,GPT-6.1 Terra 在 Artificial Analysis 智能指数上比 GPT-5.6 Terra 高 6 分,而单任务成本不到三分之一(0.40 美元对 1.40 美元)。在较低 effort 水平下,提升更大,介于 7 到 13 分之间。低和中等 effort 水平在成本效率方面处于帕累托最优,而其他 effort 水平则位于前沿之后。在最高 effort 下,该模型在智能指数上比 GPT-6.1 Sol 低 4 分,比 GPT-6 Luna 高 10 分。 ➤ 推进 Coding Agent Index 成本效率前沿:在新发布的 Artificial Analysis Coding Agent Index v2.0 中得分为 48,该模型比 GPT-6.1 Sol(54)低 6 分,比 GPT-6 Luna(31)高 17 分。xhigh 和 low effort 设置在 Coding Agent Index 中处于成本效率前沿,而其他 effort 水平则位于前沿之后。 ➤ 幻觉率下降 50 个百分点:在我们的私有知识与

    匹配字段正文

  6. Claude Blog

    Anthropic 推出 Claude for Nonprofits 插件,为认证非营利组织提供技能与连接器

    Anthropic 发布 Claude for Nonprofits 插件,与约 30 家非营利组织共同打造,覆盖筹款、营销和招聘等运营工作。目前已有超过 25,000 家非营利组织使用 Claude,其中超过 75% 的组织席位不足 10 个。Anthropic 还计划通过与 Taproot 合作扩展 Claude Corps 项目。

    aude 在掌握你所在组织的背景信息时表现最佳,包括你的使命、项目、工作流、沟通原则和政策,并且当你的员工对如何使用它有明确规则时也是如此。首先让 Claude: 梳理你的组织。Claude 会询问你把各类记录存放在哪里,比如捐赠者数据、拨款文件、财务和政策,并在开启记忆功能的情况下,为每个人保存这份地图。随后它会主动提出连接它目前还无法访问的工具。插件中的其他每项技能都会先读取这份地图,因此 Claude 知道该去哪里查找,你也不必为每项任务都把它指向同一个来源。 检查你的 AI 政策允许什么。员工可以问“我能用 Claude 做这个吗?”,并根据你组织自己的 AI 政策得到答案。(还没有政策?参见下方的 Claude Academy 教程。) 为你的使命筹资 筹款是非营利组织的生命线,临近年底时尤为重要。它同时也是耗时且流程繁重的工作,对小型组织来说可能颇具挑战。该插件支持完整的筹款生命周期,从而释放你团队的时间,用于不可替代的人工工作,比如维护关系和决定追逐哪些机会。 找到合适的资助方和拨款。研究捐赠者、基金会、公司,并发现开放的拨款机会,且附有来源引用。 决定要追逐什么。转发一

    匹配字段正文

  7. Google Developers Blog

    Google Docs 和 Drive 原生支持 Markdown 文件的预览、编辑与协作

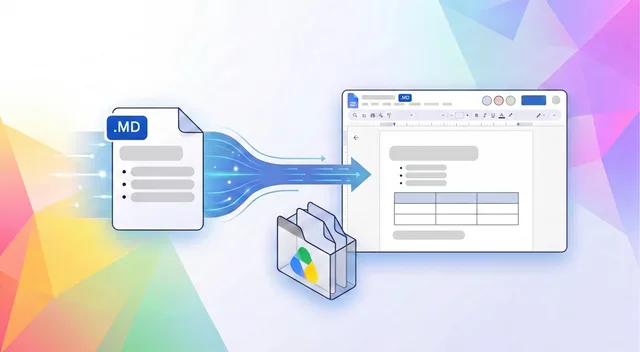
    Google Docs 和 Drive 现在可以原生查看、编辑和协作处理 Markdown(.md)文件,无需手动转换格式,Drive 中还能直接预览渲染后的表格和超链接。文档头部会显示 .md 标识,支持实时协作、行级评论和版本历史,方便团队成员与 AI 智能体在同一份文件上共同编辑。

    image (11)

    own 成为人类与 AI 工具之间的协作通用语言,因为它对两者都易于阅读。Google Docs 提供了一个熟悉、易用的环境,充当共享桥梁,让团队成员和自主智能体直接在同一批文档上协同工作。当你在 Google Docs 中打开 Markdown 文件时,你将获得: 原生文件保真度: 直接在 Google Docs 中管理和编辑 .md 文件,无需将其转换为其他格式。文档头部可见的 .md 标识会清楚表明你正在处理原生 Markdown 文件。 实时协作: 团队成员和 AI 智能体可以共同编辑同一文件,从而在工程、产品和 AI 工具之间保持单一事实来源。你还可以利用 Google Docs 的评论功能留下实时的行级反馈并跟踪建议。 可追踪的版本历史: 维护一份完整、透明的审计记录,涵盖人类贡献者和 AI 智能体所做的所有修订。 存储在 Drive 中: 直接在 Drive 中预览格式丰富的 Markdown 文件——全面支持表格和超链接——或无缝切换到原始文本,无需单独的查看器。 链接到 YouTube 视频 (仅在 JS 被禁用时可见) 通过将 Markdown 的简洁性与 Goog

    匹配字段正文

  8. Google Blog

    15 位大学生分享最爱的 Gemini 功能

    15 位 Google Student Ambassadors 分享了他们最常用的 Gemini 功能,包括把课程材料转成个性化短课的 Study notebooks、用语音练习面试的 Gemini Live、引导式学习的 Guided Learning,以及生成学习指南和定制测验。学生套餐提供课堂材料、学习笔记和图片的无限上传,Audio Overviews 还能把文档和幻灯片转成播客式对话,方便在校园路上复习。

    Three young adults gathered around a laptop looking at its screen

    学习笔记本让我在课前快速回顾50页论文变得快多了,”加州大学圣塔芭芭拉分校的Nina R.说。“而且如果你上传相互对立的观点,就能快速生成对比并掌握复杂概念。 2. Gemini Live Gemini Live 让你仅用语音就能与Gemini对话。“这是我练习面试和演讲的首选,因为它让我听到自己的想法实际听起来如何,”圣迭戈州立大学的Skylar E.说。其他学生则用它在外出途中讨论难懂的概念,或在出国留学前练习说新语言。 你还可以打开摄像头,让Gemini Live准确看到你正在看的东西。“作为一名设计师,我一直在学习新工具和软件,”得克萨斯大学奥斯汀分校的Debbie C.说。“当我使用某个工具卡住时,我可以让Gemini Live一步步引导我。” 3. 引导式学习 引导式学习 帮助你建立理解,而不只是给你答案。“我把自己的作业粘贴进去,不是直接要修复方案,而是让Gemini引导我找出哪里出了问题,”乔治梅森大学的Fehmaan K.说。“它会问我认为每一步会发生什么,而我通常能在它告诉我之前发现自己的错误。” 引导式学习会提出开放式问题来探查你的理解。“在会话中途卡住时,不要急

    匹配字段正文

  9. Google AI Blog

    Google 推出 AI Quests 新课程 Polar Peaks:用 AI 绘制人类大脑图谱

    Google Research 与斯坦福学习加速器推出 AI Quests 系列第三课 Polar Peaks,面向 11 至 14 岁学生,让他们扮演研究者扫描并绘制大脑神经元,练习数据清洗与模型测试,并理解 AI 需要人类监督。该课程灵感来自 Google 十余年的连接组学研究,AI Quests 累计完成超 40 万次任务、本地化至 10 种语言,配套教师培训模块将在下月上线。

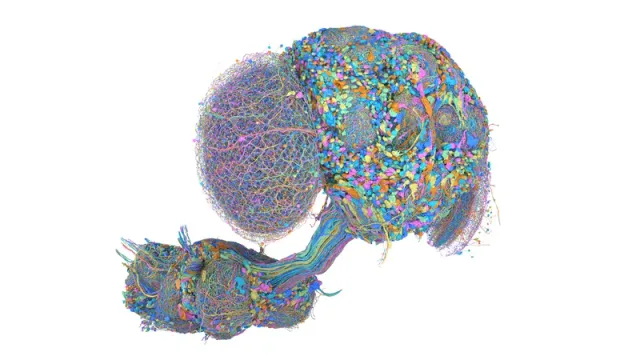
    AI仍处于实验阶段。 Google推出了一款名为“极地之巅”的新游戏,让你像科学家一样利用AI绘制人类大脑图谱。你将学习如何解决现实世界中的问题,同时了解如何负责任地使用AI。这是一种有趣的方式,让你看到研究人员如何利用技术实现重大科学突破。教师甚至可以获得专门培训,帮助你在课堂上探索这些挑战。 摘要由Google AI生成。生成式AI仍处于实验阶段。 探索其他样式: 今天,我们推出“极地之巅”,这是 AI探索 系列的第三项探索课程,由Google Research和 斯坦福学习加速器 共同打造,旨在教学生 AI如何运作以及如何负责任地使用它。 AI探索邀请11至14岁的学生化身Google研究人员,应对人类面临的一些最大挑战。 迄今为止,已完成超过40万次探索任务,本地化至10种语言。除了新探索课程,我们还发布了教师培训模块。 极地之巅:绘制人类大脑图谱之旅 在前两项探索课程中,学生们应对洪水预报和眼病检测,灵感来自Google Research的 洪水预报计划 和用于 糖尿病视网膜病变 筛查的AI模型。我们的最新探索课程“极地之巅”让学生前往神经科学的前沿,了解AI如何加速科学研究

    匹配字段正文