←搜索结果

按匹配度 · 共 2752 条结果 清除搜索

星期六

  1. ServeTheHome

    MSI XpertStation WS300 评测:搭载 NVIDIA DGX Station GB300 的桌面工作站

    MSI XpertStation WS300 是第二款基于 NVIDIA DGX Station GB300 的桌面工作站,配备 252GB HBM3E(7.1TB/s)的 Blackwell Ultra GPU、1600W 电源和双 400Gbps ConnectX-8 网络。整机重近 30kg,采用塔式机箱与闭环液冷,售价超过 10 万美元,定位为可放在桌边运行本地 AI 的服务器级硬件。

    terestLinkedinReddItEmailPrintCopy URL MSI XpertStation WS300 正面主图 今天我们来看第二款搭载 NVIDIA DGX Station 的系统——MSI 的 XpertStation WS300。这些基于 NVIDIA GB300 的系统首次将 NVIDIA 的服务器级硬件带入桌面级电脑,让开发者和其他工作站用户能够在本地 AI 环境中测试和运行程序。凭借 1.6kW 的最大功耗和一套庞大的液冷系统,这些 DGX Station 系统在桌面塔式机箱中塞入了尽可能多的服务器硬件,而且即便如此,也只是勉强装下。 上个月,我们评测了第一款 DGX Station 系统——技嘉的 W775-V10-L01。你可能在那篇评测中,以及在本篇评测中,都看到了我们利用 NVIDIA ConnectX-8 SuperNIC 将两台系统组网,实现 800Gbps 聚合的 Blackwell Ultra 到 Blackwell Ultra RDMA 链路。与许多前 AI 时代的工作站将网络视为事后考虑不同,在这里 MSI 和 NVIDIA 将其作为

    匹配字段正文

  2. Fortune AI

    让17岁的人改变主意:AI时代最好的职业选择

    俄亥俄卫斯理大学校长 Matt vandenBerg 主张,AI 时代不应逼17岁学生过早选定专业,而应允许他们探索并改变方向。Lumina Foundation-Gallup 4月研究显示,47%的在读大学生因AI对就业的影响认真考虑过转专业,16%已经转专业。该校因此允许学生到大二才申报专业,并把量化推理、科学质疑、审美思考、跨视角倾听、有效写作与表达等能力设为通识要求。

    d》Student Voice调查中,学生对大学第二常见的请求,仅次于帮助用好AI,就是保留真实的学习。在我看来,这提出了一个问题:大学应如何培养人类能力,例如深度思考、分析推理、判断力和品味。 所以我要直白地说出我的信念:AI是有史以来发生在文理学院身上的最好的事情,前提是这些学院足够聪明,能意识到我们所处的时刻。 大多数学院并没有这样行动。我花很多时间与其他大学校长相处,我看到的是一个处于防御姿态的行业。他们的反应是削减。他们在进一步打折学费。他们在等待人口结构、华盛顿或一个巧妙的销售说辞来拯救他们。我理解这种冲动。到2041年,高中毕业生人数预计将下降13%,而70%的美国人告诉皮尤研究中心,高等教育正朝着错误的方向前进。恐惧是理性的反应。 这也是一种失败的策略。当牌桌对你不利时,就掀翻它。 在俄亥俄卫斯理大学,我们正围绕占多数的探索型学生来建设整个学校。学生在二年级之前不能申报专业。我们的通识教育要求围绕可带入任何职业的能力来组织:定量推理、科学质疑、审美思考、跨视角倾听、有效写作与表达、负责任地行动。由于这些课程计入学位,探索是通往毕业之路的一部分。每位学生都必须走出课堂,通

    匹配字段正文

  3. Baseten 工程博客

    Baseten 推出 Environment Network,联合合作方为客户定制 RL 环境

    Baseten 推出 Environment Network,汇集经过严格审核的 RL 环境公司,为客户基于自有数据和领域构建定制 RL 环境。合作方直接对接客户完成环境、任务与评分标准构建,Baseten 仍负责模型训练与推理部署。Baseten 还计划开源一批前沿质量环境及审核与训练方法。

    partner network

    10月23日 分享 发布于 2026年10月23日 今天,我们隆重推出 Baseten 环境网络,这是一批经过严格审核的 RL 环境公司,将为我们的客户构建定制 RL 环境。 高质量环境对于成功的后训练至关重要,我们花了大量时间围绕 RL 环境的创建建立了一套科学方法。我们已在每一次后训练合作中践行这一方法(Harvey、Lovable、Gamma 以及许多其他客户)。但这是一项人力密集型工作:它需要用心、需要聪明的研究人员、需要良好的品味,还需要花大量时间审视数据。要扩大规模,我们需要更多具备这种专业能力的团队。 Baseten 环境网络将这些团队带给我们的客户,基于每位客户独有的数据和领域交付高质量的 RL 环境。我们相信,与 Baseten 的训练和推理能力相结合,这一网络将帮助更多客户借助其定制智能更快实现价值。 Baseten 环境网络 我们与大量 RL 环境公司进行了交流,对它们进行了审核,并进行了严格筛选。我们很自豪能与市场上一些最优秀的 RL 环境公司合作,并且非常放心地将我们的客户推荐给它们,作为其后期训练旅程中的额外合作伙伴。 正在加载嵌入内容… 与网络合作的运作方

    匹配字段正文

  4. Google Research

    Google Research 用 MedGemma 等开放模型推动结核病筛查落地

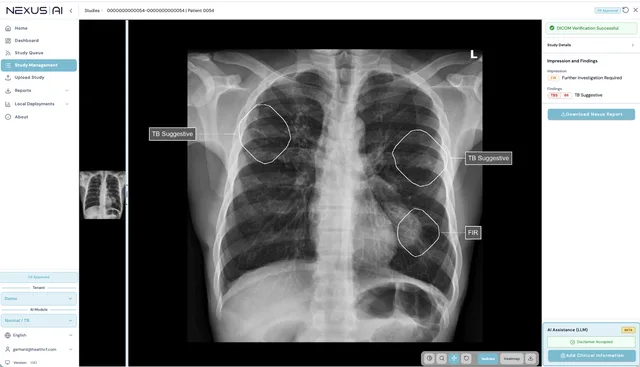
    Google Research 与 Google for Health 在 IDWeek 2026 上介绍了将健康 AI 研究推向临床的进展,包括开源胸部X光嵌入向量与 MedSigLIP、以及 4B 和 27B 两种参数规模的开放权重多模态模型 MedGemma,后者可离线本地运行,累计下载量已超 1000 万次。合作方 Nexus AI 基于这些算法开发的工具已获欧盟 CE MDR class IIb 认证和 ISO 13485 认证,在南非、塞拉利昂、科特迪瓦等六国的约 40 家医疗机构部署,超过 90 名临床医生已评估逾 2.5 万张胸片,将周转时间从数周缩短到 45 秒以内。印尼卫生部正用本国胸片微调 MedGemma 和 MedSigLIP,以在本地基础设施上支撑每年 5000 万人的筛查目标。

    A Nexus AI software interface displaying a chest X-ray with three circled lung areas marked as "TB Suggestive" and "FIR".

    th 上评估了 自动化计算机辅助检测(CAD)软件在多样化患者队列中的表现,将我们的模型列为 表现最佳的结核病筛查算法 在全球范围内。那一年,WHO还 推荐使用CAD 进行结核病筛查和分诊。2024年9月,在 NEJM AI上,我们详细介绍了 一项前瞻性、多站点验证 ,证明AI辅助筛查在不同患者群体中均保持高灵敏度(最大限度减少漏诊病例),同时还能可靠地检出其他偶发的肺部和心脏异常。 跨越转化鸿沟 在医疗AI领域,发表论文只是开始。在算法模型与可信赖的床旁工具之间,横亘着一道“转化鸿沟”:让软件在各种不同的X光机和离线环境中保持可靠,将其整合进临床工作流程,并满足医疗器械法规要求。 有鉴于此,我们与 Nexus AI合作,这是一家总部位于比勒陀利亚的医疗技术公司,他们将我们的胸部X光算法转化为一款获得认证的临床诊断工具。应对监管环境需要大量审计: CE MDR class IIb认证: 根据欧盟医疗器械法规(EU MDR 2017/745),Nexus AI获得了Class IIb认证——这是一项严格的认定,基于前瞻性临床评估验证该工具在真实患者诊疗中的安全性。 质量标准: Nexus

    匹配字段正文

  5. SemiAnalysis

    SemiAnalysis 实测 Trainium3 的 PyTorch 训练与 Neuron Explorer 剖析器

    SemiAnalysis 工程团队在 Trainium3 上实测了原生 PyTorch 训练栈 TorchNeuron 与 TorchTitan,用 Qwen3-32B 在 16 颗 Trainium2 上训练,eager 模式达 11,099 tokens/s、23.89% MFU,compiled 模式达 14,156 tokens/s、30.47% MFU。作者认为 Neuron Explorer 剖析器优于 Nvidia 和 AMD 的方案,但首次编译耗时过长,gpt-oss 训练配方首步编译用了 27 分 17 秒。FlexAttention 测试通过 96 个用例中的 89 个,7 个失败均因编译超时而非数值错误。

    期望的方式运行PyTorch——eager模式,配合torch.compile和标准API。 SemiAnalysis工程团队过去几周一直在试用Trainium3机架,发现体验很棒——我们很喜欢它整体的发展方向。需要说明的是,它还不完美,我们自己也遇到了几个bug。它远未达到CUDA生态的成熟度,但方向是对的。他们的团队借助智能体编码正在快速推进。 此外,与其他加速器公司不同——我们曾不得不费尽周折才能让他们的工程师获得一个还算稳定的CI集群——Trainium最多分配80,000个物理核心用于自动化质量控制。 在本文中,我们将介绍我们在Trainium3 TorchTitan和TorchNeuron技术栈上的体验,以及我们对Trainium的Neuron Explorer剖析器的体验——它远优于Nvidia和AMD的剖析器。我们制作了一系列演示,展示Trainium的剖析器如何做到“GPU Impossible”。 AWS副总裁Nafea Bshara在Trainium剖析器中展示Trainium的细粒度剖析器。来源:SemiAnalysis 在即将发表的一篇文章中,我们将深入探讨编

    匹配字段正文

  6. MIT News · Artificial Intelligence

    MIT 人文、艺术与社会科学学院 75 周年研讨会:AI 时代重申人类理解的价值

    MIT 人文、艺术与社会科学学院(SHASS)于 9 月 24-25 日举办 75 周年研讨会,校长 Sally Kornbluth 表示 AI 已对研究和教育产生巨大影响,MIT 比以往更需要该学院的洞见与指引。教务长 Anantha Chandrakasan 强调艺术、人文与社会科学在 AI 驱动的快速变化中与以往同样重要,仅靠技术能力不足以解决全球性挑战。

    们在未来几年迫切希望共同应对的问题,”MIT格梅斯豪森科学史教授兼物理学教授戴维·凯泽说,他还担任研讨会筹备委员会主席。 第一天包括一场关于教学与学习创新的会议。教师们介绍了SHASS旗下教育项目的成功经验,包括MIT原住民语言倡议硕士项目、数据、经济学与政策设计硕士项目(DEDP),以及MIT学生全球体验中心MISTI。 文学副教授斯蒂芬妮·西德谈到了她和其他人为何致力于将经典书籍重新融入教学。 “当然,MIT是一所格外面向未来的机构,”她说。“我们的学生接受训练,去想象并创造尚不存在的世界。而正是这种面向未来的取向,使得在这里阅读过去尤为重要。” 比较媒体研究/写作教授、MIT近期关于人工智能与教学报告的共同作者埃里克·克洛普弗表示,当下正是教师必须重新评估课程教学方式的时刻。 “我并不确切知道那会是什么样子,但我确实认为,这意味着某种不止于修改课程的东西。我认为它真正意味着重新思考教育体验究竟是什么,”他说。 在一场关于计算与社会的会议中,小组成员描述了关于技术及其如何影响人类的不同观点和研究。 “我们将自身的某些方面投射到计算系统上,”MIT教授D·福克斯·哈雷尔在谈到在机器中

    匹配字段正文

  7. MIT News · Artificial Intelligence

    Martha Minow 在 MIT 谈 AI 时代如何维系民主

    哈佛大学法学学者 Martha Minow 在 MIT 的 Compton 讲座中指出,AI 正在削弱民主的四大要素——教育、可靠信息、安全与公平,并警告可能出现“启蒙运动的失落”。她援引 Gallup 民调称 77% 的美国人认为建国先贤会对国家现状失望,同时主张现有 LLM 可通过提示、提问和线索而非替代学生作业来深化思考,MIT 的研究者有能力开发更可信的工具。

    。 “许多人真心怀疑,这个250年前点燃的国家政府体系和法治能否存续,”Minow说。 她在发言中从她所称的民主四大关键“要素”评估了美国的状况:教育、可靠且可获取的信息、免于暴力的安全,以及公平。Minow评估了AI如何影响这些生活领域,同时也提出了人们可以利用当代技术提供帮助的方式。 “听到把责任归咎于数字技术和各路专家,这很常见,但我相信,如果MIT及其他地方的人们投入时间和才华,致力于真正且亟需的解决方案,转机是完全可能的,”Minow说。 她发言的很大一部分聚焦于AI在教育中的隐患。这一问题与其他一些令人不安的趋势相互叠加:Minow指出,美国在教育经费上已经存在巨大的地方和区域差距,而过去三十年来,学校在经济和族裔方面的隔离实际上显著加剧。 Minow认为,在这种背景下,AI有可能进一步削弱独立思考能力,而恰恰此时,加深对公民议题的理解至关重要。 “随着AI迅猛发展,我认为我们必须学会更明智地使用它、监管它,并真正教育人们认识无脑使用的代价,”Minow说。她还补充道:“主流AI平台强化了社交媒体公司所采用的策略,使人变得被动……领先的AI模型、界面以及迎合性元素,危及尤其

    匹配字段正文

  8. AWS Machine Learning

    Bayer 如何在 Amazon Bedrock AgentCore 上构建智能体决策引擎

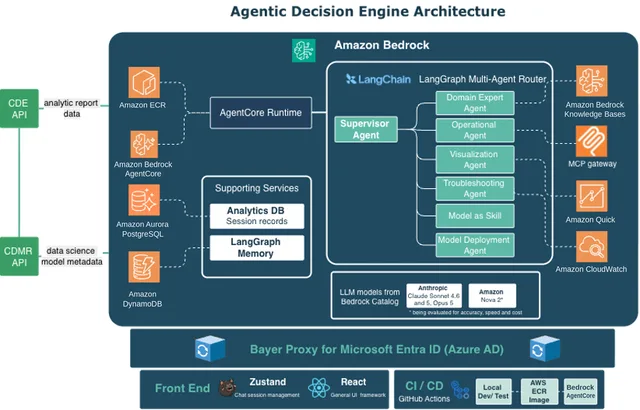
    Bayer Crop Science 基于 Amazon Bedrock AgentCore 构建了多智能体自然语言界面 ADE,覆盖其 Connected Decision Engine,第一阶段约 80% 的用户问题无需工程师介入即可解决。ADE 在生产环境运行 22 个专业智能体,由 Supervisor Agent 按意图路由,并借助 AgentCore Gateway 以 MCP 工具形式暴露后端 API。故障诊断时间从过去超过 1 小时的手动排查缩短至 10 分钟以内。

    Agentic Decision Engine architecture: user experience, orchestration, specialist agents, and tools and data source layers

    ,并与用户请求和检索到的上下文竞争。ADE 按专家智能体限定工具范围,而不是让每个智能体都获得完整目录。对于更大的目录,AgentCore Gateway 支持语义工具搜索,因此智能体无需在每一轮加载整个目录即可找到相关工具。 原则: 按智能体限定工具目录范围。每个工具定义都会增加令牌并扩大模型的决策空间。 5. 将复杂能力从工具提升为智能体 可视化最初是由其他智能体调用的工具。随着其发展,它需要自己的数据检索、图表选择逻辑、重试、错误处理,以及决定是生成图表还是返回现有仪表板。团队将其移入专门的 Visualization Agent。该智能体在 AgentCore Code Interpreter(Amazon Bedrock AgentCore 的一项能力,提供沙箱化代码执行环境)中使用 matplotlib 和 Plotly 生成按需图表,并通过 Amazon S3 与其交换数据。当预构建仪表板是更好的答案时,该智能体会返回现有的 Amazon Quick 或 Power BI 资产。 原则: 工具执行有界操作。当某项能力开始拥有状态、重试、规划、策略或呈现决策时,就应将其建模

    匹配字段正文

  9. Moonshot AI · Kimi Blog精选

    月之暗面发布 Kimi K3.1 Pro:3T 级开源权重模型,100 万 token 上下文

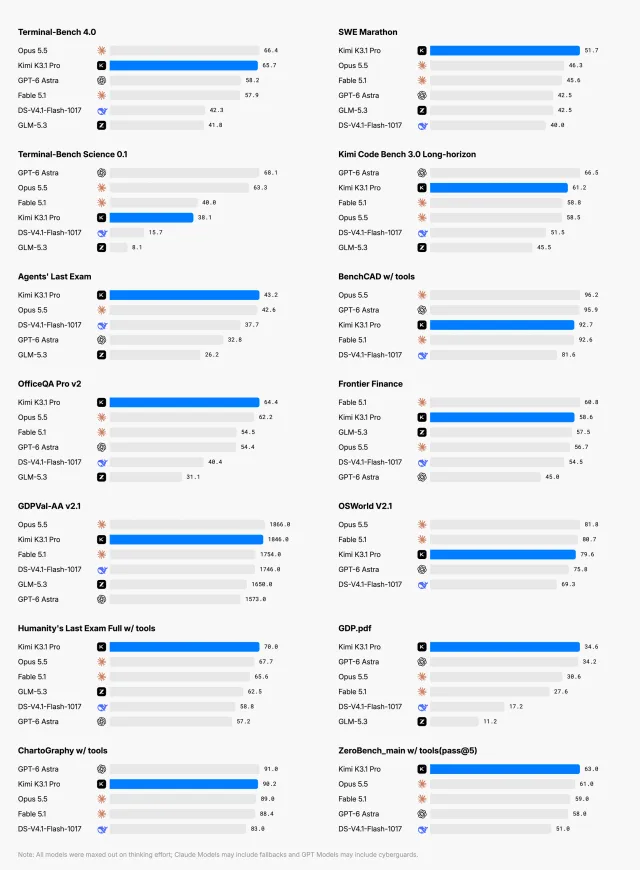
    月之暗面发布 Kimi K3.1 Pro,这是 K3.1 系列首个模型,也是其迄今最强的 3T 级开源权重模型,上下文窗口为 100 万 token,同时推出速度提升 2-3 倍的 Kimi K3.1 Pro Highspeed。该模型已在 Kimi.com、Kimi Work、Kimi Code 和 Kimi API 上线,完整模型权重将于 11 月 4 日发布。在 Terminal-Bench 4.0 上,K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;在内部基准 Kimi Code Bench 3.0 Long-horizon 上得分为 61.2%,高于 K3 的 55.95%。

    Benchmark results for Kimi K3.1 Pro and peer models across 14 coding, science, and knowledge-work evaluations

    隆重推出 Kimi K3.1 Pro 我们隆重推出 Kimi K3.1 Pro,这是我们全新 K3.1 系列的首个模型,也是我们迄今为止能力最强的 3T 级开放权重模型,拥有 100 万 token 的上下文窗口。它在编程、3D 创作、金融研究及其他智能体能力方面均有显著提升。 我们还同步发布 Kimi K3.1 Pro Highspeed,其速度是 K3.1 Pro 的 2-3 倍,交互响应更为迅捷。 Kimi K3.1 Pro 与 Kimi K3.1 Pro Highspeed 即日起在 Kimi.com, Kimi Work, Kimi Code以及 Kimi API上线。完整模型权重将于 11 月 4 日前发布。 推进开放智能的前沿 Kimi K3.1 Pro 是 Kimi K3 的后训练版本,其后训练算力大幅增加。为了在 数百个下游领域实现大规模联合强化学习,我们优化了技术栈的每一层——强化学习框架、长上下文推理、训练效率、沙箱基础设施、rollout 调度,以及用于环境质量检查的共享平台——从而使每一份强化学习算力的增量都能带来稳定、可预期的回报。因此,K3.1 Pro 在

    匹配字段正文

  10. Figma AI / Agent / Make

    Figma 代码层进入公开测试,六个团队分享使用方式

    Figma 宣布代码层(code layers)进入公开测试,团队可以在画布上探索和构建由代码支撑的原型。文章列举 Superside、Dell、Cox Automotive、Rocket Money、Merkle、Checkout.com 六个团队的使用方式,包括用 Figma agent 把静态设计转成代码层、并排对比多个版本、以及用精确数值和参考截图分阶段迭代。Merkle 称迭代和功能开发速度提升 30%,文档创建时间最多减少 50%;Cox Automotive 的产品经理称 19 个版本只花约一小时手动操作时间。代码层将消耗 AI credits,付费计划在 2026 年 11 月 4 日前创建和编辑免费。

    Pickup App preview showing a wall clock listing beside its App.tsx code.

    的方法。 已在Figma中提供其编码的React组件,Miguel的代码层便基于开发者使用的相同组件构建。这让团队成员能更真实地了解提议的设计在已发布产品中的外观和行为。Miguel使用代码层将会话式AI体验带到画布上:利益相关者可以提问,原型会用正确的屏幕作出回应。“利益相关者真的可以在文本框中输入内容,这开启了我们以前没有的下一级原型体验,”他说。 一旦其他设计师批准了某个流程,Miguel就会在代码层中将其构建出来,以获得跨职能合作伙伴的签字确认,因为他们发现可运行的原型比一系列静态屏幕更容易理解。在编辑时,他会复制代码层以并排保留版本,这比切换版本历史更容易在备选方案之间做选择。“就像你看着一面墙,看看A,再看看B,”Miguel说。可运行的原型在评审周期中也令人印象深刻:“当我向产品经理和业务利益相关者展示时,我们获得了那种惊艳效果。它功能非常完整。” 借助代码层,我可以在画布上设计的同时处理代码。设计与代码之间能有更多来回互动,这真的很强大。“借助代码层,我可以在画布上设计的同时处理代码。设计与代码之间能有更多来回互动,这真的很强大。” Miguel Wermuth,Del

    匹配字段正文

星期五

  1. Claude Blog精选

    Anthropic 发布 Claude Duet 研究预览版并公布其安全、隐私与安全设计

    Anthropic 发布研究预览版 Claude Duet,这是一个在云端计算机上持续运行、可读取收件箱、起草回复、预订事项并在你离开后执行例程的主动型智能体。它在发送敏感消息、付款或删除内容前会展示操作、目标与内容并等待批准,证券交易、账户间转账等操作即使批准也不允许。新增的安全分类器把信息分为绝不分享和需同意分享两级,密码、浏览器 cookie 和登录 token 不经过模型,浏览器运行在独立虚拟机中。

    de Duet,我们每天都用它来工作。 我们基于三项原则构建了 Claude Duet,以指导该智能体的行为: 你的信息,以及他人在你连接的应用中分享的内容,都会得到谨慎处理,使用一个新的分类器在 Claude Duet 起草的消息发出前进行检查。 你始终掌控它代表你所做的事情。 Claude Duet 永远不会看到你的密码、浏览器 cookie、登录令牌或其他凭据。 Claude Duet 是全新的,但其背后的思考并非如此。2025 年,我们发布了安全可信智能体框架(在新标签页中打开),该框架将人置于控制地位,并将隐私和安全交互视为基本要求。此后,我们撰文阐述了为何单一防御措施不够(在新标签页中打开),以及为何模型内部的保护无法独立存在(在新标签页中打开)。我们还通过 Claude Managed Agents(在新标签页中打开)构建并运营企业用于在生产环境中运行智能体的基础设施,而 Claude Duet 同样将凭据与智能体分离。它建立在这项工作之上,增加了代表你行事的智能体所需的保护措施。本文将介绍我们新增的内容以及仍在努力的方向。 重要操作由你批准 在你离开时行事的智能体必须知

    匹配字段正文

  2. Browser Use

    11 款最佳浏览器自动化工具:智能体、脚本与云浏览器

    Browser Use 发布 11 款浏览器自动化工具盘点,按用途给出推荐:目标驱动的网站任务用 Browser Use,抓取网站内容用 Firecrawl,脚本化自动化与应用测试用 Playwright,生成截图或 PDF 用 Browserless,可视化搭建表格驱动工作流用 Axiom。Browser Use 提供每浏览器小时 $0.02 的 stealth 浏览器托管,无需订阅,托管定价为模型成本加 20% 加价;Firecrawl 免费版每月 1,000 credits,Hobby 版每月 $19(年付每月 $16)。

    的交互和会话处理来评估 Browser Sandbox。 Browser Use 与 Firecrawl 的对比 涵盖了这些不同的用例。 免费计划每月包含 1,000 credits。Hobby 版每月 $19 提供 5,000 credits,或按年付费每月 $16。Browser Sandbox 代码执行每浏览器分钟使用两个 credits,最低一分钟;其他端点有不同的计费规则。 3. Browserless Browserless 提供远程浏览器和 API,用于抓取、截图、PDF 和交互式自动化。现有的 Playwright 或 Puppeteer 应用程序可以通过 WebSocket 连接,而需要返回单个产物的应用程序可以使用 HTTP 端点。 这一区别对集成工作很重要。截图服务可以提交 URL 并接收图像。经过身份验证的报告导出通常需要一个持续会话以及在下载文件之前导航账户的代码。 其产品包括: 为现有脚本提供的远程浏览器连接。 用于截图、PDF、抓取和内容提取的 REST 端点。 用于浏览器操作的 BrowserQL 和 SDK 接口。 云、授权自托管和私有部署选项。 如果

    匹配字段正文

  3. Artificial Analysis 完整文章精选

    Kimi K3.1 Pro 发布,智能指数排名第 4,权重开放后将领先开源模型

    月之暗面发布推理模型 Kimi K3.1 Pro,在 Artificial Analysis 智能指数上得分 55,排名第 4,比 Kimi K3 的 44 分提升 11 分,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。其智能体能力提升明显,GDPval-AA 得分 1,846 Elo 排第 3,Terminal-Bench 4.0 得分 67%(Kimi K3 为 13%),AutomationBench-AA 从 58% 升至 73%。模型上下文窗口 1M tokens,总参数 2.8T、激活参数 104B,支持文本和图像输入,定价为每 1M 输入/输出/缓存命中 token 2/10/0.20 美元,三项均比 Kimi K3 低 33%;权重尚未公布,发布后将成为得分最高的开源权重模型,开源与闭源领先模型的差距将从 12 分缩小到 3 分。

    Elo)和Muse Wonder Full(1,857 Elo)。Kimi K3.1 Pro还在Terminal-Bench 4.0上取得所有模型中的最高分。K3.1 Pro得分为67%,高于Kimi K3的13%,并领先于Claude Sonnet 5.5(64%)。测试智能体SaaS工作流的AutomationBench-AA从58%升至73%。 ➤ 其他评测的提升较为温和:Humanity's Last Exam从47%升至52%,CritPt从23%升至25%,SciCode从59%升至61%。AA-Omniscience指数从20升至30,幻觉率从53%降至44%,准确率从48%升至51%。 ➤ 每任务成本与Kimi K3大致相当,为每任务1.98美元:K3.1 Pro在每个智能指数任务上使用55K输出token,比Kimi K3的48K多14%,而其第一方token价格低33%。 更多模型细节:➤ 上下文窗口:1M tokens。➤ 规模:总参数2.8T,激活参数104B ➤ 输入模态:文本和图像 ➤ 权重与许可证:权重目前尚未公布,预计月之暗面将在发布后不久公布权重 ➤

    匹配字段正文

  4. TechSpot

    英国一名警探因涉嫌用 Microsoft Copilot 辅助刑事案件决策被调查

    英国德比郡警察局一名高级警探因涉嫌使用 Microsoft Copilot 协助刑事案件决策,正接受独立警察行为办公室(IOPC)的严重不当行为调查。该警探被指用 AI 制定政策决定、评估和管理风险、为侦查决策提供依据,并向工具输入案件相关的敏感行动和个人信息。德比郡警方于 2025 年 5 月批准警员使用 Copilot 起草报告和汇总信息,但明确禁止输入行动、敏感或个人数据;调查将审查其 2025 年 5 月至 2026 年 6 月间的使用情况,目前尚未作出结论。

    是帮助完成起草报告和汇总信息等任务。但该许可附带条件,禁止输入行动、敏感或个人数据。 IOPC 参与事务主管 Emily Barry 表示:“这些是严重的指控,理应得到彻底、独立的调查。” 调查人员将审查该警探在 2025 年 5 月至 2026 年 6 月期间使用 Copilot 的情况,以确定是否违反了职业标准。该警官已收到严重不当行为通知,但尚未作出任何认定。 AI 已经在其他地方的警方文书工作中崭露头角。此前有报道称,美国一些警察部门正在采用 Axon 的 Draft One,该工具可根据执法记录仪音频生成报告草稿。警员必须检查并批准结果,但人们仍对信息不准确以及日益依赖自动写作感到担忧。 今年早些时候,出现了一个 AI 弄错警方文书的离奇案例。犹他州一份 AI 生成的报告声称一名警员变成了一只青蛙,原因是该软件捕捉到了背景中播放的迪士尼《公主与青蛙》的音频。在报告提交前,有人发现了这个错误。 敏感数据这一因素也让人想起三星在 2023 年的经历,当时员工将机密代码和会议信息提交给了 ChatGPT。正如当时报道的那样,为加快日常工作而做的尝试,最终却把公司信息交给了外部服务。

    匹配字段正文

  5. Modem:Blog

    Modem 推出由 Jev 驱动的智能触发器,按自然语言条件筛选事件后再启动智能体

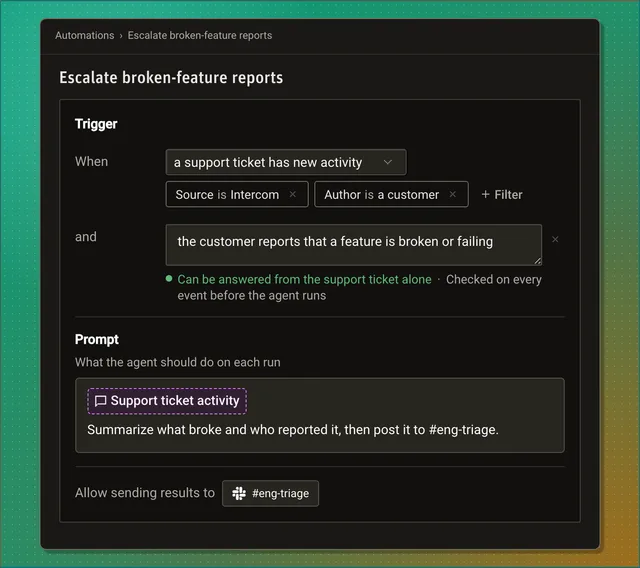
    Modem 上线智能触发器:每个事件先由 TypeSafe 的决策模型 Jev 按自然语言条件判断,单次评估不到 1 秒、成本 1/100 美分,只有匹配时才启动 Modem 智能体。该功能现已向所有用户开放,并可通过 Claude、ChatGPT、Cursor 及 MCP 插件用自然语言创建自动化。

    The automation form: When 'a support ticket has new activity', with the scope tokens 'Source is Intercom' and 'Author is a customer', and the condition 'the customer reports that a feature is broken or failing' with the status 'Can be answered from the support ticket alone'

    所有帖子 使用 Jev 控制 Modem 何时采取行动。 在 Modem,来自客户的工单、电话、Slack 消息、电子邮件和应用内反馈全天不断涌入,我们希望 Modem 的智能体能在这些信息到达时立即处理——提醒你的团队、创建工单,或执行其他智能体工作流。但这意味着每个事件都要启动一次完整的智能体运行,即使根本没有需要处理的内容。 智能触发器改变了这一点。现在,在启动 Modem 智能体之前,我们会先使用来自 TypeSafe的决策模型 Jev,依据纯英文条件对每个事件进行评估。这些条件可由你自定义,评估耗时不到一秒,成本仅为 1/100 美分。智能体只会在匹配的事件上运行。 这意味着 Modem 用户现在可以运行多得多的自定义自动化,覆盖更多工作流—— 同时消耗更少的智能体使用额度 ——以满足整个组织对客户和产品可观测性的需求。而且该功能今天已向所有人开放。 使用 Jev 筛选触发事件 开始使用智能触发器最简单的方式,是通过 Modem 智能体创建或更新你的自动化,无论是在应用内,还是从 Slack 或 Discord 操作。Modem 会自动使用智能触发器,确保自动化只在需要时运行

    匹配字段正文

  6. TechCrunch AI

    Warhound 获 2 亿美元融资,为美军基因工程改造军犬并配备 Anduril 装备

    Colossal Biosciences 的 Ben Lamm 与 Anduril 的 Palmer Luckey 联合创办的 Warhound 结束隐身状态,获 2 亿美元融资,投资方包括 Sequoia、8VC、Corner Ventures 和 CIA 支持的 In-Q-Tel,估值 12 亿美元。公司计划用 Colossal 的基因编辑技术改良比利时马林诺斯犬和德国牧羊犬,Anduril 提供防护背心、护目镜等软硬件,首批犬只即将克隆培育,预计明年初出生、两年内投入服务。

    Colossal Biosciences 的 Ben Lamm 与 Anduril 的 Palmer Luckey 萌生了一个想法:为美国军方、执法部门和其他应急响应团队基因工程改造军犬。周四,这一想法以 Warhound 之名结束隐身状态,获得 2 亿美元融资,投资方包括 Sequoia、8VC、Corner Ventures 以及由 CIA 和其他美国情报机构支持的创投公司 In-Q-Tel。本轮融资对公司的估值为 12 亿美元。 Warhound 的犬只目前尚不存在,它们将承担对人类危险或对机器困难的任务,例如炸弹探测、搜索和其他特种行动。公司在发布公告中表示,美国军方超过 80% 的工作犬来自欧洲,其中不到一半适合服役。 这意味着工作犬的供应正在减少,美国日益依赖外国提供在军队和执法中发挥重要作用的犬只。Warhound 旨在改变这一局面。公司在一份新闻稿中表示,希望 Colossal 能利用其技术培育出“适合执行高要求任务的特征”的犬只。 Lamm 告诉 TechCrunch,大约一年前他在一次会议上结识了 Luckey,当时 Luckey 表示应该为军方的工作犬做更多事情。

    匹配字段正文

  7. Aidan Gomez

    Cohere 与 Aleph Alpha 合作并收购 AISLE,推进欧洲前沿 AI 布局

    Cohere CEO Aidan Gomez 本周在布鲁塞尔与冯德莱恩、Henna Virkkunen 会面,讨论通过 Cohere 与 Aleph Alpha 的合作及收购 AISLE 在欧盟推进前沿 AI 发展与扩张。他表示欧洲对提升竞争力和韧性的投入令人鼓舞,并期待与欧洲客户和政策制定者继续推动主权、安全、可靠的 AI 开发与采用。

    本周能在布鲁塞尔与@vonderleyen和@HennaVirkkunen相聚,深感荣幸。 看到欧洲致力于增强自身竞争力和韧性,令人鼓舞。在会谈中,我们讨论了通过Cohere与Aleph Alpha的合作以及对AISLE的收购,在欧盟推进前沿AI发展与扩张的愿景。 我们期待与欧洲的客户、政策制定者及其他利益相关方继续携手,推动主权、安全、可靠的AI的开发与采用。

    匹配字段正文

  8. heise online

    Anthropic 推出主动型 AI 智能体 Claude Duet

    Anthropic 发布主动型 AI 智能体 Claude Duet,基于 Claude Opus 5.5,在带独立浏览器的虚拟机中运行,可自行监控邮件、日历和业务软件并在后台处理任务。该服务先以预览形式面向美国 Pro 和 Max 订阅用户开放,需加入等待名单,可通过 iOS、Android 应用和 claude.ai 使用。Duet 接入超过 6000 个连接器和插件,包括 Gmail、Slack、QuickBooks、Stripe 等,付款、签署文件、删除文件等操作需用户明确确认,证券交易和账户间转账则完全禁止。Anthropic 称其为早期版本,可能误读消息或误判紧急程度,且后台检查会消耗现有 Claude 套餐额度。

    该智能体可能误读消息,也可能错误判断事务的紧急程度。诸如订票之类的个人任务目前还不如职业任务可靠。 Duet与对应的Claude套餐共享现有的使用限额——Anthropic警告称,定期的后台检查和大量任务可能很快耗尽配额。 个人AI智能体的竞争 Claude Duet进入的是一个竞争日益激烈的市场:谷歌曾在5月发布了个人AI智能体Spark(现为Tasks),OpenAI则通过Dots自2026年9月起提供持续运行的智能体。Meta称其消费级智能体Muse在美国和加拿大拥有超过1000万用户。Manus最近也推出了个人AI智能体Cue,其中每个智能体都拥有自己的电子邮件地址、电话号码、数字钱包和自己的云计算机——这一思路与Anthropic专注于受控职业工作流的做法明显不同。 Anthropic未透露Duet何时在美国以外、尤其是在欧洲推出。要在欧盟使用,围绕目的限定、数据最小化和第三国传输的GDPR要求可能会变得相关——尤其是该智能体可能访问电子邮件、日历、发票、员工数据及其他敏感信息。Anthropic最近刚刚引入了新的使用政策,这些政策很可能也适用于执行操作的智能体。 (rie)

    匹配字段正文

  9. 智东西

    DeepSeek约1000亿元第二轮融资投资方曝光:美团、吉利、网易等在列

    DeepSeek约1000亿元第二轮融资的投资方包括兆易创新、美团、吉利、美的和现有股东网易,投资方总数超过15家,宁德时代和腾讯为最大投资方。本轮融资创下中国AI行业规模最大的融资纪录,融资前DeepSeek估值约740亿美元。DeepSeek已聘请中信证券担任上市顾问,目标明年年初登陆上交所。

    智东西10月23日报道,昨晚,据路透社援引四名知情人士消息称,DeepSeek约1000亿元第二轮融资的投资方包括兆易创新、美团、吉利、美的和现有股东网易。 其中三名知情人士称,其他投资方还包括博裕资本、CPE源峰、君联资本,以及现有股东IDG资本。一名知情人士透露,本轮融资的投资方总数超过15家。 昨天上午,据彭博社报道,DeepSeek在最新一轮融资中已筹集约1000亿元(折合150亿美元),创下中国AI行业规模最大的融资纪录,宁德时代和腾讯位列本轮融资最大的投资方。 昨日,《华尔街日报》的报道也披露了部分投资方,知情人士称,DeepSeek本轮融资的新增投资方包括专注半导体领域的石溪资本、联想控股支持的君联资本以及吉利等。 除了上述投资方,据《华尔街日报》报道,Monolith砺思资本和拾象科技等现有股东,也向DeepSeek追加了投资。在最新一轮融资完成前,DeepSeek的估值约为740亿美元(约合人民币4936亿元)。 部分知情人士称,DeepSeek本轮融资的谈判时间从今年7月一直持续到10月,比近期其他AI公司融资时间更长,期间不断有新投资者加入。 一边在一级市场融资,

    匹配字段正文

  10. Hugging Face

    Hugging Face 上线 Space,可查询模型能否在 AWS Trainium 上运行

    Hugging Face 发布 torch-neuronx model support Space,可按下载量或趋势查看 Hub 上的模型能否在 AWS Trainium 上运行,并给出分片核数、含编译的耗时和峰值显存。目前只测试 Transformers 的文本生成与图文模型,且仅限能放进 4 台 Trainium2 设备(最多 16 核)的模型;每个模型生成 32 个 token 校验,单核时与 CPU 结果比对,分片时由小模型判断英文是否通顺。结果来自公开数据集 aws-neuron/torch-neuronx-model-support,Space 还提供运行脚本和跳过编译的 NEFF 缓存命令。

    pace 会告诉你原因(大多数情况下是未被优先考虑,有时则是确实不兼容)。你还可以选择要查看的 Neuron 编译器(neuronx-cc)和 Transformers 版本。 在撰写本文时,仅测试 Transformers 模型,且我们的选择仅限于文本生成和图文转文本模型。我们计划扩展到 diffusers、sentence transformers 以及其他 transformers 任务。 自行运行 选择一个模型即可查看如何运行它。该 Space 会列出模型测试所用的 Neuron 栈、需要在其上安装的软件包,以及实际运行的 run.py 脚本。该脚本遵循 TorchNeuron 公告中的配方:使用 from pretrained 加载模型,在需要时进行分片,然后使用静态缓存和 torch.compile(backend="neuron") 进行生成。 在配备该栈的 Trainium2(trn2)实例上,例如在 AWS Neuron Deep Learning Container 中,安装软件包,然后运行: 无需 torchrun:当模型分片时,脚本会自行启动 torch.dis

    匹配字段正文