←搜索结果

按匹配度 · 共 2021 条结果 清除搜索

星期三

  1. 事件1 条新闻 · 1 个事实

    Cognition 分享 SWE-1.6 训练早期预览

    2026年3月1日,Cognition 公布 SWE-1.6 的早期预览。该模型与 SWE-1.5 基于同一预训练模型做后训练,推理速度同为 950 tok/s,当前 checkpoint 在 SWE-Bench Pro 上比 SWE-1.5 高 11%。团队称通过改进 RL 配方和扩展基础设施获得两个数量级算力,训练步骤比 3 个月前快 6 倍,并使用低至 NVFP4 的精度和 NVIDIA Multi-Node NVLink 加速。目前该模型向少量用户开放早期访问以收集反馈,团队同时指出大规模 RL 带来了过度思考、过多轮次等影响模型使用体验的行为。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    SGLang在GB300 NVL72上实现最高25倍推理性能提升

    2026年2月20日,SGLang宣布与NVIDIA合作,在InferenceXv2基准上于GB300 NVL72运行DeepSeek R1时,相比H200实现最高25倍推理性能提升,该对比基于50 TPS/user的低延迟场景。据LMSYS Blog介绍,这一提升借助NVFP4 GEMM、计算通信重叠和NVIDIA Dynamo等优化实现。同一来源还提到,SGLang在GB200 NVL72上的性能在不到4个月内提升最高8倍。后续计划推进GB300 NVL72的MTP支持以及Qwen 3.5等模型的调优。目前该事件尚无其他独立发展事实。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    Microsoft AI 发布语音生成模型 MAI-Voice-1

    2025年8月29日,Microsoft AI 发布首个高表现力语音生成模型 MAI-Voice-1。据 Microsoft AI Blog 同日发布的信息,该模型已在 Copilot Daily 和 Podcasts 中上线,并在 Copilot Labs 提供体验;其可在单张 GPU 上不到一秒生成一分钟音频。同一来源还提到,微软 AI 首个端到端训练的基础模型 MAI-1-preview 已在 LMArena 开启公开测试,这是一个在约 15,000 块 NVIDIA H100 GPU 上完成预训练和后训练的 MoE 模型,未来数周将逐步用于 Copilot 的部分文本场景。目前没有后续发展事实,状态停留在发布与公开测试阶段。

    匹配字段摘要

  4. 事件1 条新闻 · 1 个事实

    Zyphra 展示 MI300X 上超越 H100 的反向内核

    2024年12月10日,Zyphra 展示其为 AMD Instinct MI300X 编写并优化的反向内核,称这是首个在 transformers(Flash Attention v2)和混合模型(Mamba2)上超越 NVIDIA H100 的反向内核。据 Zyphra Research 发布的信息,FA2 反向内核在 2k、4k、8k 序列长度上分别比 H100 快 1%、2%、4%,使稠密/MoE Transformer 等注意力模型可在 MI300X 上高效训练并达到高 MFU。目前该事实仅有这一条第一方证据,尚无后续发展事实。

    匹配字段摘要

  5. 事件1 条新闻 · 1 个事实

    Zyphra 发布 5 万亿 token 数据集 Zyda-2

    2024 年 10 月 15 日,Zyphra 发布约 5 万亿 token 的宽松许可数据集 Zyda-2,并已在 HuggingFace 上开放。该数据集由 DCLM、FineWeb-Edu、Zyda-1 和 Dolma v1.7 的 Common Crawl 部分经跨数据集去重与模型过滤组合而成。Zyphra 表示,借助 NVIDIA NeMo Curator 的 GPU 加速,数据处理从 CPU 上的 3 周缩短到 2 天,总拥有成本降低 2 倍。Zyphra 还称,用 Zyda-2 退火训练的模型在 MMLU、Hellaswag 等聚合评测上优于 DCLM 和 FineWeb-Edu,其 Zamba2 系列模型即基于该数据集的早期版本训练。目前尚无后续发展事实。

    匹配字段摘要

  6. 事件1 条新闻 · 1 个事实

    Ollama 在 Windows 上推出预览版

    2024年2月15日,Ollama 在 Windows 上推出预览版,可在原生 Windows 环境中拉取、运行和创建大语言模型。据 Ollama Blog 发布的信息,该版本内置 GPU 加速,支持 NVIDIA GPU 以及 AVX、AVX2 等 CPU 指令集,无需配置或虚拟化;同时提供完整模型库(含 LLaVA 1.6 等视觉模型,图片可拖入 ollama run)和后台运行的 Ollama API(http://localhost:11434),并保持与其他平台一致的 OpenAI 兼容性。目前尚无后续发展事实。

    匹配字段摘要

  7. 事件1 条新闻 · 1 个事实

    Ollama 成为 Docker 官方赞助开源镜像

    2023年10月5日,Ollama 成为 Docker 官方赞助的开源镜像,用户可在 Docker 容器中运行大语言模型,所有交互在本地完成,不向第三方服务发送私有数据。据 Ollama Blog 当日发布的信息,在 Linux 上,Ollama 可在容器内借助 Nvidia GPU 加速运行,需先安装 Nvidia container toolkit;在 Mac 上则需以独立应用方式运行,因为 Docker Desktop 不支持 GPU。容器内可直接运行 Llama 2 等模型,更多模型见 Ollama library。目前没有后续发展事实。

    匹配字段摘要

星期一

  1. 事件1 条新闻 · 1 个事实

    goose 公布资助项目 Goose In A Pond

    2026年2月24日,goose 公布其 10 万美元资助计划的获奖项目 Goose In A Pond。据 goose 官方博客介绍,该项目由肯尼亚内罗毕五人团队 Jarida 基于 goose 开源智能体框架打造,部署在 NVIDIA Jetson Orin Nano 上,可本地运行 1–7B 量化模型,速度达 40–70 tokens/秒。项目使用 Whisper、Vosk、Coqui TTS 实现离线语音,并计划开源 Moonbeam 等 MCP 服务器。目前尚无后续发展事实,状态停留在公布阶段。

    匹配字段摘要

星期日

  1. 事件1 条新闻 · 1 个事实

    Prime Intellect发布INTELLECT-3模型

    2025年11月26日,Prime Intellect发布INTELLECT-3模型。该模型为106B参数的Mixture-of-Experts架构,在GLM-4.5-Air基座上进行SFT和大规模RL训练,在数学、代码、科学和推理基准上取得同规模SOTA。团队开源了模型权重、训练框架prime-rl、verifiers环境库及全部训练与评测环境,训练在512张NVIDIA H200 GPU上完成。模型可在chat.primeintellect.ai或通过Inference API使用。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    Suno完成2.5亿美元C轮融资

    2025年11月19日,Suno宣布完成2.5亿美元C轮融资,投后估值24.5亿美元。本轮由Menlo Ventures领投,NVentures(NVIDIA旗下风投)、Hallwood Media、Lightspeed和Matrix参投。Suno称过去两年有近1亿人在其平台上创作音乐,资金将用于为专业用户提供更复杂的工具、优化普通创作者的体验,并建设创作者、听众与音乐社区共同参与的生态。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    vLLM新增支持Nemotron模型家族

    2025年10月23日,vLLM宣布支持部署NVIDIA Nemotron开放模型家族,使其可在数据中心及端侧硬件上运行智能体推理。其中,Nemotron Nano 2采用混合Transformer–Mamba架构,并提供可配置的thinking budget,开发者可据此调节精度、吞吐量和成本。相关模型权重及超过9万亿tokens的训练数据已在Hugging Face提供。

    匹配字段摘要

  4. 事件1 条新闻 · 1 个事实

    vLLM支持部署gpt-oss

    2025年8月5日,vLLM宣布新增对gpt-oss模型的支持,可在NVIDIA Blackwell、Hopper以及AMD MI300x、MI355x GPU上运行。为适配模型,其集成了面向MXFP4混合专家架构、高效注意力和混合KV缓存的专用内核与内存管理方案,并支持通过OpenAI Responses API、gpt-oss toolkit或外部MCP工具服务器进行工具调用。

    匹配字段摘要

  5. 事件1 条新闻 · 1 个事实

    Cartesia发布Llamba模型系列

    2025年3月5日,Cartesia发布Llamba-1B、3B、8B模型权重。该系列采用MOHAWK架构蒸馏方法,将Llama-3.X转换为Mamba-2架构,训练数据量比从头预训练少1000倍。Llamba-8B在NVIDIA H100上生成8192 tokens时吞吐量比Llama-3.1-8B高12倍,并已针对Apple Silicon和MLX框架优化。

    匹配字段摘要

  6. 事件1 条新闻 · 1 个事实

    vLLM V1架构升级进入Alpha

    2025年1月27日,vLLM发布V1核心架构升级Alpha版,重构调度器、KV cache管理器、Worker、采样器和API服务器,吞吐量较V0最高提升至1.7倍。V1默认启用低开销前缀缓存,并增强多模态模型支持;用户可设置VLLM_USE_V1=1,在不修改现有API的情况下启用。目前该版本仅支持Ampere或更新的NVIDIA GPU,尚不支持LoRA、结构化解码、推测解码和流水线并行等功能。

    2025年1月27日,vLLM发布V1核心架构升级Alpha版,重构调度器、KV cache管理器、Worker、采样器和API服务器,吞吐量较V0最高提升至1.7倍。V1默认启用低开销前缀缓存,并增强多模态模型支持;用户可设置VLLM USE V1=1,在不修改现有API的情况下启用。目前该版本仅支持Ampere或更新的NVIDIA GPU,尚不支持LoRA、结构化解码、推测解码和流水线并行等功能。

    匹配字段摘要

星期五

星期四

星期四

星期一

  1. LMSYS Blog

    LMSYS 详解 HiCache 如何适配多并行与分布式推理

    LMSYS 博客介绍 HiCache 在上下文并行、流水线并行、投机解码、统一 KV 布局和 P/D 分离场景下的实现方式,核心是让各 rank 在缓存决策上保持一致。讯飞星辰 MaaS 团队用 HiCache 加外部存储服务 GLM-5.1/5.2 CodingPlan 负载,缓存命中率从约 30% 提升到 95%,中位 TTFT 降到 3 秒以内。CP 分片实测中 GPU token 命中率提升 40.48 个百分点,host 内存服务 token 量下降 81.2%,prefill 平均排队时间降低 56.2%。

    A logical radix tree shared by two CP ranks: logical page IDs map to rank 0 or rank 1 by q mod 2, and extending the A/B/C prefix allocates page D on rank 1.

    能评估使用 GLM-5.2-NVFP4。 使用生产流量的性能比较 我们将开源的 CP 分片 HiCache 实现与一个基线进行了比较,该基线在 GPU 上复制 KV,并在主机内存中对 MLA KV 去重。两个部署均使用 GLM-5.2-NVFP4、TP4/CP4、EAGLE MTP,以及 0.9 的静态内存比例。每个部署有两个预填充引擎,每个引擎运行在四块 NVIDIA GB300 GPU 上。 每个部署的目标主机缓存预算为每引擎 960 GB:基线中是一个去重池,而四个分片 rank 中每个 rank 为 240 GB。在三小时的流量窗口内,每种配置处理了约 24.5K 个具有已知缓存层级归属的请求。平均输入长度为 136K–137K token,总输入量相差 1.8%。 图 1d。 采用 CP 分片后,更多缓存 token 由 GPU 内存提供,更少由主机内存提供;合计命中率保持在 93% 附近。对于同一请求,预填充阶段 TTFT 是排队时间加前向时间。图中均值使用不同的请求群体,不应相加为实测 TTFT。 采用 CP 分片后,GPU token 命中率提高了 40.48 个百分点

    匹配字段正文

星期二

  1. AWS Machine Learning精选

    在 Amazon SageMaker AI 上用知识蒸馏构建高效智能体

    AWS 官方博客介绍如何用序列级知识蒸馏(SeqKD)在 Amazon SageMaker AI 上微调购物智能体:以 Amazon Bedrock 上的 GLM-5.3 作为教师模型生成轨迹,用 ShoppingBench 评分器只保留解出任务的轨迹,再对 Qwen3.5-4B 学生模型做服务端无服务器 SFT。在 324 道留出测试题上,蒸馏后 4B 学生平均绝对成功率从 0.297 提升到 0.541,与教师模型和中等规模前沿模型基本持平;去掉教师推理过程只学工具调用时,平均成功率降至 0.415。

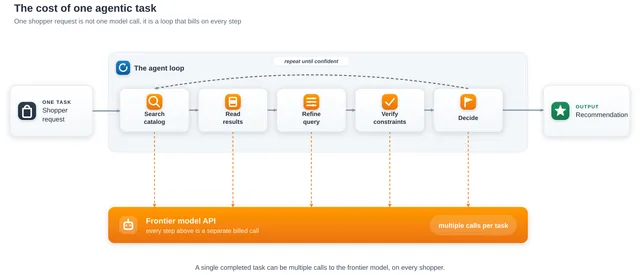
    Diagram of an agentic task as a loop: search, read results, refine, verify, and decide, with each step a separate billed call to the frontier model

    通用指令遵循上的表现,分别按提示严格和指令严格指标衡量。小幅下降是在购物任务上专业化所预期的代价 收益与权衡 单看成功率本身并不足以证明切换的合理性。进行蒸馏的理由在于,你能以较小模型的成本和速度获得较强模型的大部分质量。这里最清晰的证据是,4B 学生模型达到了其前沿教师模型和一个中等规模前沿模型的任务质量,同时其规模小到足以在单个 G 系列实例(本例中为 NVIDIA A10G/L40/L40S)上提供服务。 成本差异既与规模有关,也与形态有关。通过 API 访问的前沿模型按 token 计费,在每项任务的每个步骤上都要计费,因此成本随使用量增长而不会停止,引言中提到的智能体循环每次都要支付这笔费用。蒸馏出的学生模型运行在你自行托管的端点上,该端点按小时对实例计费,无论它服务一项任务还是数千项任务,因此在横向扩展之前,增加的流量不会带来额外成本。你是在用按请求计费的变动成本换取按小时计费的固定成本,而你能采用的最小模型越小,这项固定成本就越低。 我们在此不公布每项任务的成本或延迟数字,因为这取决于你的流量:G 系列实例所能维持的吞吐量,以及由此摊到每项任务上的成本,都是你的请求模式、

    匹配字段正文

星期五

  1. Latent Space

    Latent Space 公布 AIE CODE 编码智能体大会策展主题

    Latent Space 主理人 swyx 介绍年度旗舰大会 AIE CODE 的策展思路,会议为单轨、邀请制,面向约 1000 名智能体工程师。今年三大主题为 Scaling without Slop、System One 模型和 Increasing Ambition,其中 Jarred Sumner 将分享 Bun 用 Rust 重写及 Bun AOT 预览。文章同时汇总了 Mistral 开源权重发布、OpenAI 前沿模型监控等当日 AI 新闻。

    集群可靠性:SkyPilot 报告称,一个 128 机架的 NVL72 集群大约每 5 小时就会丢失一个节点。运行 16 节点作业、每个机架配备 2 个机架内备用节点,可获得 2,037 个可用节点,而非 1,602 个,容量约增加 27%(@skypilot org)。 硬件与供应: Vera Rubin NVLink:由于 SerDes 信号完整性限制,NVIDIA 将每 GPU 的 NVLink 带宽从 3.6 TB/s 削减至 3.0 TB/s(SemiAnalysis)。 芯片算力增长:Epoch 估计,自 2024 年以来,AI 芯片算力的季度销售额每年增长 2.5 倍,低于 2023 年的约 6 倍(Epoch)。 内核、压缩与路由: Prime Mega MoE:使 DeepSeek 的 Mega MoE 内核可训练,速度比 TorchTitan 最高快 55%(Prime Intellect)。 NyoomFloat12:一种对 BF16 权重的无损 12 位压缩,已被 NeurIPS 接收(@realDanFu)。 OpenRouter 路由器:新的质量加权路由器显

    匹配字段正文